前沿 RL 论文阅读
一些前沿(after 2025)的 RL 论文阅读, 纯粹个人偏见, 拒绝客观分析, 滑香蕉皮式写作, 捉摸不定更新
2026/10/24 更新 R2-Dreamer
R2-Dreamer
默认读者拥有 Model-based RL 与 Dreamer 系列文章的基础
R2-Dreamer —— ICLR 2026
Poster
知乎分析 /
翻译
随着时代的发展, Model-based RL 的 RL 问题已经大部分被解决, 而 Model 问题还仍然存在
总的来说, Model
的目标是现实环境的简化表征(representation),
我们可以用监督学习来得到这种表征, 但它是最优的吗?
什么是最优表征?对于 Model 而言, 关心我们想要关心的世界动态与交互, 忽略背景(background)与 task-irrelevent 的东西, 这和纯粹的监督学习目标可能有较大偏差
近年来最成功的方法就是 Dreamer
V3, 原来它发了 Nature, 怪不得这么多 follow work
Dreamer-like 的文章通过优化像素级重建目标来学习表征, 以
DreamerV3 为例, 原始图像为 \(x\),
之前的 Seq Model 隐状态为 \(h\),
先学表征 Model \(z \sim
q_\phi(z|h,x)\), 再学 Decoder \(\hat x
\sim p_\phi(\hat x|h,z)\), 然后做类似 ELBO 的东西来优化重建,
也可以说这种方法是 Decoder-based 的。
这种做法会在什么任务上折戟?在一些 small but task-critical objects
存在的任务上会失败

这是 Atari 100k benchmark 中的 Venture 游戏, 人物是那个 1x1 pixel
的小点, 有四个开口的房间需要你探索, 进入其中会转变地图
有很多因素在阻碍 Dreamer 架构对我们人物的关心, 例如误差重建中会产生
\(\| x - \hat x \|^2\) 这样的项, 读入的
CNN 会缩放和下采样, KL 正则化会取舍预测, 预测背景多么简单,
它不会动又足够明显, 相反, 在按下移动键后像素点飞速移动怎么能看见呢?
当然这个例子有点极端, 我倾向于当模型已经吃完重建背景的 easy-lunch 后会去关心一下移动键到底造成了什么影响, 不过在这里 CNN 的下采样可能都是致命的

Venture 的测试得分, 六列分别为 Random, Gamer, Human Record, PPO, MuZero, Dreamer 的得分, 在这里是 PPO 最优
因此, 虽然 pixel-reconstruction 很自然并且常见,
但我们有时候需要抛弃它, 抛弃这自然的监督方法
为了训练 Model, 我们需要自监督学习(Self-Supervised Learning,
SSL)方法了, 要构建某种 self-supervised losses
在这里需要引入 数据增强(Data Augmentation, DA) 技术,
也引出了表征崩溃(representation collapse)的问题
数据增强的思想是这样的, 例如我们希望 Model 不要学习什么
"背景颜色对运动的影响", 于是我们在输入做颜色抖动(color
jittering),
并且强制颜色抖动前后模型学习的表征是一样的。我们 "增强"
什么其实是希望模型 "不去学习" 某些东西
这个方法有两个问题,
一是 Ad-hoc, 如果我们做一个红灯停绿灯行的 Model, 显然不能 color
jittering; 如果我们的问题也有 small but task-critical objects,
那就(可能)不能做 random shifting, etc.
更大的问题在于表征崩溃, 所有 DA 方法处于一种 "既要又要" 的状态,
而对于模型最好的摆烂方法就是——对所有输入都输出同样的向量
在两类方法之外, 更多的修修补补来源于辅助目标(auxiliary objectives) / 辅助输入, 可以预测奖励, 可以额外预测 "事件"(画面的大幅改变)From Observations to Events, ICLR 2026, 可以加入一个冻结的视觉分割模型并通过 few-shot 标注给后续 model 输入直接把主角 mask 给出来OC-STORM, ICLR 2026
讲到这里, 我们还没有说文章想做什么, 简单来说是 DA-free 的内部正则化
我们可以说 R2-Dreamer 是把 DreamerV3 与 Barlow Twins 做了个 A+B, 也可以说它 "开创了 Decoder-free + DA-free 的 Model-based RL 范式, 伟大之作, Openreview 8 8 4 4 实至名归"
所以 Barlow Twins 是什么?
Barlow Twins 是篇 SSL 领域文章, 被引量 4000+
之前的 SSL 文章是如何避免坍塌的?负样本、不对称结构、stop-gradient、etc.
本文在数学上更加本质, 首先, SSL 的核心, 让同一张图像的两种增强视图产生一致的特征, 要保留然后, 重新审视, 坍塌是什么? 一种常见的坍塌, 就是很多特征维度实际上只剩下同一个信号, 维度的相关系数接近 1, 对于图像的两种视图, 计算相关性矩阵, 对非对角元素(不同的特征)施加平方惩罚, 例如 \(\mathcal L_{\mathrm{redundancy}} =\lambda\sum_{i\ne j}C_{ij}^{2}\), 其中 \(C_{ij} =\dfrac{\operatorname{Cov}(a_i,b_j)} {\sigma_{a_i}\sigma_{b_j}} \in[-1,1]\) 就可以防止特征维度的直接复制、放大复制、反号复制
对于相关性矩阵的对角元素(两视图对应的特征), 我们要求其相关性接近 1, 于是 \(\mathcal L_{\mathrm{invariance}}=\sum_i(1-C_{ii})^2\)
往深了扯, 这叫做去冗余, "神经科学家 Horace Barlow 提出, 感官输入包含大量冗余, balabala"
往浅了讲, 这是不是类似白化操作加上一个对齐?

Barlow Twin 的做法是对一个包含 \(N\) 张图像的 batch, 每张图像分别做两次随机增强,例如裁剪、颜色扰动、模糊, 得到两种视图, \(x_b \longrightarrow \begin{cases} y_b^A=t_A(x_b)\\ y_b^B=t_B(x_b) \end{cases}\), 然后经过共享参数的编码器和投影器 \(z_b^A=g_\theta(f_\theta(y_b^A)),\; z_b^B=g_\theta(f_\theta(y_b^B))\), 在两个(Twin) \(z\) 上算 \(\mathcal L_{\text{BT}} = \mathcal L_{\mathrm{redundancy}} + \mathcal L_{\mathrm{invariance}}\)
在 R2-Dreamer 的语境下呢? 我们不是说好 DA-free 了吗?

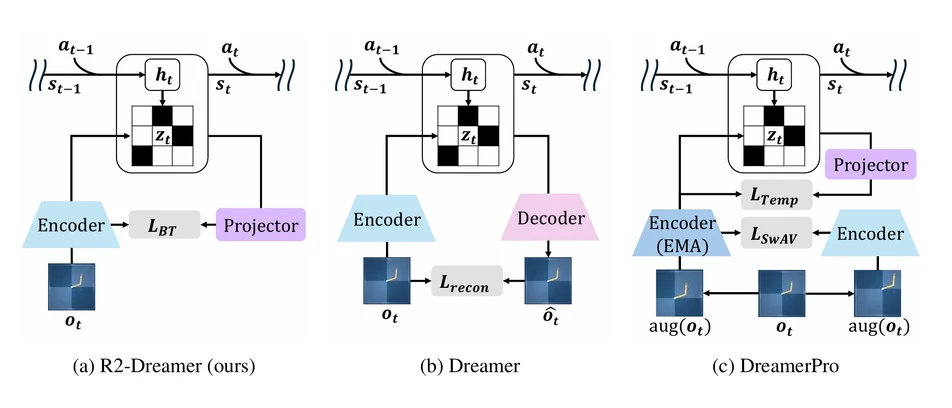
我们看看 图像/观察 是怎么在网络里处理流动的

\(\boldsymbol o\) 是原始的图像观测,
\(\boldsymbol e\) 是图像的特征,
已经是一种表征了, 我们做网络 \(e =
f_\phi(o)\) 得到
而 \(\boldsymbol z\)
才是世界模型的潜状态, 它包含了历史信息 \(h\), 有网络 \(z =
q_\phi(z|h,e)\), 内含了 Dynamic
如果是 Dreamer, 我们要返回直到 \(\hat {\boldsymbol o}\) 为止, 但这是 R2-Dreamer, 我们返回 \(k\) 做 Barlow Twin 就行了, 这里的 \(\boldsymbol s = (\boldsymbol h, \boldsymbol z)\), 然后 Projector 比 Decoder 轻量多了, 只是一层不带 bias 的 MLP, \(k = f_\phi(s)\)
对于 Loss, 作者专门把 DreamerV3 的 Reconstruction Loss 摘了出来, 换成 Barlow Twin Loss 就行了

对于后面 RL 的 Actor-Critic 部分, 相较于 DreamerV3 没看到任何改动
实验通常是 RL 不得不品的一环, 在这里不知道能烧掉多少 GPU Hour, 我们对比的主要模型为
DreamerV3
Dreamer-InfoNCE(用来测试在不用图像重建时, 对比学习是否足以替代冗余减少目标)
InfoNCE 用于对比学习, 使用负样本迫使模型必须将不同样本的表征推开, 从而维持表征的多样性DreamerPro(感觉像是 DreamerV3 + DA)
同样不重建图像, 但使用随机图像平移等 DA, 有两个 EncoderDrQ-v2(model-free Actor–Critic baseline)
这文章本来就在我的 read list 上, 我们 divert 一下来讲这篇文章
我个人认为, model-free 与 DA 更为适宜, 如果本来 model-based 就是为了减少采样, 再加入 DA 会不会导致某种误差的累计?当然也可以说 model-based RL + DA 是极致 sample-efficient 的
DrQ-v2 是 DrQ 的 robust 版本, DA 方法包括- 随机平移 + 双线性插值(我上次看到这个还是做 Rol Align……)
- 对下一状态的多个增强版本计算 target, 再取平均, \(y=r+\gamma\frac1K\sum_{k=1}^{K} Q_{\bar\theta}\big(f(s',\nu'_k),a'_k\big)\)
- 让当前状态的多个增强版本拟合同一个 target, \(\mathcal L_Q= \frac1M\sum_{m=1}^{M} \left[Q_\theta(f(s,\nu_m),a)-y\right]^2\)
无模型的 DrQ-v2 在采样效率上可以与基于模型的 Dreamer-v2, 收敛速度大幅领先啊
DrQ 好像很简单, 它只是把 random shift 在 RL 上用到了极致, 然后调参调到完美TD-MPC2, ICLR 2024: 学习潜在动力学, 再在线规划动作
这篇文章有很多 DreamerV3 的 Trick, see 知乎分析MPC 大概都类似这样:
在推理阶段, 对于当前的状态 \(s\), 在 Dynamic model 上使用 policy 先验地 rollout 多条轨迹, 再随机采样 action 来 rollout 多条轨迹, 使用 Reward 和 Q function 进行判别评估, 选取最好的 top k 条轨迹进行 CEM 优化, 经过多轮迭代最终找到一条表现最好的轨迹, 将轨迹的第一个 action 提取出来在环境中执行我感觉应该单独分析一下这篇文章, idea 和 engineering 都很好, 我只是想起了自己训 MPC 的悲伤回忆, 决策太慢了
在 Meta-World, DMC, DMC-subtle(DMC 中的任务关键对象被缩小) benchmark 上测试

R2-Dreamer 当然是最优的, 这里的最优性在 DMC-Subtle 上最明显
R2-Dreamer 的显著性图清晰地聚焦于目标,
表明其策略建立在任务关键的视觉证据之上

在消融实验中, R2-Dreamer 在加上 DA 后仅有小幅边际提升, 而在 DMC-subtle 上用 DA 会导致性能下降, 证明确实其是 DA-free 的, 而 DreamerPro 没了 DA 就崩塌了

同时, R2-Dreamer 更快, 速度是 DreamerV3 的 1.59x
Future Work 是 Dynamic + Irrelevant Background, 以及 Scaling to high-dimensional tasks
总体来讲我挺喜欢这篇文章, OpenReview 上的主要问题是没有 TD-MPC2 比较(后面加上了), DMC-subtle 的实验把文章方法的优势完全体现出来了, 传统的 benchmark 进步不算多
Appendix A 把 Loss 的设计解释为互信息的光荣传统,
是一些高级的没用公式, 噢, Barlow Twins
原论文也有这一部分在算互信息
Appendix BCDE 放的 Detailed Result, 不看
Appendix F 是超参, 以后抄
Appendix G 是 representation loss 的 pseudo code, 以后一起抄
我们看一下代码, 包括之前欠的 Dreamer 的 engineering 部分, 代码很简练, 而且还有点注释
论文有点不对劲, 没讲不同 Experiments 的 Model Size, 我看 DreamerV3
训个 Atari100K 都要上 200M size 的 Model, 但代码库默认用的 12M size
模型
一个复现的起点是用 12M para 的来训 DMC_walker 来验证论文声称的 4.4 RTX
3080 Ti GPU hour,
但我没卡, 先看代码, 12M para model 的大头就是 RSSM
1 | Encoder CNN shapes: {'image': (64, 64, 3)} |
RSSM 架构从 PlaNet 用到了 DreamerV3, 然后随着 Dreamer-like 文章的发展弄得到处都是

其示意图只出现在 PlaNet 中, 其中符号与 R2-Dreamer 不同, 我们的符号如下
| 数学符号 | 代码名 | 作用 | 默认单步形状(12M Para 下) |
|---|---|---|---|
| \(h_t\) | deter |
递归记忆, 保存历史信息 | [B, 2048] |
| \(z_t\) | stoch |
根据当前信息采样的离散潜状态 | [B, 32, 16] |
| \(e_t\) | embed |
当前观测的编码特征 | [B, E] |
其中还有大状态 \(s_t = (h_t, z_t)\), 这部分对应
1 | def get_feat(self, stoch, deter): |
class Deter(nn.Module): 用来更新 \(h_t = f_\phi(z_{t-1}, h_{t-1}, a_{t-1})\),
对应 forward 方法
一个有趣的细节在于块大小 \(G=8\),
BlockLinear
通过去除块间更新来大幅减少参数, 不然 Linear 层太大了,
可以用 \(N_{\mathrm{hid}} =G\left(\frac
DG+3U\right)\frac DG\) 来算, 这里 \(U=256\) 是 \(z,h,a\) 的投影宽度, \(D = 2048\)
块对角线性层: 权重矩阵的非对角线区域全为 0, 只有对角线上的多个小矩阵块有参数
GRU 作为这里的 RNN 架构, 回忆一下

于是有整体 forward 代码
1 | def forward(self, stoch, deter, action): |
这个代码得到了新的 \(h_t = f_\phi(z_{t-1}, h_{t-1}, a_{t-1})\)
然后后面的 class RSSM 要用刚得出来的 \(h_t\) 去算 \(z_t,
\hat z_t\) 了, self._deter_net = Deter(...)
加载上面架构
这个 \(z\) 是 categorical 的, 在 12M
para 模型下是 \(z_t\in\{0,1\}^{32\times
16}\) 的, 每一行是一个分类变量的 one-hot 结果
后验 \(z_t \sim q_\phi(z_t | h_t,
e_t)\) 对应 self._obs_net, [Linear → RMSNorm → SiLU]
× obs_layers 后接 linear + reshape
先验 \(\hat z_t \sim p_\phi(\hat
z_t|h_t)\) 对应 self._img_net, [Linear → RMSNorm →
SiLU] × img_layers 后接 linear + reshape
对于单个(后验)时间步, 有
1 | def obs_step(self, stoch, deter, prev_action, embed, reset): |
这里的 straight-through Gumbel-Softmax 技巧解决了 argmax 采样不可导问题, 就是把 argmax 变成 softmax 了, 类似于
1 | sample = one_hot(draw(logits)) # sample has no gradient |
单个先验时间步不用清零, 直接
logit = self._img_net(deter), 然后用上文技巧就行
observe(): 把后验时间步 stack 掉,
沿真实观测序列执行后验推断, 得到 stochs(B, T, S, K), deters(B, T, D),
logits(B, T, S, K)
最后算先验后验的 KL loss, 即 \(\mathcal L_{\rm dyn}(t)\) 和 \(\mathcal L_{\rm rep}(t)\), 一个小细节是混入了 0.01 的均匀分布防止概率极端, 因为 KL 散度是相对的, 为 0 不够稳定
1 | def kl_loss(self, post_logit, prior_logit, free): |
然后读核心的 dreamer.py 代码, 我看 __init__
都要老半天, 组件太多了, 把 dreamerV3 / r2dreamer / dreamer-infoNCE /
dreamerpro 都缝进来了, 我们只关心 R2-Dreamer
加入 encoder \(e_t = f_\phi(o_t)\),
这东西在 DreamerV3 中没有, 纯粹是为了 BT loss 出现的
encoder 的配置要适配所有的环境, 图像字段要配 CNN, 数值段要配 MLP,
在具体的 env 里也会配置 encoder keys 来规定任务字段,
例如默认 dmc_vision 配置如下, 说明只有 image
1 | encoder: |
对于 CNN, 都是四层的, 每层做 2x2 的 MaxPool 来减半, 不同的 Model Size
的 Channel 数量不一样, 12M Para 最后是 64x4x4 的特征 flatten 为
1024
对于 MLP 会过三层后输出 256 维的向量, 最终的 Embed
会沿着最后一维拼接(如果既有 CNN 又有 MLP)
得到的 shape 会传给 RSSM
1 | shapes = {k: tuple(v.shape) for k, v in obs_space.spaces.items()} |
加入 reward predictor \(\hat r_t \sim p_\phi(\hat r_t | s_t)\) 和 continue predictor \(\hat c_t \sim p_\phi(\hat c_t | s_t)\)
1 | self.reward = networks.MLPHead(config.reward, self.rssm.feat_size) |
这里的 networks.MLPHead 调配网络类型, 大家的分布是不同的, reward 是
symexp_twohot, 而 cont 就是个 binary 的 done
啊, 这两个小网络只有一层隐藏层和一层输出层
加入 actor-critic, actor 的梯度估计用 REINFORCE 方式进行
actor 支持 多离散动作/离散动作/连续动作, actor-critic 的诸多参数全藏在
model/_base_.yaml 里面了, 总体都是三层隐藏层加上一层输出层,
第一层是 \(s=(h,z) (2560)\to 256\),
中间是 \(256 \to 256\), 最后一层对于
Actor 是 \(256 \to 2A\), 这 \(2A\) 是 \(A\) 维独立高斯的参数, 具体还要
bounded;
对于 critic, 最后一层是 255 个价值分布 logits, 然后 logits 转不同 reward
概率, 最后加权平均得到 \(V(s)\)
然后有那些传统的 polyak 平均的 target network
1 | self.slow_target_update = int(config.slow_target_update) # 1 |
对于 R2-Dreamer, 会多一个 projector 和 barlow twin loss, projector 真的连 bias 都没有噢
1 | self.prj = Projector(self.rssm.feat_size, self.embed_size) |
最终有七大网络, 按照默认的 12M para + dmc_vision, 其 shape 为
1 | modules = { |
说怪不得 projector 只是一层 MLP 呢, 竟然有 2560x1024
这么贵吗?想象一下, 算 Barlow Twins 的那个相关矩阵是 1024x1024 的,
我算一次就是 \(O(1024^3) \approx
1.07B\)
我翻了翻, Barlow Twins 原文在 ImageNet 上测了 projector size 与 accuracy
的关系, 大体遵从 \({\rm acc} = k \log \rm size
+ b\), 不过 Barlow Twins 原文有大量 DA 啊,
这个超参可能挺重要的
然后是一些收集需要优化的参数, AGC 梯度裁剪, LaProp 优化器配置, lr warmup 的细节, 见论文 Appendix F
基于训练更快的目的的工程, 例如 autocast, 就不讲了,
class Dreamer() 重要的方法还有 _act(),
update(), _cal_grad(),
_imagine(), _lambda_return(),
clone_and_freeze() 一堆没有说, 一个一个来
_act() 根据当前观测和上一步保留的内部状态, 选择当前动作,
并生成下一步要用的内部状态
1 | def _act(self, obs, state, eval=False): |
_act() 只负责使用当前模型选择动作, 不更新参数, 这里的
encoder, rssm, actor 都是 frozen 的
update() 方法从 replay buffer 中取出一批数据,
完成一次训练更新
replay buffer 内含 image/reward/bool_label/action/stoch/deter/episode,
这部分细节也很多, 忽略之
update() 的很大一部分是监控与保证梯度不会因为 autocast
或什么而炸成 nan/inf, 另外有一大部分是记录参数给 tensorboard
看(metrics.update(mets)), 核心只有几行
1 | (stoch, deter), mets = self._cal_grad(p_data, initial) |
_cal_grad() 方法一共干四件事, 是写进注释里的
世界模型损失(动态 + 表征)
可选的表征损失变体(Dreamer、R2-Dreamer、InfoNCE、DreamerPro)
用于 Actor-Critic 更新的 Imagination 扩展
基于回放的价值学习
输入只有 data, 即 observation \(o_t\), 以 R2Dreamer 为例,
有 \(o \to e \to z, h, {\rm
post\_logit}\), 也有 \(h \to {\rm
prior\_logit} \to \mathcal L_{\rm dyn}, \mathcal L_{\rm rep}\),
也有 \(s=(z,h)\), 也有 \(\mathcal L_{\rm BT} = \dots\), 也有 \(s \to r, c\), 最后还有 actor-critic 的
imagined rollout 部分, log 部分, 以及 Replay-based value learning 部分,
额, 拿符号不好总结了
先是 World Model 部分的所有 loss 计算
1 | def _cal_grad(self, data, initial): |
x2 的 .detach() 是为了防止改变 embedding,
虽然 loss 可以从 barlow loss → x1 → projector → RSSM → embed → encoder
这条路传过去, \(\mathcal L_{\mathrm{barlow}} =
\sum_i(C_{ii}-1)^2 +\lambda_{\mathrm{BT}}\sum_{i\ne
j}C_{ij}^2\)
对角线有 E 项, 非对角线有 E(E-1) 项,
所以还要用较小的 lambd 平衡两项, 默认为
5e-4
接下来有 actor-critic 的 imagined rollout 训练, 有 \(M=BT\) 个真实起点, 每个展开 15 步, 所谓
"真实起点", 也就是某些 \((h_t, z_t)\),
从真实的 rollout 中 .detach() 采出来, 接一个 short imagined
rollout, 这是不是一种 Dyna-style?
1 | # 负责想象, 不负责训练 |
见原论文 3.3 部分

这里的衰减 \(\gamma = 1- \frac{1}{\rm
horizon}\), 最终会乘以 0/1 的 done 来, 额, 额外把 done 的活完成
然后 critic 学 λ-return, 通过 self._lambda_return
从后往前卷过来, \(R_t = r_{t} +\gamma c_{t}
\left[(1-\lambda)V_{t+1}+\lambda R_{t+1}\right]\), 其中 \(c\) 是预测继续概率, 没有纯粹用 \(V\),
因为后续想象轨迹的奖励修正估计可能更准一点?默认 \(\lambda = 0.95\)
actor/policy 的策略梯度加了一点熵, \(\mathcal L_{\pi} = -\mathbb{E} \left[ w_t\left(
\log\pi_\theta(a_t\mid f_t)\operatorname{sg}(A_t) +\eta\mathcal
H(\pi_\theta(\cdot\mid f_t)) \right) \right]\)
value 的 loss 还要向 target network 靠拢, \(\mathcal L_V = \mathbb{E} \left[ w_t\left( -\log
p_\phi(G_t\mid f_t) -\log p_\phi(V_{\mathrm{slow},t}\mid f_t) \right)
\right]\)
一些细节是 step 末尾加 0 去 0 以匹配价值分布形状 / 给 imagined 的最后一步补上未来
真实的 replay step 可以在训练 Critic 外训练 RSSM 与 encoder, 对于每个真实 step 有真实的 reward, done/last
1 | def _cal_grad(self, data, initial): |
此时 \(R_t^{\mathrm{replay}} = r_{t}^{\mathrm{real}} +\gamma(1-\mathrm{term}_{t}) \left[ (1-c_{t+1})\,\mathrm{boot}_{t+1} +c_{t+1}R_{t+1}^{\mathrm{replay}} \right]\), 这里的 \(\rm boot\) 是 \(V\) 和 0 的 "混合物"
每次 _cal_grad() 都会执行一次 imagined rollout
部分和一次 replay value learning 部分, 两者的损失最后一起汇总, 统一
backward(), 但是训练样本量不是 1:1 的, 大概是 15:1 左右,
训练范围也不同
clone_and_freeze()
方法创建模型与原网络共享参数数据的副本, 因为是共享与冻结,
不用实时同步
与 .detach() 的区别是可以对上游网络求梯度
gpt 告诉我, 这里的 freeze 大多可以用原网络配合 no_grad()
替代……
剩下部分在每篇 RL 论文可能都有, 例如 trainer.py 和 buffer.py, 就不读了