
CS285 笔记
我想着为什么不试一下呢?这门课的笔记风格会更为随意, 因为大概学不完, 如果你能看见这段话, 说明运气很好啊, 我竟然学完了, 没有被科研、社团活动、校内课程、竞赛、游戏、懒惰、自我否定所打败, 这件事情其实比课程更让我欣喜。
之前学过的课程上提及了强化学习, 现在回忆其与监督学习的区别有四点
如果把 state 换为 data, action 换为 prediction, reward 换为 loss, 强化学习和监督学习到底有什么区别?智能体和环境的交互不就正如模型和数据集的交互吗?
完全不一样, 第一个原因是随机性(stochasticity), 状态和奖励可能是不完整的, 环境在时间步之间的变化也是非确定性的, 我们在 t 和 t+1 时间步上基于同样的状态做出同样的操作, 可能得到不同的奖励
第二个原因是信用分配(credit assignment), 奖励 \(r_t\) 并不完全依赖于操作 \(a_t\), 而是一系列操作的最终结果。当代理人收到奖励时, 它不知道奖励的来源, 信用分配即指在复杂学习系统中, 如何分配系统内部成员对结果的贡献, 而在监督学习中我们的 loss 直接来源于当时的 prediction
第三个原因是不可微分性(nondifferentiable), 一切都是不可微分的, 我们不是在学习函数
第四个原因是非平稳性(nonstationary), 状态 \(\mathbf s_{t+1}\) 依赖于动作 \(\mathbf a_t\), 状态数据的分布是可以随着时间改变的, 我们不可能把分布采样出来, 这类似于 GAN 中的判别器 \(D\), 而监督学习一般使用静态数据集, 学习的是平稳分布
已经一年过去了, 我已经看不懂那些式子, 但现在(2026.3)又要用, 只能重新学了
目前我认为最优秀的一份笔记来自 贪玩电池 -
知乎, 这位的详细程度是我的多倍, 字数垒起来估计都能出书了
个人认为, 南大俞扬老师的 强化学习导论
也是很好的学习资料, 下文有部分参考
Lecture 1 介绍
Instead of trying to produce a program to simulate the adult mind, why not rather try to produce one which simulates the child's? If this were then subjected to an appropriate course of education one would obtain the adult brain.
-- Alan Turing
在图像生成与 LLM 上一个有用的经验是估计密度 \(p_\theta(\mathbf x)\) 或 \(p_\theta(\mathbf y | \mathbf x)\)
经典领域的强化学习(Agent + Environment)与进化算法、控制学、优化理论一起构成了今天的 Deep RL
本门课程的大纲如下
- 监督方法(supervised learning)到决策方法(decision making)
- 无模型强化算法: Q-learning, 策略梯度(policy gradient), actor-critic
- 基于模型的算法: 规划, 最优控制, 序列模型, 图像, etc.
- 一些探索
- 离线强化学习方法
- 逆强化学习
- 高级主题探讨: 元学习, 迁移学习, 分层强化学习, etc.
监督方法(supervised learning)隐式提出了很多假设, 例如数据是独立同分布的(i.i.d.), 数据有标签, 但在一些任务例如机器人抓握物体上其实没有这么强的假设, 没有 i.i.d., 没有基准事实(Ground Truth, GT)

我们在 RL 中想学习策略(policy) \(\pi\), \(\pi\) 将状态 \(\mathbf s\) 映射到动作 \(\mathbf a\) 上, 我们希望总和奖励(reward) \(\sum r\) 尽可能高
为什么我们应该学习 RL?我们不仅需要到达人类的水平, 而且需要超越, 如果我们使用 data-driven 的 AI 则不能达到这点, RL 是关于优化的, 可以解决新问题
在现实世界还有哪些问题要解决?最大化奖励不是唯一重要的, 有时候我们问 "奖励从何而来", 学习不一定是从奖励中来的, 因为现实世界的奖励大多十分稀疏(eg. 学习四年获得大学学位)
逆深度学习在这里可能会很有用, 帮我们直接找 reward, 预测模型在 2017-2023 年迅猛发展, 预训练模型(eg. RT2)也在发展
怎么构造有智慧的机器?先定义智慧, 假设学习是智慧的基础, 一些技巧(eg. 开车)我们需要学习, 猜想有一种通用的学习算法, 它有很多类型的 input 并能输出很多种 action, 一些神经科学文章证明人类学习与神经网络有类似之处
目前(2023)没有很好结合 data 与 RL 的方法, 领域还有种种挑战
Lecture 2 模仿学习
在学习模仿学习(Behavioral Cloning)之前, 先介绍基本符号
\(\pi_\theta\) 是一个 policy(策略),
其中 \(\theta\) 是 policy 的参数,
例如网络权重
在数学上, \(\pi\)
是动作的概率分布
我们用 \(t\) 代表时间步, 其是离散的
在序列决策过程中, 动作会影响观察结果, 动作是决策而不直接是某种标签(不过你确实可以映射), 动作空间可能是连续的, 要熟读下图, \(p(\mathbf s_{t+1}|\mathbf s_t, \mathbf a_t)\) 是条件转移概率

状态 \(\mathbf s_t\) 不同于观察 \(\mathbf o_t\), 基于 \(\mathbf s_t\) 是完整的观察策略(eg. 观察图片上的运动只有像素, 而状态可以告诉你运动的物理信息, 例如速度等), 一般来说观察只是状态的一部分, 很多人在很多时候会弄混 \(\mathbf o\) 和 \(\mathbf s\)
有马尔可夫性质, 在给定 \(\mathbf s_2\) 时, \(\mathbf s_1\) 与 \(\mathbf s_3\) 无关, 已知现在, 过去则不重要
监督学习就是在给定 \(\mathbf o\) 的前提下学习 \(\mathbf a\) 的分布, 以自动驾驶为例, 根据人类的开车获得 \(\mathbf {o, a}\), 然后 "克隆" 人类的行为, 最早的模仿学习方法在 1989 就提出了, 叫做 ALVINN

行为克隆方法会失败, 因为模型会随着时间产生偏差, 使得最终的轨迹(trajectory)不一致

因为监督学习强调了独立同分布, 但在开车问题时不是这样, 不过我们可以部分解决这个问题
NVIDIA 在自动驾驶时使用了左中右三个摄像头,
这样可以在车辆偏移时使其符合左右拐弯的分布而不是人类分布,
这种方法就是数据增强
单纯使用更强更大的模型也可以缓解这个问题
同时学习多个任务或更改算法(DAgger)也可以解决问题
从理论层面, 我们也可以证明行为克隆会失效
例如, 我们怎么知道我们的策略 \(\pi_\theta(\mathbf a_t|\mathbf o_t)\)
是好是坏?
\(p_\pi(s_t)\) 表示在执行策略 \(\pi\) 的情况下, 智能体在时间步 \(t\) 处于状态 \(s_t\) 的概率, 是一个状态分布
首先不能根据 \(\max_{\theta} E_{\mathbf{o}_t
\sim p_{\text{data}}(\mathbf{o}_t)} [\log \pi_{\theta}(\mathbf{a}_t |
\mathbf{o}_t)]\) 来决定, 因为不可能学习所有的策略
我们可以定义一个成本 \[
c(\mathbf{s}_t, \mathbf{a}_t) =
\begin{cases}
0 & \text{if } \mathbf{a}_t = \pi^\star(\mathbf{s}_t) \\
1 & \text{otherwise}
\end{cases}
\\
\text{Goal: minimize } E_{\mathbf{s}_t \sim
p_{\pi_\theta}(\mathbf{s}_t)}[c(\mathbf{s}_t, \mathbf{a}_t)]
\] 假设人类策略为 \(\pi^\star\)
如果动作 \(\mathbf{a}_t\)
与人类动作相同, 那么成本为 0
我们想要最小化预期成本, 但是这是在什么分布上的?
我们关心策略的错误而不是人类的错误, 所以我们关心在 \(p_{\pi_\theta}\) 分布上的成本
假设监督学习是有效的, 那么所有的动作最终应该都趋向落在人类动作上, 有 \[ \pi_\theta(\mathbf{a} \neq \pi^\star(\mathbf{s}) | \mathbf{s}) \leq \epsilon, \forall \mathbf s \in \mathcal D_{\text{train}} \] 但是有这样一个 "走钢丝" 的例子, 最好的动作是留在钢丝上, 不然就会摔死, 你的专家人类从没摔死过, 有的情况从来没有被训练过
在 \(\epsilon\) 的限制下, 我们想计算一个总成本界限, 记住你一犯错后面就不知所措了(没训练过), 有 \[ E \left[ \sum_t c(\mathbf{s}_t, \mathbf{a}_t) \right] \leq \epsilon T + (1 - \epsilon)(\epsilon(T - 1) + (1 - \epsilon)(\dots)) \approx O(\epsilon T^2) \] 这个二次增长不是线性增长, 所以它会随着时间炸掉, 这是最坏情况
如果我们不说 \(\mathbf s \in \mathcal D_{\text{train}}\) 而是 \(\mathbf s \sim p_{\text{train}}(\mathbf s)\), 在 \(p_{\text{train}}(\mathbf s) \neq p_{\theta}(\mathbf s)\) 时我们可以类似推理出 \(O(\epsilon T^2)\) 的犯错概率
我们有假设 \(\pi_\theta(\mathbf{a} \neq \pi^\star(\mathbf{s}) | \mathbf{s}) \leq \epsilon\), 每步犯错的概率只有 \(\epsilon\)
把 \(\theta\) 下的分布拆成两部分, 有 \(p_{\theta}(\mathbf{s}_t) = (1 - \epsilon)^t p_{\text{train}}(\mathbf{s}_t) + (1 - (1 - \epsilon)^t) p_{\text{mistake}}(\mathbf{s}_t)\)
连续 \(t\) 步都没有犯错的概率为 \((1 - \epsilon)^t\), 犯错的概率就再拿 1 去减
我们的分布之间距离可以这么推导 \[ |p_\theta(s_t) - p_{\text{train}}(s_t)| = |(1 - (1 - \epsilon)^t) (p_{\text{mistake}}(s_t) - p_{\text{train}}(s_t))| \leq 2(1 - (1 - \epsilon)^t) \approx 2t\epsilon \] 这里利用了概率分布的 \(l_1\) 距离最大为 2 以及一阶泰勒 \((1-\epsilon)^t \approx 1 - t\epsilon\) 来放缩
我们算总犯错成本的期望上界, 把时间步求和, 即计算 \(\sum_t E_{p_{\theta}(\mathbf{s}_t)}[c_t] = \sum_t \sum_{\mathbf{s}_t} p_{\theta}(\mathbf{s}_t)c_t(\mathbf{s}_t)\)
由于我们拆过了 \(p_{\theta}\), 有 \[ \sum_t \sum_{\mathbf{s}_t} p_{\theta}(\mathbf{s}_t)c_t(\mathbf{s}_t) \leq \sum_t \sum_{\mathbf{s}_t} p_{\text{train}}(\mathbf{s}_t)c_t(\mathbf{s}_t) + |p_{\theta}(\mathbf{s}_t) - p_{\text{train}}(\mathbf{s}_t)|c_{\text{max}} \] 这个东西挺糙的, \(c_{\max}\) 代表我们一旦偏离 \(p_{\text{train}}\) 就会完全完蛋(走钢丝问题)
前面 \(\sum_t\sum_{\mathbf{s}_t} p_{\text{train}}(\mathbf{s}_t)c_t(\mathbf{s}_t) \leq \sum_t \epsilon\)
后面 \(\sum_t \sum_{\mathbf{s}_t} |p_{\theta}(\mathbf{s}_t) - p_{\text{train}}(\mathbf{s}_t)|c_{\text{max}} \leq \sum_t 2t\epsilon\)
前面的之间扔掉没问题, 后面 \(\sum_t 2t\epsilon \approx O(\epsilon T^2)\), 于是同样炸
有一个有趣的结论, 数据中有更多的错误与恢复可以让监督学习变得更好, 而完美的数据却训练不出来
数据有错没关系, 错误绘制的轨迹还能够相互抵消
如果以某种概率促使专家犯错, 而这种错误概率与状态无关,
那么错误与状态无关, 而最优行动将与状态有关
数据增强也有用, 但数据增强的 trick 有点 ad-hoc?
为什么无法适应专家行为?
专家行为是非马尔可夫行为, 人类的动作基于过去的一切, \(\pi_\theta(\mathbf a_t|\mathbf o_1, \dots, \mathbf o_t)\)
所以你可能会想到利用序列模型, 例如 LSTM, 来做模仿学习, 但这也可能导致效果更差序列模型可能导致混淆因果, 例如刹车是由于减速(显然联系), 而不是刹车是因为特殊情况(难以总结)
多模态行为: 假设你想绕树行走, 左右均可, 但模型可能学习到了平均后的直行从而撞树
对于第二个问题, 我们希望网络能够输出多模态
可以使用高斯混合模型, 把 \(n\)
个高斯分布结合起来, 这里的问题是你不知道一共有多少种模式
隐变量(latent variable)模型可以表示任何分布, 只要神经网络够大
它还接受一个先验分布输入, 类似于随机数发生器的种子, 当然输入不是随机的,
我们可以用变分自编码器在训练中实现这点,
先验的输入告诉模型该使用什么模式
扩散模型在近年内广受关注, 它很像隐变量模型, 从噪声中预测动作, 我们最后会补充
离散化也可以获得复杂动作, 但是其在高维十分困难, 所以一次可以离散化一个维度, 这就是自回归离散化的思想, 需要序列模型

使用多任务学习可以使得任务更简单
其大体思想是, 把 "要去哪里/要达到什么状态" 作为策略输入,
让不同任务的数据共同训练一个策略; 再利用已经发生的轨迹,
为它构造更多目标条件训练样本, 从 \(\pi_\theta(\mathbf a | \mathbf s)\) 变成
\(\pi_\theta(\mathbf a | \mathbf s,
g)\)
每条轨迹可以写成 \(\tau^i=(\mathbf
s_1^i,\mathbf a_1^i,\ldots,\mathbf s_{T-1}^i,\mathbf a_{T-1}^i,\mathbf
s_T^i)\), 其终点 \(s_T^i\)
被当作该条示范的目标 \(g\)
于是每个时间步都提供一个监督样本 \((\mathbf
s_t^i,g=\mathbf s_T^i,\mathbf a_t^i)\), 目标是最大化 \(\log\pi_\theta(\mathbf a_t^i\mid \mathbf
s_t^i,g=\mathbf s_T^i)\)
一种收集数据的方法是 random play, 以后面的状态作为前面状态的未来目标, 这需要专家覆盖广的 play data
一种非 BC 的方法是, 从 random policy 开始, 收集 random goals 的 data, 将 data 视作到达状态的演示, relabel, 改进, 重运行, 参数中有不同的 goal \(\mathcal G\)。一开始策略是随机的, 慢慢它会学习到有用的动作, 这是 HER 的思想, 后面会遇到它
下面详细介绍 DAgger 算法, 我们希望直接改变 \(p_{\text{data}}\) 来接近 \(p_{\pi_\theta}\)
在收集数据的时候, 我们就直接按照 \(p_{\pi_\theta}\) 来收集, 但是你说不对啊,
还没练模型怎么知道 \(p_{\pi_\theta}\)
于是我们循环做这个来更新

第一步就是正常训练, 第二步根据 \(\pi_\theta(\mathbf a_t|\mathbf o_t)\) 生成数据, 第三步真人标记数据, 这样分布被改变过来了, 第四步将数据结合, 重新训练
这不就是哪里有错训哪里, 可以从数学上证明两个分布会趋同
不过第三步事后标记数据显得不够自然, 例如开车的决策和看图像的决策总是有区别的
行为克隆被我们 "部分" 挽救了, 说是部分, 因为一些任务人类不可能会, 例如单独控制四轴飞行器螺旋桨的各个参数使其飞行, 或者控制机器人的全身关节, 而且有些问题的数据是有限或难以取得的
于是我们要引入奖励函数 \(r(\mathbf s, \mathbf a)\)
π0 补充
其实, Behavioral Cloning 是现代精华而不是过时方法, 不应该只学到 2011 年的 DAgger
如果我们不引入奖励函数 \(r(\mathbf s, \mathbf a)\), 那么就要面对 策略犯错进入示范数据里很少出现的状态的情况; 错误会累积, 需要更强的模型、纠错数据和多任务学习
为什么无法适应专家行为?我们继续关系专家行为多模态的问题
之前的解决方向是自回归离散化, 假设动作向量有三个分量 \(a_{t,0},a_{t,1},a_{t,2}\), 模型先根据状态
\(\mathbf s_t\)
预测第一个分量;再结合已选的第一个分量预测第二个, 依此类推
另一条路线就是 flow matching
策略接收随机噪声 \(\xi\), 并输出动作
\(\mathbf a=f_\theta(\mathbf o,\xi),\;
\xi\sim\mathcal N(0,I)\), 在同一个观测 \(\mathbf o\) 下,
不同噪声应能产生不同的动作

在这里 flow matching 的核心公式是 \(x_1=x_0+\displaystyle\int_0^1 v(x_t,t)\, \mathrm
dt\)
\(x_0\) 从简单的起始分布采出的噪声,
\(x_1\) 是生成过程终点,
希望它服从目标数据分布
我们在学一个速度场, 让噪声中的点沿它流动,
最后形成数据的分布
我们不直接把噪声回归到动作, 把复杂的分布变换拆成许多局部移动,
这种速度可以从训练数据构造出监督信号

训练需要一个噪声 \(x_0\), 一个样本 \(x_1\), 中间 \(t \sim p(t)\) 采样并插值出来 \(x_t\), 因为 \(\dfrac{dx_t}{dt}=x_1-x_0\), 这就是我们的训练标签, 让网络预测这个速度, 最小化 \(\mathcal L(\theta) = \mathbb E_{x_0,x_1,t} \left[ \left\|v_\theta(x_t,t)-(x_1-x_0)\right\|_2^2 \right]\)
训练完成后采样, 从 \(x_0\sim\mathcal N(0,I)\) 开始, 小步更新 \(x_{t+\Delta t} \leftarrow x_t+v_\theta(x_t,t)\Delta t\)
对于行为克隆, 目标是根据观测 \(\mathbf o_t\), 生成专家动作 \(\mathbf a_t\), 我们的速度场网络变成 \(v_\theta(\mathbf o_t,\mathbf a_{t,\tau},\tau)\), 其中 \(\tau\) 是生成进度
这里有一个有趣的 Action Chunking 的 trick, 很多行为天然具有短期连续结构, 为什么不一次生成一段动作序列?用 flow matching 做 \(\mathbf a_{t:t+K}\sim\pi_\theta(\mathbf a_{t:t+K}\mid \mathbf o_t)\)

伟大的具身智能界 gpt(存疑) \(\pi_0\)
可以完成多物理任务的泛化或某种复杂任务的灵巧操作
Pre-training(具身智能的专用数据集, 10000+ hours!)得到 foundation model,
Post-training 完成多项任务
VLM 视觉语言模型从图像中识别场景, 并结合语言判断任务目标,
这里包含视觉模型 SigLIP 和大型语言模型 Gemma
Action Expert 接受 VLM 输出, 输出 action 的网络, 使用 flow matching +
action chunk
更多细节见 \(\pi_0\): A Vision-Language-Action Flow
Model for General Robot Control 的 Appendix B
介绍一下 Narrow data 与 Broad data 的概念
以折衣服为例, Narrow data 中每次衣服都平整地放在桌上,
机器人按同一套步骤成功折好, 动作规范,
几乎没有衣服滑动、抓偏或折歪的例子
Broad data
包含不同衣服、摆放方式、机器人姿态,以及操作失误后的状态。它能让模型认识更多情境,
但其中的动作未必都是值得模仿的
模仿学习不喜欢 mistake, 也不喜欢 perfect correct,
而是更偏好偏离后的恢复动作
我们希望模型见过很多坏情况, 以便知道如何处理;
但不希望教它进入这些坏情况
于是用 Broad data 预训练, Narrow data 后训练
在 \(\pi_0\) 中, 10000h
的预训练数据来自各种任务的 Broad data, 对于给定任务(eg. 折衣服)有 20h 的
Narrow data
Lecture 4 强化学习介绍
Lecture 3 是 pytorch, 略之, Lecture 4 看下面的笔记可能更好(更全面), 不过下面对应的是 20/21 年的课程?
奖励函数 \(r(\mathbf s, \mathbf a)\) 告诉你哪些 \(\mathbf {s, a}\) 更好, 但决策不仅是当前更好, 而是未来也更好
马尔可夫链简化各个状态之间的耦合关系, 它假设某一个状态只与其前一个状态有关, 与其他状态无关, 即: \[ p(\mathbf s_{t+1} | \mathbf s_1, \mathbf s_2, \dots, \mathbf s_t) = p(\mathbf s_{t+1} | \mathbf s_t) \] 形式化的马尔可夫链定义为 \(\mathcal{M} = \{ \mathcal{S}, \mathcal{T} \}\)

- \(\mathcal{S}\) 是状态空间, \(\mathbf s \in \mathcal{S}\) (状态可以是连续也可以是离散的)
- \(\mathcal{T}\) 是状态转移算子(operator), 本质上是一个矩阵, 其中, \(\mathcal{T}_{i,j} = p(\mathbf s_{t+1} = i | \mathbf s_t = j)\)
令 \(u_{t,i} = p(\mathbf s_t = i)\),
这里 \(\mathbf{u}_t\) 是状态向量,
可以说是由随机变量的值组成的向量
根据最基本的矩阵乘法, 下一个状态向量为 \(\mathbf{u}_{t+1} = \mathcal{T}
\mathbf{u}_t\)
形式化的马尔可夫决策过程定义为 \(\mathcal{M} = \{ \mathcal{S}, \mathcal{A}, \mathcal{T}, r \}\)

\(\mathcal{A}\) 是动作空间, 可以是连续动作或离散动作
\(\mathcal{T}\) 本质上是一个 张量(tensor), 即 \(\mathcal{T}_{i,j,k} = p(\mathbf s_{t+1} = i | \mathbf s_t = j, \mathbf a_t = k)\)
令 \(u_{t,j} = p(\mathbf s_t = j), \xi_{t,k} = p(\mathbf a_t = k)\), 则由张量乘法可以得到 \(u_{t+1,i} = \sum\limits_{j,k} \mathcal{T}_{i,j,k} u_{t,j} \xi_{t,k}\)
奖赏函数 \(r(\mathbf{s}, \mathbf{a})\), 是一种到实数的映射: \(\mathcal{S} \times \mathcal{A} \to \mathbb{R}\)
其余定义同上
形式化的部分可观测马尔可夫(POMDP)决策过程定义为 \(\mathcal{M} = \{ \mathcal{S}, \mathcal{A}, \mathcal{O}, \mathcal{T}, \mathcal{E}, r \}\)

在实际的决策回路中, 应该还存在从 \(\mathbf o_t\) 到 \(\mathbf a_t\) 的边, 这代表了智能体的策略 \(\pi(\mathbf a_t |\mathbf o_t)\)
- \(\mathcal{O}\) 是观测空间
- \(\mathcal{E}\)
是发射概率(emission probability), 公式为 \(p(\mathbf o_t |\mathbf s_t)\)
代表状态 \(\mathbf s_t\) "发射" 出一些观测值 \(\mathbf o_t\) - 其余定义同上
强化学习的目标
首先形式化定义轨迹(trajectories), 轨迹 \(\tau\) 是状态与动作的序列, 即 \(\mathbf s_1, \mathbf a_1, \mathbf s_2, \mathbf a_2, \dots \mathbf s_t, \mathbf a_t, \dots\)
假设控制问题是有限时域的, 我们可以根据概率的链式法则分解, 有 \[
\underbrace{p_{\theta}(\mathbf{s}_1, \mathbf{a}_1, \dots, \mathbf{s}_T,
\mathbf{a}_T)}_{p_{\theta}(\tau)} = p(\mathbf{s}_1) \prod_{t=1}^T
\pi_{\theta}(\mathbf{a}_t | \mathbf{s}_t) p(\mathbf{s}_{t+1} |
\mathbf{s}_t, \mathbf{a}_t)
\]

这是一个 \((\mathbf{s}_t,
\mathbf{a}_t)\) 对的马尔科夫链, \(p_\theta(\tau)\) 就是轨迹 \(\tau\) 的概率
于是我们可以为 RL 定义目标, 最大化轨迹上奖励总和的期望
\[
\begin{aligned}
\theta^{\star} & = \arg \max_{\theta} E_{\tau \sim p_{\theta}(\tau)}
\left[ \sum_{t} r(\mathbf{s}_t, \mathbf{a}_t) \right] \\
& = \arg \max_{\theta} \sum_{t=1}^{T} E_{(\mathbf{s}_t,
\mathbf{a}_t) \sim p_{\theta}(\mathbf{s}_t, \mathbf{a}_t)}
[r(\mathbf{s}_t, \mathbf{a}_t)]
\end{aligned}
\] 推导利用期望的线性性质就可以了, 有 \(E_{\tau \sim p_\theta(\tau)} \left[
\sum\limits_{t=1}^T r(\mathbf{s}_t, \mathbf{a}_t) \right]
= \sum\limits_{t=1}^T E_{\tau \sim p_\theta(\tau)} [r(\mathbf{s}_t,
\mathbf{a}_t)]\)
然后因为 \(r(\mathbf{s}_t,
\mathbf{a}_t)\) 只和 \((\mathbf{s}_t,
\mathbf{a}_t)\) 有关, 就消过来了, 这样大大化简了复杂度,
也可以推广到无限时域情况
无限时域有两种可能, 一是稳定(stationary)了(收敛), 此时 \(u = \mathcal Tu\), 这里 \(u = p_\theta(\mathbf s, \mathbf a)\), 于是 \[ \theta^{\star} = \arg \max_{\theta} \frac{1}{T} \sum_{t=1}^{T} E_{(\mathbf{s}_t, \mathbf{a}_t) \sim p_{\theta}(\mathbf{s}_t, \mathbf{a}_t)} [r(\mathbf{s}_t, \mathbf{a}_t)] \to E_{(\mathbf{s}, \mathbf{a}) \sim p_{\theta}(\mathbf{s}, \mathbf{a})} [r(\mathbf{s}, \mathbf{a})] \] 右侧是定义在 \(T \to \infty\) 上的
二是不稳定, 那方法就百花齐放了: 引入折扣因子 \(\gamma\), 使用"占用度量", 强制平均奖励, 采用追踪策略, etc.
强化学习就是优化期望的, 期望函数不连续, 但是期望值在对应分布的函数中是连续的, 于是我们就能用 RL 优化看似不可微分的目标
\(r(\mathbf x)\) 在 \(\mathbf x\) 上不连续, 但是 \(E_{\pi_\theta}[r(\mathbf x)]\) 在 \(\theta\) 上连续啊
强化学习算法通常由生成样本, 学习模型/拟合回归, 改进 policy 三个部分构成, 这三个部分会不断循环

这里有期望奖励函数 \(J(\theta)\)
有的时候绿框对应的是 fit a model, 这时候就不是求和(简单),
而是算一整个神经网络(困难), 此时 improve the policy
一般就是算反向传播了
在有的时候, 反而生成样本会十分昂贵, 例如做真实的机器人训练, 而一些模拟器上生成样本会十分简单
值函数 (Value Functions)
强化学习的目标是期望值 \(E_{\tau \sim p_{\theta}(\tau)} \left[ \sum\limits_{t=1}^T r(\mathbf{s}_t, \mathbf{a}_t) \right]\), 我们可以递归展开, 有
\[ \begin{aligned} & E_{\tau \sim p_{\theta}(\tau)} \left[ \sum_{t=1}^{T} r(\mathbf s_t, \mathbf a_t) \right] = \\ & E_{\mathbf s_1 \sim p(\mathbf s_1)} \left[ E_{\mathbf a_1 \sim \pi(\mathbf a_1|\mathbf s_1)} \left[ r(\mathbf s_1, \mathbf a_1) + E_{\mathbf s_2 \sim p(\mathbf s_2|\mathbf s_1, \mathbf a_1)} \left[ E_{\mathbf a_2 \sim \pi(\mathbf a_2|\mathbf s_2)} \left[ r(\mathbf s_2, \mathbf a_2) + \cdots | \mathbf s_2 \right] | \mathbf s_1, \mathbf a_1 \right] | \mathbf s_1 \right] \right] \end{aligned} \] 在这里我们可以导出 Q 函数, \(Q(\mathbf s_1, \mathbf a_1) = r(\mathbf s_1, \mathbf a_1) + E_{\mathbf s_2 \sim p(\mathbf s_2|\mathbf s_1, \mathbf a_1)} \left[ E_{\mathbf a_2 \sim \pi(\mathbf a_2|\mathbf s_2)} \left[ r(\mathbf s_2, \mathbf a_2) + \cdots | \mathbf s_2 \right] | \mathbf s_1, \mathbf a_1 \right]\)
此时 \(E_{\tau \sim p_{\theta}(\tau)}
\left[ \sum\limits_{t=1}^T r(\mathbf{s}_t, \mathbf{a}_t) \right] =
E_{\mathbf s_1 \sim p(\mathbf s_1)} \left[ E_{\mathbf a_1 \sim
\pi(\mathbf a_1|\mathbf s_1)} \left[ Q(\mathbf s_1, \mathbf a_1)|
\mathbf s_1\right ]\right ]\)
不是, 这不是文字游戏吗?但如果知道了 \(Q(\mathbf s_1, \mathbf a_1)\),
最优化这个期望就十分简单了
我们可以在任意时间步上定义 Q-function, 有 \[ Q^\pi(\mathbf s_t, \mathbf a_t) = \sum_{t'=t}^T E_{\pi_\theta} [r(\mathbf s_{t'}, \mathbf a_{t'})|\mathbf s_t, \mathbf a_t] \] 这代表从状态 \(\mathbf s_t\) 开始然后采取行动 \(\mathbf a_t\), 开始执行策略 \(\pi\) 的预期奖励
类似的, 可以定义价值函数 \[ V^\pi(\mathbf s_t) = \sum_{t'=t}^T E_{\pi_\theta} [r(\mathbf s_{t'}, \mathbf a_{t'})|\mathbf s_t] \] 这代表从状态 \(\mathbf s_t\) 开始执行策略 \(\pi\) 的预期奖励, 可以发现后者是前者的期望, 于是有 \[ V^\pi(\mathbf s_t) = E_{\mathbf a_t \sim \pi(\mathbf a_t| \mathbf s_t)} [Q^\pi(\mathbf s_t, \mathbf a_t)] \] 这样一绕, 原来 RL 的目标又变成了 \(E_{\mathbf s_1 \sim p(\mathbf s_1)}[V^\pi(\mathbf s_1)]\)
这两个函数有什么用?
如果有 \(\pi\) 以及 \(Q(\mathbf s, \mathbf a)\), 就可以改进 \(\pi\)
eg. 如果 \(\mathbf a = \arg \max_{\mathbf a} Q^\pi(\mathbf s, \mathbf a)\), 我们就改进为 \(\pi'(\mathbf a|\mathbf s)=1\), 策略迭代后绝对比 \(\pi\) 好
我们可以计算梯度来增加好动作 \(\mathbf a\) 的概率
如果 \(Q^\pi(\mathbf s, \mathbf a) > V^\pi(\mathbf s)\), 那么 \(\mathbf a\) 是超过平均的一个好动作, 于是我们可以改进 \(\pi(\mathbf a|\mathbf s)\) 来增加 \(\mathbf a\) 出现的概率
不同类型算法 (Types of Algorithms)
\(\theta^{\star} = \arg \max_{\theta} E_{\tau \sim p_{\theta}(\tau)} \left[ \sum_{t} r(\mathbf{s}_t, \mathbf{a}_t) \right]\) 是我们的目标
Policy Gradient 方法: 直接计算目标关于 \(\theta\) 的导数
Value-based 方法: 估计 Q-function 或 \(V(\mathbf s)\), 间接改进 policy(policy 是 arg max)
Actor-critic 方法: 估计 Q-function 或 \(V(\mathbf s)\), 直接计算导数(梯度)改进 policy
Model-based RL: 估计转移概率模型, 然后用转移模型进行规划或者直接改进 policy 或者干其他事
Model-based RL 的改进 policy 方法实在过多, 来举几个具体例子
蒙特卡洛树搜索, 最优化控制, 反向传播, 学习价值函数 + DP, etc.
不同算法的 trade-off
每种类型算法都有用, 取决于具体问题形式
例如样本效率(Sample
efficiency)代表从策略中采样多少次才能使其表现良好
off-policy 算法可以根据先前收集的样本来改进策略, on-policy 算法必须在
policy 变化时重新生成样本
Policy Gradient 算法就是 on-policy 的, 这使得其很低效
我们可以画一个光谱来排序算法

有的时候我们不那么关心样本效率, 因为样本很快就能生成
有时候我们更关心 RL 是否能收敛?收敛到局部最优还是全局最优?
额, RL 领域的算法分类其实乱成了一团, on-policy 指的是某种 "batch size
buffer / rollout buffer", 也有按照 model-based / model-free 分类的方法,
但是也有 MB+MF 的算法
在前面的 Lec 1-9 的两条主线是 Value-based 方法(DQN like)与 Policy-based
方法(REINFORCE), 以及它们的混合物(A2C, TRPO, PPO, SAC, ...)
然后从最优控制和规划开始是 Model-based 相关方法(iLQR, MPC, MCTS),
这之后又可以与前面的混合在一起(Dyna like)
RL 的发展与方法比较乱, 我也在一次一次的重看自己的笔记,
然后每次逐渐把握不同的脉络, 我在下面再放一堆的分类图,
它们可能都有用也可能都没用


可能最复杂的关系图更准确一点

在 RL 中, 能收敛的算法是一种奢侈
Q-learning 的收敛性是 open problem
model-based RL 的模型本身是收敛的,
但是可能有更好的基模获得更多奖励
Policy-Gradient 最低效, 但是保证某种收敛
RL 算法一般有一些假设, 例如
\(\mathbf s = \mathbf o\)
(状态就是观测, 放心, 后面会学习 POMDP 的处理的)
情节式学习(可以重复尝试, 回到之前状态)
连续性与平滑性
Lecture 5 策略梯度方法
CS285课程笔记——Model-free 方法之 Policy Gradient - 知乎
例行推荐别人笔记
回顾一下, \(\theta^{\star} = \arg
\max_{\theta} E_{\tau \sim p_{\theta}(\tau)} \left[ \sum_{t}
r(\mathbf{s}_t, \mathbf{a}_t) \right]\) 是我们的目标
我们设 \(J(\theta) = E_{\tau \sim
p_{\theta}(\tau)} \left[ \sum_{t} r(\mathbf{s}_t, \mathbf{a}_t)
\right]\), 我们不知道 \(p_\theta\), 怎么估计 \(J(\theta)\)?
答案是随机取样本轨迹 \(i\),
相加奖励并平均, 这就是 \(J\) 的无偏估计
\(J(\theta) \approx \dfrac{1}{N}\sum_i\sum_t
r(\mathbf s_{i,t}, \mathbf a_{i,t})\)
我们也可以估计 \(\nabla_\theta
J(\theta)\), 继续做简写处理, 令 \(r(\tau) = \sum_{t=1}^T r(\mathbf{s}_t,
\mathbf{a}_t)\), 带入到目标函数并展开, 有 \[
J(\theta) = E_{\tau \sim p_{\theta}(\tau)} [r(\tau)] = \int
p_{\theta}(\tau) r(\tau) d\tau
\] 然后求梯度 \[
\nabla_{\theta} J(\theta) = \int \nabla_{\theta} p_{\theta}(\tau)
r(\tau) d\tau = \int p_{\theta}(\tau) \frac{\nabla_{\theta}
p_{\theta}(\tau)}{p_{\theta}(\tau)} r(\tau) d\tau
\] 利用 \(\dfrac{\nabla_{\theta}
p_{\theta}(\tau)}{p_{\theta}(\tau)} = \nabla_{\theta} \log
p_{\theta}(\tau)\), 有 \[
\begin{aligned}
\nabla_{\theta} J(\theta) &= \int p_{\theta}(\tau)
\frac{\nabla_{\theta} p_{\theta}(\tau)}{p_{\theta}(\tau)} r(\tau) d\tau
= \int p_{\theta}(\tau) \nabla_{\theta} \log p_{\theta}(\tau) r(\tau)
d\tau \\
&= E_{\tau \sim p_{\theta}(\tau)} [\nabla_{\theta} \log
p_{\theta}(\tau) r(\tau)]
\end{aligned}
\] 现在有了 \(\nabla_{\theta} J(\theta)
= E_{\tau \sim p_{\theta}(\tau)} [\nabla_{\theta} \log p_{\theta}(\tau)
r(\tau)]\), 我们可以展开 \(\nabla_{\theta} \log p_{\theta}(\tau)\), 有
\[
\begin{aligned}
\nabla_{\theta} \log p_\theta(\tau) &= \nabla_{\theta} \log \left(
p(\mathbf s_1) \prod_{t=1}^T \pi_\theta(\mathbf a_t|\mathbf
s_t)p(\mathbf s_{t+1}|\mathbf s_t, \mathbf a_t) \right) \\
&= \nabla_{\theta} \left( \log p(\mathbf s_1) + \sum_{t=1}^T \log
\pi_\theta(\mathbf a_t|\mathbf s_t) + \log p(\mathbf s_{t+1}|\mathbf
s_t, \mathbf a_t) \right) \\
&= \sum_{t=1}^T \nabla_\theta \log \pi_\theta(\mathbf a_t|\mathbf
s_t) \quad(因为不带 \theta 项的全被扬了)
\end{aligned}
\] 于是展开轨迹 \(\tau\), 有
\(\nabla_\theta J(\theta) = E_{\tau \sim
p_\theta(\tau)} \left[ \left( \sum\limits_{t=1}^T \nabla_\theta \log
\pi_\theta(\mathbf a_t|\mathbf s_t) \right) \left( \sum\limits_{t=1}^T
r(\mathbf{s}_t, \mathbf{a}_t) \right) \right]\)
同上文通过蒙特卡洛采样近似, 把期望去掉, 有 \(\nabla_\theta J(\theta) \approx \dfrac{1}{N} \sum\limits_{i=1}^N \left[ \left( \sum\limits_{t=1}^T \nabla_\theta \log \pi_\theta(\mathbf a_{i,t}|\mathbf s_{i,t}) \right) \left( \sum\limits_{t=1}^T r(\mathbf{s}_{i,t}, \mathbf{a}_{i,t}) \right) \right]\)
然后就是经典的梯度下降 \(\theta \leftarrow \theta + \alpha\nabla_\theta J(\theta)\) 了
我们刚刚推出的就是 REINFORCE 算法, 但它的应用可能不会特别有用

我们理解一下策略梯度公式, \(\nabla_\theta J(\theta) = E_{\tau \sim p_\theta(\tau)} \left[ \left( \sum\limits_{t=1}^T \nabla_\theta \log \pi_\theta(\mathbf a_t|\mathbf s_t) \right) \left( \sum\limits_{t=1}^T r(\mathbf{s}_t, \mathbf{a}_t) \right) \right]\)
深度学习中, 有交叉熵损失函数衡量两个分布之间的距离, 做最大似然估计,
对应损失 \(L = -\sum_{i=1}^{M} y_i
\log(\hat{y}_i)\)
在这里是类似的, 只不过我们在梯度前乘上了 \(R(\tau)\) 权值, 类似加权最大似然?
在连续动作中, 我们可以训练 \(\pi_\theta(\mathbf a_t|\mathbf s_t) = \mathcal
N(f_{\text{neural network}}(\mathbf s_t);\Sigma)\), 即把 \(\pi\) 训练成一个分布
此时你可以用你概率论上学的多元高斯分布的知识来算 \(\nabla_\theta \log \pi_\theta(\mathbf a_t|\mathbf
s_t)\), 有 \[
\log \pi_\theta(\mathbf a_t|\mathbf s_t) = -\frac{1}{2}\| f(\mathbf
s_t)-\mathbf a_t \|_{\Sigma}^2 + \text{const}\\
\nabla_\theta \log \pi_\theta(\mathbf a_t|\mathbf s_t) = (\mathbf
a_t-f(\mathbf s_t))^{\top}\Sigma^{-1} \frac{df}{d\theta}
\] 当 \(\mathbf s \to \mathbf
o\) 时(即部分可观测 MDP), 因为推导时没有用到 MDP 性质,
可以算得类似的 \(\nabla_\theta J(\theta) =
E_{\tau \sim p_\theta(\tau)} \left[ \left( \sum\limits_{t=1}^T
\nabla_\theta \log \pi_\theta(\mathbf a_t|\mathbf o_t) \right) \left(
r(\tau) \right) \right]\)
policy-gradient 的问题在于高方差(其实严格来讲可能叫做以 0 为均值的平方统计量什么的东西, 懂意思就行)

例如上图, 奖赏值上加一个常量不会影响策略梯度, 但是会改变策略的概率分布, 这是由于奖励的方差导致的
目标是减少方差
第一个 trick 是因果关系假设: 未来时刻的策略并不能影响之前时刻的奖赏值,
给之前的 \(\nabla_\theta J(\theta)\)
加个 mask, 有 \[
\nabla_\theta J(\theta) \approx \dfrac{1}{N} \sum\limits_{i=1}^N \left[
\left( \sum\limits_{t=1}^T \nabla_\theta \log \pi_\theta(\mathbf
a_{i,t}|\mathbf s_{i,t}) \right) \left( \sum\limits_{t'=t}^T
r(\mathbf{s}_{i,t'}, \mathbf{a}_{i,t'}) \right) \right]
\] 我们称 \(\hat Q(i,t) =
\sum\limits_{t'=t}^T r(\mathbf{s}_{i,t'},
\mathbf{a}_{i,t'})\) 叫做 "reward to go",
这里引用一下图片
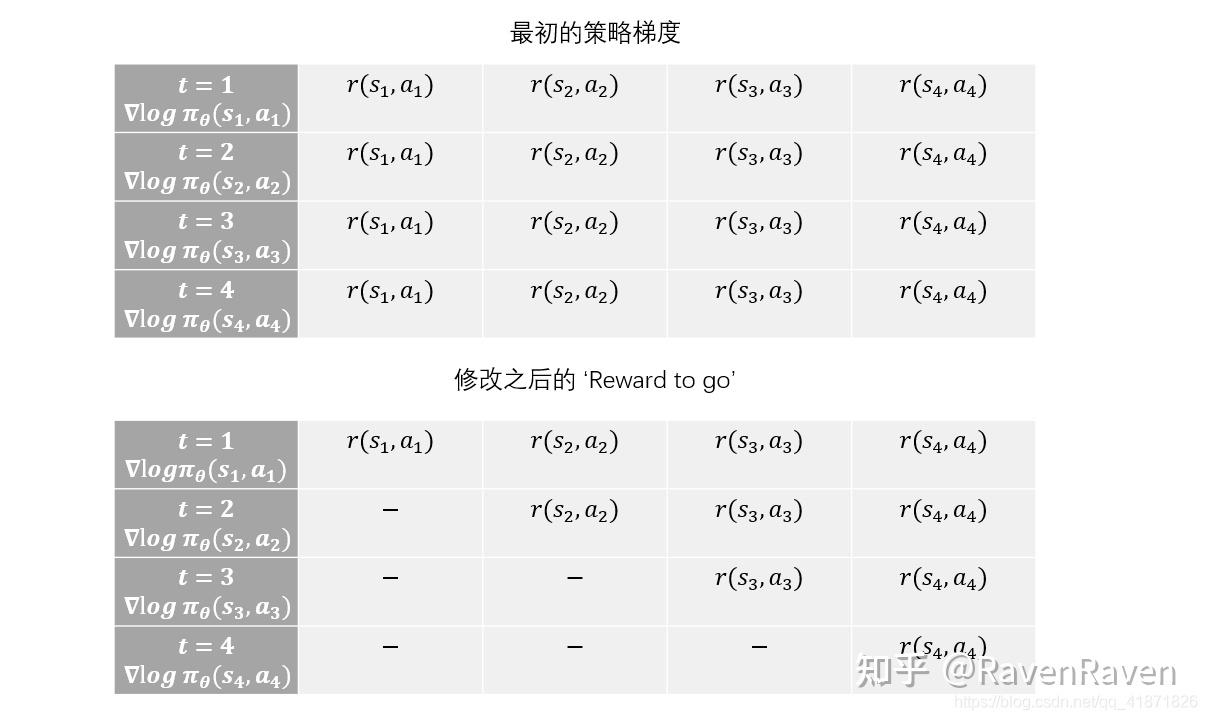
另一个 trick 是基线(Baseline), reward
全减掉一个基线(例如平均值), 方差不就下来了, 我们形式化为 \[
\nabla_\theta J(\theta) \approx \dfrac{1}{N}
\sum\limits_{i=1}^N \nabla_\theta \log
p_\theta(\tau) \left[r(\tau)-b \right]
\] 其中 \(b\) 为基线,
最简单的平均值基线为 \(b =
\dfrac{1}{N}\sum\limits_{n=1}^N r(\tau)\)
我们也可以朝着最小化方差的角度选取基线, 此时 \(b =
\dfrac{E[g(\tau)^2r(\tau)]}{E[g(\tau)^2]}\), 其中 \(g(\tau) = \nabla_\theta \log
p_\theta\)
当然这样是理论最优, 实际上求个平均值已经够用
不管减去怎样的基线 \(b\),
这么做之后得到的 \(\nabla_\theta
J(\theta)\) 仍然是无偏的, 可以通过把 \(-b\) 部分的期望拆出来来证明
我们还有一个 trick 就是加入对未来的折扣因子 \(\gamma\), 在 homework 2 中也有提及
接下来我们介绍如何把 policy-gradient 扩展为 off-policy 的
在计算 \(\nabla_\theta J(\theta)\)
时, 我们不免遇到 \(E_{\tau \sim
p_\theta(\tau)}\), 我们的采样是基于 \(\theta\) 进行的, 因此每次改变 \(\theta\) 时就要把之前采样的样本全部丢弃,
所以 policy-gradient 方法是 on-policy 的
神经网络每次更新在 \(\theta\)
上只会产生微小变化, 我们就不能重用之前的采样吗?这是一个自然的直觉
如果我们没有 \(p_\theta(\tau)\) 上的样本, 只有 \(\bar p(\tau)\) 上的样本, 我们采用一种叫做重要性采样的技术
于是我们可以用旧策略 \(\bar
p(\tau)\) 来估计 \(J(\theta)\),
有 \(J(\theta) = E_{\tau \sim \bar p(\tau)}
[\dfrac{p_\theta(\tau)}{\bar p(\tau)} r(\tau)]\)
其中 \(\dfrac{p_\theta(\tau)}{\bar
p(\tau)}\) 可以进一步通过展开来化简, 有 \[
\dfrac{p_\theta(\tau)}{\bar p(\tau)} = \frac{p(\mathbf s_1)
\prod_{t=1}^T \pi_\theta(\mathbf a_t|\mathbf s_t) p(\mathbf
s_{t+1}|\mathbf s_t,\mathbf a_t)}{p(\mathbf s_1) \prod_{t=1}^T
\bar\pi(\mathbf a_t|\mathbf s_t) p(\mathbf s_{t+1}|\mathbf s_t,\mathbf
a_t)} = \frac{\prod_{t=1}^T \pi_\theta(\mathbf a_t|\mathbf
s_t)}{\prod_{t=1}^T \bar\pi(\mathbf a_t|\mathbf s_t)}
\] 我们可能更关心 \(\nabla_{\theta}
J({\theta})\), 原文把符号改掉了, \(p_{\theta}(\tau)\) 表示旧策略, \(p_{\theta'}(\tau)\) 表示新策略,
我们继续做重要性采样 \[
\nabla_{\theta'} J(\theta') = E_{\tau \sim p_\theta(\tau)}
\left[ \frac{\nabla_{\theta'} p_{\theta'}(\tau)}{p_\theta(\tau)}
r(\tau) \right] = E_{\tau \sim p_\theta(\tau)} \left[
\frac{p_{\theta'}(\tau)}{p_\theta(\tau)} \nabla_{\theta'} \log
p_{\theta'}(\tau) r(\tau) \right]
\] 当 \(\theta = \theta'\)
时, 这就是原先的策略梯度公式
当 \(\theta \neq \theta'\) 时,
我们展开轨迹, 消一消, 有, \[
\begin{aligned}
\nabla_{\theta'} J(\theta') &= E_{\tau \sim p_\theta(\tau)}
\left[ \frac{p_{\theta'}(\tau)}{p_\theta(\tau)} \nabla_{\theta'}
\log p_{\theta'}(\tau) r(\tau) \right] \\
&= E_{\tau \sim p_\theta(\tau)} \left[ \left( \prod_{t=1}^T
\frac{\pi_{\theta'}(\mathbf{a}_t |
\mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} \right) \left(
\sum_{t=1}^T \nabla_{\theta'} \log \pi_{\theta'}(\mathbf{a}_t |
\mathbf{s}_t) \right) \left( \sum_{t=1}^T r(\mathbf{s}_t, \mathbf{a}_t)
\right) \right] \\
&= E_{\tau \sim p_\theta(\tau)} \left[ \sum_{t=1}^T
\nabla_{\theta'} \log \pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)
\left( \prod_{t'=1}^t \frac{\pi_{\theta'}(\mathbf{a}_{t'} |
\mathbf{s}_{t'})}{\pi_\theta(\mathbf{a}_{t'} |
\mathbf{s}_{t'})} \right) \left( \sum_{t'=t}^T
r(\mathbf{s}_{t'}, \mathbf{a}_{t'}) \left(
\prod_{t''=t}^{t'}
\frac{\pi_{\theta'}(\mathbf{a}_{t''} |
\mathbf{s}_{t''})}{\pi_\theta(\mathbf{a}_{t''} |
\mathbf{s}_{t''})} \right) \right) \right]
\end{aligned}
\] 一般来说, 为了防止方差爆炸, 我们会去除 $_{t''=t}^{t'} $
一项(代表未来期望), 划掉后的期望仍然是无偏的
现在就是 \(\nabla_{\theta'} J(\theta') = E_{\tau \sim p_\theta(\tau)} \left[ \sum\limits_{t=1}^T \nabla_{\theta'} \log \pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t) \left( \prod\limits_{t'=1}^t \dfrac{\pi_{\theta'}(\mathbf{a}_{t'} | \mathbf{s}_{t'})}{\pi_\theta(\mathbf{a}_{t'} | \mathbf{s}_{t'})} \right) \left( \sum\limits_{t'=t}^T r(\mathbf{s}_{t'}, \mathbf{a}_{t'}) \right) \right]\) 了
一眼看过去, \(\prod\limits_{t'=1}^t \dfrac{\pi_{\theta'}(\mathbf{a}_{t'} | \mathbf{s}_{t'})}{\pi_\theta(\mathbf{a}_{t'} | \mathbf{s}_{t'})}\) 无法避免会迅速趋近于 0, 因为我们在 \(\theta\) 上做的采样, 肯定 \(\pi_\theta(\mathbf{a}_{t'} | \mathbf{s}_{t'}) > \pi_{\theta'}(\mathbf{a}_{t'} | \mathbf{s}_{t'})\)
不能直接删掉, 否则就是在说 "旧策略和新策略到达状态 \(\mathbf{s}_t\) 的概率是一模一样的"
也不能全保留, 那我们就近似, 用 \(\dfrac{\pi_{\theta'}(\mathbf{a}_t |
\mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)}\) 代替
\(\prod\limits_{t'=1}^t
\dfrac{\pi_{\theta'}(\mathbf{a}_{t'} |
\mathbf{s}_{t'})}{\pi_\theta(\mathbf{a}_{t'} |
\mathbf{s}_{t'})}\), 这代表: 只要我们在一次更新中保证新策略
\(\theta'\) 和旧策略 \(\theta\) 不要差得太远,
那么它们访问同一个状态 \(\mathbf{s}_t\)
的概率差不多是一样的
于是最终有 \(\nabla_{\theta'} J(\theta') = E_{\tau \sim p_\theta(\tau)} \left[ \sum\limits_{t=1}^T \nabla_{\theta'} \log \pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t) \left( \dfrac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} \right) \left( \sum\limits_{t'=t}^T r(\mathbf{s}_{t'}, \mathbf{a}_{t'}) \right) \right]\)
在代码中怎么实现 policy gradient?为了节约时间, 不能爆算 \(\log \pi_{\theta'}(\mathbf{a}_t |
\mathbf{s}_t)\) 这种东西
利用反向传播算法做, 我们希望构造出来一个图, 其梯度为 policy gradient
我们要计算 \(\nabla_\theta J(\theta)
\approx \dfrac{1}{N} \sum\limits_{i=1}^N \sum\limits_{t=1}^T
\nabla_\theta \log \pi_\theta(\mathbf a_{i,t}|\mathbf s_{i,t}) \hat
Q(i,t)\)
我们会算最大似然估计 \(\nabla_\theta
J_{ML}(\theta) \approx \dfrac{1}{N}
\sum\limits_{i=1}^N \sum\limits_{t=1}^T \nabla_\theta \log
\pi_\theta(\mathbf a_{i,t}|\mathbf s_{i,t})\)
于是, 对于最大似然估计, 有下面的 tensorflow 代码
1 | # Given: |
对于 policy gradient, 有
1 | # Given: |
我们的 policy gradient 方法有大方差的特点, 所以需要更大的 batch, 更多的超参微调
在这里简要提一下 Lecture 9 的内容 —— 高级策略梯度算法

以这张图为例, 蓝色小球(智能体)试图移动到黄色星星, 有奖励函数 \(r(\mathbf{s}_t, \mathbf{a}_t) = -\mathbf{s}_t^2 -
\mathbf{a}_t^2\)
根据策略 \(\log
\pi_\theta(\mathbf{a}_t|\mathbf{s}_t) =
-\dfrac{1}{2\sigma^2}(k\mathbf{s}_t - \mathbf{a}_t)^2 +
\text{const}\), 我们可以绘制策略梯度的更新向量场
为什么绝大多数箭头都极其强烈地垂直指向下方?因为相较于调整 \(k\) 来探索 \(\mathbf a_t\) 受到平方项惩罚,
不如直接把方差 \(\sigma\) 降到 \(0\), 这样会产生巨大的梯度,
智能体会迅速失去探索能力, 过早收敛
Natural
Actor-Critic 文章中不使用 \(\theta
\leftarrow \theta + \alpha\nabla_\theta J(\theta)\), 引入了
Fisher 信息矩阵, 现在的更新为 \[
\theta \leftarrow \theta+ \alpha F(\theta)^{-1} \nabla_\theta J(\theta)
\] 如果策略对某个参数 (比如 \(\sigma\)) 极其敏感, \(F(\theta)\) 中对应的值就会非常大, 取逆
\(F(\theta)^{-1}\) 后,
这个值就会变得非常小
这里的 \(\mathbf F = E_{\pi_\theta}
[\nabla_\theta \log \pi_\theta(\mathbf a|\mathbf s)\nabla_\theta \log
\pi_\theta(\mathbf a|\mathbf s)^{\top}]\), 相当于某种 "得分"
的外积, 其中 "得分" 是对数似然函数的梯度 , 告诉你为了让当前观测到的数据
\(x\) 出现的概率变大, 参数 \(\theta\) 应该往哪个方向调整
于是更新向量场变得更好了, 类似下图

Lecture 6 Actor-critic 方法
回顾 REINFORCE 算法:
- 从 \(\pi_\theta(\mathbf a_t | \mathbf s_t)\) 中采样 \(\{ \tau^i\}\) (运行 policy)
- 估计 \(\nabla_\theta J(\theta) \approx \sum_i \left(\sum_{t=1}^T \nabla_\theta \log \pi_\theta \left(\mathbf a_t^i|\mathbf s_t^i \right)\left(\sum_{t'=t}^T r(\mathbf s_{t'}^i,\mathbf a_{t'}^i) \right)\right)\)
- \(\theta \leftarrow \theta + \alpha\nabla_\theta J(\theta)\), 回到第一步
在这里估计 \(\nabla_\theta
J(\theta)\) 有很多种方法, 我们可以定义 \(\hat Q_{i,t} = \sum\limits_{t'=t}^T r(\mathbf
s_{t'}^i,\mathbf a_{t'}^i)\), 代表我们在 \(\mathbf s_{i,t}\) 采用 \(\mathbf a_{i,t}\) 的期望回报
这样估计不是最好的, 因为我们其实是在对一个非常复杂的期望进行单样本估计,
方差很大, 多样本估计会更好, 即 \[
Q(\mathbf s_t, \mathbf a_t) = \sum_{t'=t}^T E_{\pi_\theta}
[r(\mathbf s_{t'}, \mathbf a_{t'})|\mathbf s_t, \mathbf a_t]
\] 再考虑减去基线 \(V(\mathbf{s}_{i,
t})\), 其中 \(V(\mathbf s_t) =
E_{\mathbf a_t \sim \pi_\theta(\mathbf a_t|\mathbf s_t)}[Q(\mathbf s_t,
\mathbf a_t)]\)
于是 \(\nabla_{\theta} J(\theta) \approx \dfrac{1}{N} \sum\limits_{i=1}^{N} \sum\limits_{t=1}^{T} \nabla_{\theta} \log \pi_{\theta}(\mathbf{a}_{i, t} | \mathbf{s}_{i, t}) \left(Q(\mathbf{s}_{i, t}, \mathbf{a}_{i, t}) - V(\mathbf{s}_{i, t})\right)\)
我们可以再抽象一层, 令 \(A(\mathbf{s}_{i, t}, \mathbf{a}_{i, t}) = Q(\mathbf{s}_{i, t}, \mathbf{a}_{i, t}) - V(\mathbf{s}_{i, t})\), 称作优势函数(adventage function)
再总结一下, 现在抽象层套太多了
\(Q^\pi(\mathbf{s}_t, \mathbf{a}_t) = \sum_{t'=t}^{T} E_{\pi_\theta} [r(\mathbf{s}_{t'}, \mathbf{a}_{t'}) | \mathbf{s}_t, \mathbf{a}_t]\), 动作价值函数, 在状态 \(\mathbf{s}_t\) 下采取动作 \(\mathbf{a}_t\) 所获得的总奖励
\(V^\pi(\mathbf{s}_t) = E_{\mathbf{a}_t \sim \pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} [Q^\pi(\mathbf{s}_t, \mathbf{a}_t)]\), 状态价值函数, 从状态 \(\mathbf{s}_t\) 开始所获得的总奖励
\(A^\pi(\mathbf{s}_t, \mathbf{a}_t) = Q^\pi(\mathbf{s}_t, \mathbf{a}_t) - V^\pi(\mathbf{s}_t)\), 优势函数, 代表动作 \(\mathbf{a}_t\) 比平均水平好多少
我们在做的事主要是降低方差, 原始式子( \(\sum\limits_{t'=t}^T r(\mathbf s_{t'}^i,\mathbf a_{t'}^i) - b\) )是无偏估计的但是方差大, 我们希望拿一些微小的偏移来降低方差
强化学习算法通常由生成样本, 学习模型/拟合回归, 改进 policy 三个部分构成, 这三个部分会不断循环
那么我们应该拟合什么?\(Q, V, A\) 都拟合吗?
有 \(Q^\pi(\mathbf{s}_t, \mathbf{a}_t) = r(\mathbf{s}_t, \mathbf{a}_t) + E_{\mathbf s_{t+1} \sim p(\mathbf s_{t+1}|\mathbf s_t, \mathbf a_t)} [V^\pi(\mathbf{s}_{t+1})] \approx r(\mathbf{s}_t, \mathbf{a}_t) + V^\pi(\mathbf{s}_{t+1})\), 只包含一步真实采样的随机
于是还有 \(A^\pi(\mathbf{s}_t, \mathbf{a}_t) \approx r(\mathbf{s}_t, \mathbf{a}_t) + V^\pi(\mathbf{s}_{t+1}) - V^\pi(\mathbf{s}_t)\)
于是拟合 \(V^\pi\) 就行了, 而且 \(V\) 不依赖于动作 \(\mathbf a\), 只依赖于状态 \(\mathbf s\), 于是我们可以构建神经网络, 其参数为 \(\phi\), 完成 \(\mathbf s\) 到 \(\hat V^\pi(\mathbf s)\) 的映射, 因为强化学习目标可以表示为初始状态分布上价值函数的期望, 于是有 \(J(\theta) = E_{\mathbf s_1 \sim p(\mathbf s_1)}[V^\pi(\mathbf s_1)]\)
寻找 \(V^\pi(\mathbf s_t)\) 的过程称作策略评估(policy evaluation), 一种方式是上蒙特卡洛(单样本估计), 一般用上文的单步时序差分目标 (1-step TD Target) 就行了, 我们的目标 \(V_{target} = r_t + \gamma V_\phi(\mathbf s_{t+1})\), 这比 "网络当前步的评估" 更接近事实, 损失就是 \(Loss = (V_{target} - V_\phi(\mathbf s_t))^2\), 这里的 \(\gamma\) 就是平衡未来的折扣因子
在作业中, 我们会实现 GAE 方法, 把 1 步、2 步、3 步, 一直到无穷或回合结束 \(T\) 步的 TD 估计全部结合起来, 然后加一个超参 \(\lambda\) 来平衡权重
一个基本的 (batch) Actor-critic 算法的流程如下:
- 从 \(\pi_\theta(\mathbf a_t | \mathbf s_t)\) 中采样 \(\{\mathbf s_i, \mathbf a_i \}\) (运行 policy)
- 拟合 \(\hat V_{\phi}^\pi(\mathbf s)\) 到采样奖励上
- 对于每个采样的动作对, 计算近似优势 \(\hat A^\pi(\mathbf s_i, \mathbf a_i) = r(\mathbf s_i, \mathbf a_i) + \hat V_{\phi}^\pi(\mathbf s'_i) -\hat V_{\phi}^\pi(\mathbf s_i)\)
- 估计 \(\nabla_\theta J(\theta) \approx \sum_i \ \nabla_\theta \log \pi_\theta \left(\mathbf a_i|\mathbf s_i \right) \hat A^\pi(\mathbf s_i, \mathbf a_i)\)
- \(\theta \leftarrow \theta + \alpha\nabla_\theta J(\theta)\), 回到第一步
这里的 \(\pi_\theta(\mathbf a | \mathbf
s)\) 就是我们的 actor, 它的目标是学习到一个最优策略,
使得智能体在长期内获得最多的奖励
对于第二步的拟合方法, 我们可以蒙特卡洛, 引导估计
对于无限时域的引导估计, 仿照 \(V_{target}\) 加入 \(\gamma\), 相当于为 MDP 状态转移加了一个
\(1-\gamma\) 概率到达的死亡状态
这里还有一些式子推导待补, 折扣因子的添加很有讲究, 我们有时候希望任务(eg. 机器人行走)无限运行, 所以我们不是想要一个折扣问题, 而是利用折扣获得 \(\nabla_\theta J(\theta)\) 的有限估计
在引入折扣后, actor-critic 算法的第三步改变为 \(\hat A^\pi(\mathbf s_i, \mathbf a_i) = r(\mathbf s_i, \mathbf a_i) + \gamma \hat V_{\phi}^\pi(\mathbf s'_i) -\hat V_{\phi}^\pi(\mathbf s_i)\)
我们也可以写出 online actor-critic 算法了

在实现上, 有一些方法可以选择
- 两个网络分别拟合 \(\hat V_\phi^\pi(\mathbf s), \pi\), 这样简单稳定易训练, 但是 actor 与 critic 中间没有共享特征
- 一个 shared network, 更高效, 但是需要更好的 tuning
对于第二步, 我们不希望用单样本, 而是使用一个 batch, 于是我们使用多个模拟器(并行化), 给它们不同的初始种子, 同步更新策略, 然后重复这个过程
这叫做同步并行(synchronized parallel)方法, 我们自然想到异步(asychronous)方法, 但是如果线程落后了, actor 不一样怎么办?经验证明, 它带来的性能提升超过了略微滞后带来的偏差

既然可以稍稍滞后, 能不能直接 off-policy
呢?我们可以弄一个回放缓冲区(replay buffer)
具体来说, 我们只使用一个线程, 我们把转移都保存进 replay buffer 中,
每次从里面采样整个 batch
但这样 actor
会不会太老了?我们可以把缓冲区建成一个先进先出的结构(环形队列),
这可以稍稍缓解问题

你注意到这个算法的问题吗?Replay buffer 带来了什么坏处
首先, 在第三步, \(\mathbf s_i'\) 是较老的 actor 出来的, 我们一路把旧数据带入 \(\nabla_\theta J(\theta)\) 的计算, 这不是当前的 \(\pi_\theta\), 我们可以采用重要性采样来修正
对于第三步, 如果让 \(\hat{V}_\phi^\pi(\mathbf s_i)\) 接近 \(y_i\), 那么第四步 \(\hat A^\pi(\mathbf s_i, \mathbf a_i)\)
就趋近于 0 了, 没得学
于是我们改为学习 \(\hat{Q}_\phi(\mathbf s_i,
\mathbf a_i)\), 这里注意没有假设 \(\mathbf a_i\) 来自 \(\mathbf s_i\)
这里的直觉是, \(V^\pi(\mathbf s)\) 是 \(Q^\pi(\mathbf s,\mathbf a)\) 在当前策略分布下的期望, 而拿期望去训练优势函数没用, 因为其为 0
于是第三步变为使用 \(y_i = r_i + \gamma
\hat Q_\phi^\pi(\mathbf s_i', \mathbf a_i')\) 对于各个
\(\mathbf s_i, \mathbf a_i\) 来更新
\(\hat Q_\phi^\pi\), 这里的 \(\mathbf a_i'\) 是从 \(\pi_\theta(\mathbf a_i' | \mathbf
s_i')\) 中采样得到的
我们利用了 policy \(\pi_\theta\),
本质上我们在假设如果遇到了 \(\mathbf
s_i'\), 它会怎么做
这样, 我们的第四步也要对应变为 \(\hat A^\pi(\mathbf s_i, \mathbf a_i) = Q(\mathbf s_i, \mathbf a_i) - \hat V_\phi^\pi(\mathbf s_i)\)
对于第五步, 我们也可以用同样的 trick, 我们不从 replay buffer 中生硬拿出 \(\mathbf a_i, \mathbf s_i\) 说是 \(\pi_\theta\) 估计的, 相反, 我们让 \(\pi_\theta\) 自己从 \(\mathbf s_i\) 得到 \(\mathbf a_i^\pi\), 于是 \(\nabla_\theta J(\theta) \approx \frac{1}{N}\sum_i \ \nabla_\theta \log \pi_\theta \left(\mathbf a_i^\pi|\mathbf s_i \right) \hat A^\pi(\mathbf s_i, \mathbf a_i^\pi)\)
在实践中, 我们用 \(\nabla_\theta J(\theta) \approx \frac{1}{N}\sum_i \ \nabla_\theta \log \pi_\theta \left(\mathbf a_i^\pi|\mathbf s_i \right) \hat Q^\pi(\mathbf s_i, \mathbf a_i^\pi)\), 这样方差更高(没有减去 baseline), 但是常常更好, 这是个复杂的问题, 我们通过高方差换来了什么?首先我们完全把 \(V\) 扬掉了, 少训一个网络, 然后这个高方差可以稍微通过从 \(\mathbf s_i\) 多采样几次 \(\mathbf a_i\) 来控制(工程经验, 不是数学上的)

于是得到了最终的 online actor-critic 算法, 在数学上,
它当然不是完美的, 我们的 \(\mathbf a\)
可以从 \(\pi_\theta(\mathbf s)\) 采样,
但我们的 \(\mathbf s\) 仍然来自 replay
buffer
在这里重要性采样救不了, lecture 9 也会提及, 因为策略是自己定的,
而状态分布是未知环境决定的
于是我们直接忽略, 啊哈哈, 在线强化学习(Online
RL)就是好啊, Buffer 里的状态分布 \(p_\beta(\mathbf{s})\)
在缓慢地向当前策略分布 \(p_\theta(\mathbf{s})\) 靠近,
等到离线强化学习(Offline RL)领域再着急这个问题吧
在这里估计 Q 函数有很多技巧, 会在之后的课程详细学习,
一个技巧是重参数化, \(a \sim \mathcal{N}(\mu,
\sigma^2)\) 把反向传播的梯度斩断了, 我又不想算 \(\nabla \log \pi\), 于是我们可以单独采样噪声
\(\epsilon \sim \mathcal{N}(0, 1)\),
这样 \(a = \mu + \sigma \odot
\epsilon\) 就可以把梯度传进去了, 这部分内容会在 Assignment 3
中使用, 连续空间采样时需要 .rsample() 来传梯度
然后我们讲讲如何使用 Critic 作为 Baseline
对于 actor-critic 算法(低方差, 有偏估计) \[
\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^N \sum_{t=1}^T
\nabla_\theta \log \pi_\theta(\mathbf{a}_{i,t}|\mathbf{s}_{i,t}) \left(
r(\mathbf{s}_{i,t}, \mathbf{a}_{i,t}) + \gamma
\hat{V}_\phi^\pi(\mathbf{s}_{i,t+1}) -
\hat{V}_\phi^\pi(\mathbf{s}_{i,t}) \right)
\] 对于 Policy gradient (高方差, 无偏估计) \[
\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^N \sum_{t=1}^T
\nabla_\theta \log \pi_\theta(\mathbf{a}_{i,t}|\mathbf{s}_{i,t}) \left(
\left( \sum_{t'=t}^T \gamma^{t'-t} r(\mathbf{s}_{i,t'},
\mathbf{a}_{i,t'}) \right) - b \right)
\] 我想要一个中低方差 + 无偏估计, 于是有 \[
\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^N \sum_{t=1}^T
\nabla_\theta \log \pi_\theta(\mathbf{a}_{i,t}|\mathbf{s}_{i,t}) \left(
\left( \sum_{t'=t}^T \gamma^{t'-t} r(\mathbf{s}_{i,t'},
\mathbf{a}_{i,t'}) \right) - \hat{V}_\phi^\pi(\mathbf{s}_{i,t})
\right)
\] 为什么这样奏效?因为 \(\hat{V}_\phi^\pi(\mathbf{s}_{i,t})\) 作为
baseline 不依赖于 \(\mathbf
a_{i,t}\)
如果我们的基线想要依赖于动作呢?理论上我引入的越多, 方差就越低
首先, \(\hat{A}^\pi(\mathbf{s}_t,
\mathbf{a}_t) = \sum_{t'=t}^\infty \gamma^{t'-t}
r(\mathbf{s}_{t'}, \mathbf{a}_{t'}) -
V_\phi^\pi(\mathbf{s}_t)\) 肯定是对的, 但是单次采样方差太大
于是尝试使用 \(\hat{A}^\pi(\mathbf{s}_t,
\mathbf{a}_t) = \sum_{t'=t}^\infty \gamma^{t'-t}
r(\mathbf{s}_{t'}, \mathbf{a}_{t'}) - Q_\phi^\pi(\mathbf{s}_t,
\mathbf{a}_t)\), 如果我们的 Critic 训练得非常准确,
那么采样得到的回报和预测的 \(Q\)
值会非常接近, 这样在期望上为 0, 但是 \(Q(\mathbf{s}_t, \mathbf{a}_t)\) 含 \(\mathbf a_t\) 所以不准
最后 2016 年的 Q-Prop
方法提出可以先减去 Q 再做偏差修正拉回来, 有 \[
\nabla_\theta J(\theta) \approx \frac{1}{N} \sum_{i=1}^N \sum_{t=1}^T
\nabla_\theta \log \pi_\theta(\mathbf{a}_{i,t}|\mathbf{s}_{i,t}) \left(
\hat{Q}_{i,t} - Q_\phi^\pi(\mathbf{s}_{i,t}, \mathbf{a}_{i,t}) \right) +
\frac{1}{N} \sum_{i=1}^N \sum_{t=1}^T \nabla_\theta E_{\mathbf{a} \sim
\pi_\theta(\mathbf{a}_t|\mathbf{s}_{i,t})} \left[
Q_\phi^\pi(\mathbf{s}_{i,t}, \mathbf{a}_t) \right]
\] 我们故意减去了依赖动作的 \(Q_\phi^\pi\), 再在后面加回了 \(Q_\phi^\pi\) 在当前策略下的期望梯度
这其实非常有用, 比起采样状态需要与环境交互的困难性,
有了状态采样动作可太容易了
如果我们能接受一些有偏估计, 或者能做一些 偏差-方差 的 trade-off
呢?这就是 GAE
的思想
Actor-Critic 中的优势估计 \(\hat{A}^\pi_{\text{C}}(\mathbf{s}_t, \mathbf{a}_t)
= r(\mathbf{s}_t, \mathbf{a}_t) + \gamma
\hat{V}^\pi_\phi(\mathbf{s}_{t+1}) -
\hat{V}^\pi_\phi(\mathbf{s}_t)\) 是单步的
而 policy-gradient 中的蒙特卡洛估计 \(\hat{A}^\pi_{\text{MC}}(\mathbf{s}_t,
\mathbf{a}_t) = \sum_{t'=t}^\infty \gamma^{t'-t}
r(\mathbf{s}_{t'}, \mathbf{a}_{t'}) -
\hat{V}^\pi_\phi(\mathbf{s}_t)\) 是无穷步的
于是 trade-off, 尝试 n 步估计, \(\hat{A}^\pi_n(\mathbf{s}_t, \mathbf{a}_t) =
\sum_{t'=t}^{t+n} \gamma^{t'-t} r(\mathbf{s}_{t'},
\mathbf{a}_{t'}) - \hat{V}^\pi_\phi(\mathbf{s}_t) + \gamma^n
\hat{V}^\pi_\phi(\mathbf{s}_{t+n})\)
这相当于在某个时间步上做截断, 前面压偏差, 后面给方差
那么 n 到底选多少呢?事实上在 GAE 中我们都选了, 把所有可能的 \(n\) 步优势估计 \(A_n^{\pi}(\mathbf s_t, \mathbf a_t)\)
全都算出来, 然后给它们做一个加权平均, 这部分在 Assignment 2 中会再次提及
\[
\hat A_{GAE}^{\pi}(\mathbf s_t, \mathbf a_t) =
\underbrace{\frac{1-\lambda^{T-t-1}}{1-\lambda}}_{\text{归一化常数}}
\sum_{n=1}^{T-t-1} \underbrace{\lambda^{n-1}}_{\text{指数衰减}}
\underbrace{A_n^{\pi}(\mathbf s_t, \mathbf a_t)}_{\text{各个 n
步的优势估计}}
\] 这里的 \(\lambda\) 和折扣因子
\(\gamma\) 其实很像
我们的 Actor-Critic 方法也可以视作方差显著降低的 policy gradient
Lecture 7 价值函数方法
一个直觉是, 价值函数告诉我们哪些状态比另外一些状态更好, 我们是否可以忽略梯度, 直接学习进入更好状态的动作, 而不需要一个显式的策略神经网络?
我们形式化表达一下, \(A^\pi(\mathbf s_t, \mathbf a_t)\) 表示 \(\mathbf a_t\) 比 \(\pi\) 上的平均动作好多少, 于是我直接 \(\arg \max_{\mathbf a_t}A^\pi(\mathbf s_t, \mathbf a_t)\) 就得到了最佳动作, 这个 \(\arg \max\) 很理想化的忽略了 \(\pi\), 它对任意策略有用并且能求到最优
我们隐式构建新的策略 \(\pi'(\mathbf{a}_t|\mathbf{s}_t) = \begin{cases} 1, \text{ if } \mathbf{a}_t = \arg\max_{\mathbf{a}_t} A^\pi(\mathbf{s}_t, \mathbf{a}_t) \\ 0, \text{ otherwise} \end{cases}\) , 在给定的状态 \(\mathbf{s}_t\) 下, 新的策略 \(\pi'\) 会 100% 选择那个能让优势函数 \(A^\pi(\mathbf{s}_t, \mathbf{a}_t)\) 最大化的动作, 更新策略就直接 \(\pi \leftarrow \pi'\)
这就叫做策略迭代(policy iteration), 一共两步循环进行: 估计 \(A^\pi(\mathbf s, \mathbf a)\), 使用 \(\pi \leftarrow \pi'\) 更新
一如既往的, 我们忽略了许多细节处理, \(\arg \max\) 在处理离散动作时枚举过去就行了, 在连续动作时怎么办, 同时我们 \(\pi'\) 也太贪婪了, 没啥探索
我们先假设是离散动作, 先估计 \(A^\pi(\mathbf s, \mathbf a) = r(\mathbf s, \mathbf a) + \gamma E[V^\pi(\mathbf s')] - V^\pi(\mathbf s)\), 这很像单步估计, 但是假设我们知道期望, 这虽然有偏(来自 \(V^\pi(\mathbf s)\)), 但是方差极小, 于是我们要估计 \(V^\pi(\mathbf s)\)
假设我们知道 \(p(\mathbf s'|\mathbf s, \mathbf a)\), \(\mathbf s, \mathbf a\) 都是离散且较小的, 我们下文以在小型 2D 网格中的移动举例

我可以存储整个 \(V^\pi(\mathbf s)\), \(\mathcal T\) 代表从 16 个起点中的任意一个, 采取 4 种动作(上下左右)中的任意一个, 到达 16 个终点中的任意一个的概率
我们可以自举(bootstrapped)更新 \(V^\pi(\mathbf{s}) \leftarrow E_{\mathbf{a} \sim \pi(\mathbf{a}|\mathbf{s})}[r(\mathbf{s}, \mathbf{a}) + \gamma E_{\mathbf{s'} \sim p(\mathbf{s'}|\mathbf{s}, \mathbf{a})}[V^\pi(\mathbf{s'})]]\), 这是我们的贝尔曼期望方程, \(p(\mathbf s'|\mathbf s, \mathbf a)\) 才是动态规划的状态转移方程
\(V^\pi(\mathbf s)\)
的更新对环境随机性与策略随机性都进行了平滑, 但是 \(\gamma\) 与 \(\arg \max\) 又弥补了这一点
在得到 \(V^\pi(\mathbf s)\) 后, 由于求
\(\arg \max\) 操作,
我们会学习到一个确定性策略 \(\pi(\mathbf s) =
\mathbf a\),
化简一下, 其实只用 \(V^\pi(\mathbf{s})
\leftarrow r(\mathbf{s}, \pi(\mathbf s)) + \gamma E_{\mathbf{s'}
\sim p(\mathbf{s'}|\mathbf{s}, \pi(\mathbf
s))}[V^\pi(\mathbf{s'})]\) 就行了
我们能够通过巴拿赫不动点定理证明这样的迭代一定能够收敛到唯一的不动点 \(V^\pi\)
由于 \(\arg \max_{\mathbf a_t}A^\pi(\mathbf s_t, \mathbf a_t) = \arg \max_{\mathbf a_t}Q^\pi(\mathbf s_t, \mathbf a_t)\), 我们可以做 \(Q(\mathbf{s}, \mathbf{a}) \leftarrow r(\mathbf{s}, \mathbf{a}) + \gamma E[V(\mathbf{s}')]\)
以前是 \(V^\pi(\mathbf{s}) \leftarrow
r(\mathbf{s}, \pi(\mathbf s)) + \gamma E_{\mathbf{s'} \sim
p(\mathbf{s'}|\mathbf{s}, \pi(\mathbf
s))}[V^\pi(\mathbf{s'})]\) 后更新 \(\pi \leftarrow \pi'\)
现在是 \(Q(\mathbf{s}, \mathbf{a}) \leftarrow
r(\mathbf{s}, \mathbf{a}) + \gamma E[V(\mathbf{s}')]\) 后更新
\(V^\pi(\mathbf{s}) \leftarrow
\max_{\mathbf{a}} Q^\pi(\mathbf{s}, \mathbf{a})\),
反正我们的策略是绝对贪心的策略, 不如直接更新价值函数,
这种方式叫做价值迭代(value iteration), 是 Q-learning
的理论前身
在这里提及一下 Q-learning 的思想, 因为 \(V\) 只在第一步期望时出现, 我们直接用 \(Q(\mathbf s, \mathbf a) = r(\mathbf s, \mathbf a)
+ \gamma E[\max_{\mathbf a'} Q(\mathbf s', \mathbf
a')]\) 一步到位了, 我把 \(V\) 一扔掉, 连环境模型 \(p\) 都不要了, model-free 了
现实世界一般也不知道转移模型, \(E_{\mathbf{s}' \sim P(\cdot|\mathbf{s}_i, \mathbf{a}_i)}[V(\mathbf{s}'_i)] = \sum_{\mathbf{s}' \in \mathcal{S}} P(\mathbf{s}' | \mathbf{s}_i, \mathbf{a}_i) \cdot V(\mathbf{s}')\), 你能知道 \(P(\mathbf{s}' | \mathbf{s}_i, \mathbf{a}_i)\) 的情况极少出现
我们引入一点神经网络, 现在仅考虑离散的状态情况
离散情况下我们自然想到表格来表示 \(V(\mathbf
s)\), 可惜对于大多数情况这不可行, 例如 \(\mathbf s\) 是一张图片或更大的情况,
这会带来维度灾难
所以我们引入网络来表示 \(\mathbf s \to
V(\mathbf s)\) 的映射, 这个网络有参数 \(\phi\), 定义损失 \(\mathcal L(\phi) = \dfrac{1}{2} \| V_\phi(\mathbf
s) - \max_{\mathbf a} Q^\pi(\mathbf s, \mathbf a) \|^2\)
于是我们的算法为

这种算法首先需要我们计算第一步的期望, 然后需要我们能从同一状态 \(\mathbf s\) 产生不同的动作 \(\mathbf a\), 先看第二个问题
我想模仿我们之前的自举更新, 构造一个 Q 函数递归, \(Q^\pi(\mathbf s, \mathbf a) \leftarrow r(\mathbf
s, \mathbf a) + \gamma E_{\mathbf{s'} \sim
p(\mathbf{s'}|\mathbf{s}, \mathbf a)}[Q^\pi(\mathbf{s'},
\pi(\mathbf s'))]\)
这里的微妙变化是我使用 \(\mathbf s, \mathbf
a\) 对来更新。\(V\) 函数使用
\(r(\mathbf s, \pi(\mathbf s))\)
是因为定义规定第一步的策略必须听从 \(\mathbf
s\), 而这里我使用 \(\mathbf s, \mathbf
a\) 来更新 \(Q\) 就可以自由输入
\(\mathbf a\) 了
再看第一个问题, 我们也可以利用 \(\max\) trick 把期望尝试摘掉, 既然 \(\mathbf y_i \leftarrow \max_{\mathbf a_i} (\cdots)\), 我不如推导 \(E[V(\mathbf{s}'_i)] \approx V(\mathbf{s}'_i)= \max_{\mathbf{a}'} Q_\phi(\mathbf{s}'_i, \mathbf{a}'_i)\), 这里的期望 \(E\) 是对环境状态转移的随机性求期望, 然后直接 \(\mathbf{y}_i \leftarrow r(\mathbf{s}_i, \mathbf{a}_i) + \gamma \max_{\mathbf{a}'} Q_\phi(\mathbf{s}'_i, \mathbf{a}'_i)\), 这就是拟合 Q 迭代(fitting Q iteration)

这个算法对 off-policy 有效, 只有一个 Q 网络, 方差低,
但是它对任何非线性函数没有任何收敛保证
完整的算法思路如下, 我们的 K 次迭代是为了让奖励回溯传播

让我们从 Q-Iteration 走向 Q-learning
我们可以想象 Q-Iteration 在 \(\mathbf s,
\mathbf a\) 转移数据对上进行迭代

Q-Iteration 在求 max 的步骤优化策略, 第三步是在优化误差 \(\mathcal E\) \[ \mathcal{E} = \frac{1}{2} E_{(\mathbf{s}, \mathbf{a}) \sim \beta} \left[ \left( Q_\phi(\mathbf{s}, \mathbf{a}) - [r(\mathbf{s}, \mathbf{a}) + \gamma \max_{\mathbf{a}'} Q_\phi(\mathbf{s}', \mathbf{a}')] \right)^2 \right] \] 当 \(\mathcal E = 0\) 时, 等价于 \(Q_\phi(\mathbf{s}, \mathbf{a}) = r(\mathbf{s}, \mathbf{a}) + \gamma \max_{\mathbf{a}'} Q_\phi(\mathbf{s}', \mathbf{a}')\), 这是最优的 Q 函数, 它对应最优策略 \(\pi'\) 当 \(\mathcal E \neq 0\) 时, 收敛保证会丢失
如果使用 online Q-Iteration, 收集一次数据就拟合一次, 这样可能更加不稳定
我们的策略 \(\pi'(\mathbf{a}_t|\mathbf{s}_t) = \begin{cases} 1, \text{ if } \mathbf{a}_t = \arg\max_{\mathbf{a}_t} A^\pi(\mathbf{s}_t, \mathbf{a}_t) \\ 0, \text{ otherwise} \end{cases}\), 如前所述, 这也太贪婪了, 这个策略是确定性的, 如果初始 Q 函数太烂, 可能跑不出去, 我们可以注入一些随机性, 例如 \[ \pi'(\mathbf{a}_t|\mathbf{s}_t) = \begin{cases} 1-\epsilon, \text{ if } \mathbf{a}_t = \arg\max_{\mathbf{a}_t} A^\pi(\mathbf{s}_t, \mathbf{a}_t) \\ \epsilon/(|\mathcal A|-1), \text{ otherwise} \end{cases} \] 啊, 这种随机性在实践中都可以退火, 这个也是
另一种方式是设置 \(\pi'(\mathbf a_t|\mathbf s_t) \propto \exp(Q_\phi(\mathbf s_t, \mathbf a_t))\), 指数化同时奖励多个类似概率的最好动作, 可能更有用, 后面的 Lec 会遇到的
最后我们介绍一些基于价值函数的理论, 讨论一下收敛性
在 value iteration 中, 第一步 \(Q(\mathbf
s, \mathbf a) \leftarrow r(\mathbf s, \mathbf a) + \gamma E[V(\mathbf
s')]\), 第二步 \(V(\mathbf s)
\leftarrow \max_{\mathbf a} Q(\mathbf s, \mathbf a)\)
我们定义贝尔曼算子 \(\mathcal B\), 有
\(\mathcal{B}V = \max_{\mathbf{a}}
(r_{\mathbf{a}} + \gamma \mathcal{T}_{\mathbf{a}} V)\),
如果你记忆力还行的化就记得这里的 \(\mathcal{T}_{\mathbf{a}}\) 是动作 \(\mathbf{a}\) 的转移矩阵, \(\mathcal{T}_{\mathbf{a},i,j} = p(\mathbf{s}'=i
| \mathbf{s}=j, \mathbf{a})\), 而这里的 \(r_{\mathbf{a}}\) 是所有状态下执行动作 \(\mathbf{a}\)
得到的奖励向量, 最后我们做逐元素 max
如果 \(V^\star\) 是 \(\mathcal B\) 的不动点, 则 \(V^\star = \mathcal{B}V^\star\), 我们下面证明 \(V^\star\) 始终存在, 唯一, 并对应最优策略
我们证明的思路是证明 \(\mathcal B\) 是一个压缩映射, 对于任意 \(V, \bar V\), 有 \(\| \mathcal BV - \mathcal B \bar V \|_\infty \leq \gamma \| V - \bar V \|_\infty\), 我们用 \(V^\star\) 代替 \(\bar V\) 就可以无限接近 \(V^\star\)
所以 value iteration 就是 \(V \leftarrow \mathcal BV\) 的无限循环
在 fitted value iteration 中, 第二步 \(\phi \leftarrow \arg \min_\phi \dfrac{1}{2} \sum_i \| V_\phi(\mathbf s) - \max_{\mathbf a} Q^\pi(\mathbf s, \mathbf a) \|^2\) 训练神经网络
如果价值函数是一个神经网络, 那么我拥有一个连续集合包含 [所有特定架构但是不同权重的可能神经网络], 我们使用 \(\Omega\) 来表示这个集合, 也叫做假设空间。我们的监督学习在这个空间内找一个优化目标(即平方差)的元素(网络参数), 所以 fitted value iteration 可以抽象为 \[ V' \leftarrow \arg \min_{V' \in \Omega} \frac{1}{2} \sum \| V'(\mathbf s) - (\mathcal BV)(\mathbf s) \| ^2 \] 所以监督学习可以看作是在 L2 空间上的投影

\(\mathcal BV\) 是偏离 \(\Omega\) 的, 因为神经网络大小有限,
我们需要投影到 \(\Omega\) 上的 \(V'\) 点, 这个操作可以抽象出投影算子
\(\Pi\)
\(\Pi\) 也是收缩算子, 定义在 L2 距离上,
我们自然认为 \(\Pi \mathcal B\)
是收缩算子, 但实际上并不是, 它们定义在不同的范数上
我们想象 \(\mathcal BV\) 使得我们距离
\(V^\star\) 更近, 但是投影后 \(V'\) 却离 \(V^\star\) 更远了

一个悲伤的事实是, fitted value iteration 不仅理论上不收敛, 实际上也常常不收敛
同理, fitted Q iteration 也不收敛, 一个常见疑问是 online Q iteration
很像梯度迭代下降, 为什么不收敛?
因为我们的梯度是自举得到的, 它的数值特性并不好。再回顾一下, actor-critic
使用了两种范数, 也不收敛
聪明的你早就有这个直觉了, 价值迭代把整个 \(V(\mathbf s)\) 表都背下来了, fitted value iteration 只有一个神经网络来面对真实世界的复杂性, 我们还是要用 fitted value iteration, 我们需要使用一些 trick 让这些算法跑起来
Lecture 8 深度强化学习方法
基于价值函数的方法不能保证收敛, 但是确实有用,
本节课将深入这一方法
上文提到, online Q-Iteration, 收集一次数据就拟合一次, 这样可能不稳定,
它的算法流程如下

我们可以一步展开, 有 \[
\phi \leftarrow \phi - \alpha \frac{dQ_\phi}{d\phi}(\mathbf{s}_i,
\mathbf{a}_i) (Q_\phi(\mathbf{s}_i, \mathbf{a}_i) -
\color{red}{[r(\mathbf{s}_i, \mathbf{a}_i) + \gamma
\max_{\mathbf{a}'} Q_\phi(\mathbf{s}_i', \mathbf{a}_i')]})
\] 我们可能误认为这里在使用梯度下降, 但其实不是, 对于 \(\mathbf y_i\) 中的 \(Q_\phi\) 我们是当常数值处理的
这里的另一个问题是收集的数据高度相关, 按照这个循环, 我们训练 \((\mathbf{s}_1, \mathbf{a}_1, \mathbf{s}_2, r_1),
(\mathbf{s}_2, \mathbf{a}_2, \mathbf{s}_3, r_2), \dots\)
网络可能会对当前的局部状态空间严重过拟合
对于相关性问题, 我们可以使用 actor-critic 架构中的同步并行与异步并行方法
我们也可以用 replay buffer, 我不是说回到 full fitted Q iteration,
这里是有区别的
replay buffer 属于在线或半在线算法, buffer 是动态的,
通常使用滑动窗口法
而 fitted Q iteration 是离线算法, 智能体不与环境交互, 有了数据集,
把问题变成监督学习问题

我们需要定期向 buffer \(\mathcal B\) 中提供数据, 使用不同的策略从现实世界(环境)带来新的数据

可以将这个方法与 fitted Q iteration 结合, 得到一个朴素的 DQN 算法

我们还没有处理 "半梯度" 的问题, 而且其目标 \(\mathbf y_i\) 是依靠 \(\phi\) 自举的, 会不断移动
我们一进行第三步更新 \(\phi\) 时,
目标就移动了, 一个直觉是把 \(\phi\)
固定下来认真学习
我们固定下来的 \(\phi\)
就叫做目标网络(target network)

可以选择 \(N=10000, K=1 \sim 4\)
左右, 这样会让训练更稳定
经典 DQN 算法如下
- 采取动作 \(\mathbf a_i\) 并观察结果 \((\mathbf s_i, \mathbf a_i, \mathbf s'_i, r_i)\), 将其存入 \(\mathcal{B}\)
- 从 \(\mathcal{B}\) 中均匀(uniform)采样一个小批次 \(\{\mathbf s_j, \mathbf a_j, \mathbf s'_j, r_j\}\)
- 使用目标网络 \(Q_{\phi'}\) 计算 \(y_j = r_j + \gamma \max_{\mathbf{a}'_j} Q_{\phi'}(\mathbf s'_j, \mathbf a'_j)\)
- 更新在线网络 \(\phi \leftarrow \phi - \alpha \sum_j \dfrac{dQ_\phi}{d\phi}(\mathbf s_j, \mathbf a_j)(Q_\phi(\mathbf s_j, \mathbf a_j)-y_j)\)
- 每隔 \(N\) 步, 将 \(\phi\) 的参数复制给 \(\phi'\)
事实上这就是 K=1 时的算法
对于目标函数的处理, 除了 \(N\)
步一刀切, 也可以使用其他方法
\(N\) 步一刀切的坏处在于接近 \(N\) 步时的更新严重滞后, 我们可以使用 \(\phi' \leftarrow \tau \phi' +
(1-\tau)\phi\) 来更新, 其中 \(\tau
=0.999\), 这是 polyak 平均的思想,
和做梯度下降时那堆带动量的方法类似?
\(N\) 轮一刀切叫做硬更新, 每次 \(\phi' \leftarrow \tau \phi' + (1-\tau)\phi\) 靠近叫做软更新, 软更新含有少量的自举, 但是消除了滞后, 是目前的主流做法, 虽然每次是 \(O(N)\) 的, 但是比前向传播或反向传播 \(O(N^2)\) 或 \(O(N^3)\) 的开销小很多
总结一个整体的 Q-learning 框架, 由下图三个步骤组成

online Q-learning 在三个步骤上保持统一速度
DQN 在第一步和第三步上同速, 第二步更新 target network 比较慢
Fitted Q-iteration 中第三步是第二步的内循环, 第二步是第一步的内循环
下面介绍一些 Q-learning 的工程技巧
Q 函数本身就是一种对总奖励的预测, 在 Atari 游戏的测试中, 我们发现 Q 函数的预测会随着训练的进行而上升, 这是合理的
但是在 DQN 训练中, 我们常常发现 Q 函数的预测大于实际获得的回报
这种过高估计的原因来自目标函数 \(y_j = r_j +
\gamma \max_{\mathbf{a}'_j} Q_{\phi'}(\mathbf s'_j, \mathbf
a'_j)\) 的 \(\max\) 操作,
虽然噪声是正态分布的, 但是噪声的 \(\max\) 显然不为 0,
我们系统性选择了正的误差
分析一下, \(\max_{\mathbf{a}'} Q_{\phi'}(\mathbf s', \mathbf a') = Q_{\phi'}(\mathbf s', \arg \max_{\mathbf a'}Q_{\phi'}(\mathbf s', \mathbf a'))\), 同一个 \(Q_{\phi'}\) 先在 action 上保留了噪声, 又在 value 上继续选择了噪声, 我们需要去相关
这就是 Double Q-learning(DDQN) 的思想, 两个网络
\(\phi_A, \phi_B\), 更新如下 \[
Q_{\phi_A}(\mathbf s, \mathbf a) \leftarrow r + \gamma
Q_{\phi_B}(\mathbf s', \arg \max_{\mathbf a'}Q_{\phi_A}(\mathbf
s', \mathbf a')) \\
Q_{\phi_B}(\mathbf s, \mathbf a) \leftarrow r + \gamma
Q_{\phi_A}(\mathbf s', \arg \max_{\mathbf a'}Q_{\phi_B}(\mathbf
s', \mathbf a'))
\] 我们可以用 \(\phi,
\phi'\) 来代替 \(\phi_A,
\phi_B\), 于是 \(y = r + \gamma
Q_{\phi'}(\mathbf s', \arg \max_{\mathbf a'}Q_{\phi}(\mathbf
s', \mathbf a'))\)
这样方便, 但 \(\phi, \phi'\)
还是有较大相关性, 只能缓解问题
我们也可以直接引入两套独立训练的 Critic 网络训练, 在计算目标值时, 取这两个网络给出的 Q 值的最小值 \[ y = r + \gamma \min_{i=1,2} Q_{\phi'_i}(\mathbf s', \mathbf a') \] 这又引出了一些问题, 为什么要取 min, 有没有其他方法
一种思想是低估比高估好, 因为高估会自我强化, 陷入最优, 而低估时探索其他动作, 最终会自我修正
存在的问题是探索意愿降低与可能无限降低的 Q 值
解决方法有: 加入探索的熵奖励, 加权组合 \(\lambda \min(Q_1, Q_2) + (1-\lambda) \max(Q_1, Q_2)\), 集成网络(训练一组 Q 网络, 去掉最高和最低值后取平均, etc.)
另一个技巧是 Multi-step returns, 有点像 Lecture 6 中的 n
步回报技巧
在 Q-learning 中, 对于 \(y_{j,t} = r_{j,t} +
\gamma \max_{\mathbf{a}_{j,t+1}} Q_{\phi'}(\mathbf s_{j,t+1},
\mathbf a_{j,t+1})\), 在训练的初期, Q 函数啥都不会, 此时单步
reward 占主导, 在后期, Q 函数训出来了, 它的贡献远大于单步奖励,
占主导地位
这导致有的时候训练无法开头, Q 函数前期随机化的影响太大了,
压制了正确的单步奖励, 我们可以构造 n 步奖励 \[
y_{j,t} = \sum_{t'=t}^{t+N-1} \gamma^{t'-t}r_{j,t'} +
\gamma^N \max_{\mathbf{a}_{j,t+N}} Q_{\phi'}(\mathbf s_{j,t+N},
\mathbf a_{j,t+N})
\]
这样的奖励偏差小(乘了 \(\gamma^N\)), 训练快(n 步回报信号强), 但只在 on-policy 上正确, 因为如果是 off-policy 采样的样本, 第 2-n 步的 reward 是在过去的 policy 上 rollout 出来的, 这就不对了, 这个问题怎么解决?
\(N=1\) 高偏差(来自 Q)低方差(来自 r), \(N \to \infty\) 无偏但是高方差
\(N>1\) 污染了 \(\sum r\) 产生了偏差(来自异策略, 除非 on-policy)
我们可以重新掏出重要性采样, 也可以保留同 action 的部分做为奖励(old policy 和 new policy 恰好做出了相同的 action), 还可以把 \(N\) 取小一点, 直接忽略这个问题
对这个问题更好的解答来自论文 Safe and efficient off-policy reinforcement learning, 是一种改良式的重要性采样?
如果偏差过大, 重要性权重 \(\rho_t = \dfrac{\pi(a_t|s_t)}{\mu(a_t|s_t)}\) 会过大, 在 \(\prod \rho\) 后就方差爆炸了, 我们可以截断(Clipping)掉这个东西, \(c_t = \min\left(1, \frac{\pi(a_t|s_t)}{\mu(a_t|s_t)}\right)\)
后续在 Retrace 方法的基础上发明了 V-trace, Reactor, ACER 方法
目前而言我们都是在离散空间做 Q-learning, 而在连续空间后会遇到 \(\max\) 没法求的问题
有多个显然的想法, 可以在连续空间上随机取点采样, 可以做 SGD
这样的梯度下降(有点慢)
随机采样的方法其实在有时候出奇有用, 能够缓解过高估计, 与其相关的方法是 cross-entropy method(CEM) 和 CMA-CS, 这些方法对最多高达 40 维的动作空间还可以
另一个方法是让 Q 函数适应问题, 找一些容易取 max 的 Q 函数, 这是 NAF 的思想

神经网络输出标量偏置(\(V\)), 向量(\(\mu\))与正定矩阵(\(P\)), 对于给定的状态, Q 值关于动作的形状是二次的, 有 \[ \arg \max_{\mathbf a}Q_\phi(\mathbf s, \mathbf a) = \mu_\phi(\mathbf s) \quad \quad \max_{\mathbf a}Q_\phi(\mathbf s, \mathbf a) = V_{\phi}(\mathbf s) \] 我们做了很强的单峰假设, 损害了 Q 函数的表达能力
事实上, 谜底早就揭晓了, 用 actor-critic 架构中的 actor 来爬山, 让它爬到 argmax / max 上去, 这里的代表性论文是 DDPG, 可以简单的理解为 actor 和 critic 都使用两个网络: online network 和 target network
Q-learning 的训练很有技巧, 比梯度下降更困难, Q-learning 在不同问题上训练的差异很大
- 更大的 replay buffer 通常更好(有点像 fitted Q-iteration)
- Q-learning 需要长时间训练
- 做 \(\epsilon\) 退火从而在前期探索, 后期收敛(怎么感觉什么都能退火……?)
- 使用 Huber loss 代替最小二乘法误差在远处的大型平方项
在凸优化课程中的近似与拟合一章中也是这么干的, Huber 有一个参数 \(M\), 在 \([-M,M]\) 范围内二次, 在外面线性, 它是稳健(robust)的, 不怎么受离群值影响 - DDQN 很有用
- N 步回报在前期训练很有用, 但要注意引入的偏差
- Adam 拿来做策略探索与 lr 控制很有用
- 不同随机种子在 RL 上有很大差异
TQC 补充
目前(2026.5)在 Humanoid v5 任务上最夯的算法
TQC, Truncated Quantile Critics, 截断分位数批评家算法, see arXiv
专为连续动作空间设计的强化学习算法,
旨在解决值函数估计中的高估偏差问题
额, 我们好像跳了一些历史, 最原始的连续空间的 DQN 就是 DDPG, DDPG
只有一个网络, 如果把它再和多套(两套) Critic 网络结合起来取最小,
加上延迟更新, 再加上目标策略平滑的随机噪声就是 TD3
如果把 TD3 的确定性策略转换为随机性策略, 加上最大熵, 这就是 SAC (Soft
Actor-Critic)
再之后人们发现了 "取两个 Critic 的最小值" 太粗糙, 这才有了 TQC
TQC 可以理解为 分布式强化学习(Distributional RL) + SAC
我们预测的不是一个分数, 也不是一个连续分布,
而是一个分位数分布, 大概为
这个动作有 10% 概率得 100 分, 80% 概率得 80 分, 10% 概率得 30
分
\(M\) 个 Critic 各自预测出了 \(N\) 个分位数, 为了防止过高估计, TQC
把这些预测值排序, 去除最乐观的 \(d\)
个
为什么要这么做?为什么不用 \(M \times N\) 个 Critic 各自预测一个分数并扔掉前 \(d\) 大的?
首先如果每个网络都只有一个输出, 它们的数学目标是相同的,
会向同一个平均值靠拢
如果一个 Critic 预测 \(N\) 个分位数, 这
\(N\)
个输出被强制赋予了不同的数学任务
然后环境是有随机性的, 如果只输出分数忽略了随机性
最后 \(M \times N\) 个 Critic 开销很大, 而 TQC 改改最终的 linear 层就可以了
TQC 使用分位数回归损失 (Quantile Regression Loss),
最终形式有点像 Huber loss
对于一个给定的目标分位数 \(\tau\),
假设真实值为 \(y\), 模型的预测值为
\(\hat{y}\), 那么预测误差为 \(e = y - \hat{y}\)
分位数回归损失函数 \(\rho_\tau(e)\)
的公式定义如下: \[
\rho_\tau(e) = \max(\tau e, (\tau - 1) e)
\] 这个 loss 是非对称的, 例如对于 \(\tau = 0.9\) 的情形,
低估的惩罚远高于高估的惩罚, 对于 \(\tau =
0.1\) 则是反着的
额, 但是这个 loss 在 \(e=0\)
时有个尖转角, 和 TV 散度一样, 为了求导, 一般加上 Huber 的思想 \[
\mathcal{L}_\tau(e) = \left| \tau - \mathbb{I}(e < 0) \right| \cdot
\text{Huber}_\kappa(e)
\] 其中 \(\mathbb{I}(\cdot)\)
是指示函数, \(\text{Huber}_\kappa(e)\)
定义为: \[
\text{Huber}_\kappa(e) =
\begin{cases} \frac{1}{2} e^2 & \text{if } |e| \le \kappa \\
\kappa \left( |e| - \frac{1}{2} \kappa \right) & \text{if } |e| >
\kappa
\end{cases}
\]
Nash DQN 补充
既然 NAF 做了很强的单峰假设, 损害了 Q 函数的表达能力
那有没有问题就需要这样的单峰假设?需要这样二次的 Shaping?
纳什均衡需要, 如果一个博弈中纳什均衡是唯一的, 我们可以通过把优势函数变成二次型来强化学习求解
传统 DQN 你很喜欢 \(Q(\mathbf s, \mathbf a)
= r(\mathbf s, \mathbf a) + \gamma E[\max_{\mathbf a'} Q(\mathbf
s', \mathbf a')]\)
那现在引入纳什算子 \(\mathcal N\),
你就可以做 \(Q(\mathbf s, \mathbf a) =
r(\mathbf s, \mathbf a) + \gamma E[\mathcal N_{\mathbf a'} Q(\mathbf
s', \mathbf a')]\)
额, 事实上由于博弈有多个智能体参与, 上面的式子可能要向量化一下,
加一维
我们二次化之后把 NP-Hard 的纳什算子直接变得可算了, 类似 NAF, 有,
\[
\hat{A}_{i}^{\theta}(x;\mathbf
u)=-\begin{pmatrix}u_{i}-\mu_{i}^{\theta}(x)\\ \mathbf
u_{-i}-\mathbf{\mu}_{-i}^{\theta}(x)\end{pmatrix}^{\top}\mathbf
P_{i}^{\theta}(x)\begin{pmatrix}u_{i}-\mu_{i}^{\theta}(x)\\ \mathbf
u_{-i}-\mathbf\mu_{-i}^{\theta}(x)\end{pmatrix}+(\mathbf
u_{-i}-\mathbf\mu_{-i}^{\theta}(x))^{\top}\mathbf \Psi_{i}^{\theta}(x)
\\
其中
\quad\mathbf P_{i}^{\theta}(x):=\begin{pmatrix}P_{11,i}^{\theta}(x)&P_{12,i}^{\theta}(x)\\
P_{21,i}^{\theta}(x)&P_{22,i}^{\theta}(x)\end{pmatrix},
P_{11,i}^{\theta}(x) \;强制正定
\] 额好吧, 先不要被式子吓倒, 俩个小矩阵只是为了写出向量罢了,
\(\mu\) 还是 "均值",
这里是纳什均衡值
我们强制 \(P_{11,i}^{\theta}(x)\)
正定而不是整个 \(\mathbf P\)
正定因为这是第 \(i\)
个智能体的优势函数, 对于每个人不去约束别人, 只约束自己,
不然表达能力就更弱了……
\((\mathbf
u_{-i}-\mathbf\mu_{-i}^{\theta}(x))^{\top}\mathbf
\Psi_{i}^{\theta}(x)\) 是收益漂移,
表示如果别的智能体的动作偏移纳什均衡的收益, \(\Psi_{i}^{\theta}(x)\) 相当于敏感系数
为了继续砍掉过大的参数空间, 在工程中要按照博弈结构做简化, 例如考虑标签不变性与玩家相同偏好来简化参数
Lecture 9 高级策略梯度方法
本节课会为 policy gradient 方法提供新的视角, 我们从最经典的 REINFORCE 讲起
为什么 policy gradient 凑效, 这就是在问为什么梯度下降凑效一样
一种看待这个问题的方式是它在做 \(\pi \to \hat
A^\pi(\mathbf s_t, \mathbf a_t) \to \pi'\) 的循环改进,
这有点像策略迭代算法, 只是我们更温和
我们来进行量化计算, \(J(\theta) = E_{\tau \sim
p_{\theta}(\tau)} \left[ \sum\limits_t \gamma^t r(\mathbf s_t, \mathbf
a_t) \right]\) 是我们的强化学习目标, 代表在参数 \(\theta\) 的诱导的轨迹分布下,
该分布的总奖励的期望值, 我们可以进行以下声明 \[
J(\theta') - J(\theta) = E_{\tau \sim p_{\theta'}(\tau)} \left[
\sum\limits_t \gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)\right]
\]
即 \(J(\theta')\) 与 \(J(\theta)\)
之间的差异是在新策略的轨迹分布下,
旧策略优势的期望值
从 \(J(\theta')\) 到 \(J(\theta)\), 这是强化学习目标的改进,
这是某种策略迭代
如果我们能证明, 最大化旧策略优势在新策略下的期望值达成了改进,
那我们就找到了优化新策略的正确方法
我会直接列出证明过程, 然后一行行解释它 \[
\begin{aligned}
J(\theta') - J(\theta) &= J(\theta') - E_{\mathbf s_0 \sim
p(\mathbf s_0) }[V^{\pi_\theta}(\mathbf s_0)] \\
&= J(\theta') - E_{\tau \sim p_{\theta'}(\tau)
}[V^{\pi_\theta}(\mathbf s_0)] \\
&= J(\theta') - E_{\tau \sim p_{\theta'}(\tau)} \left[
\sum_{t=0}^\infty \gamma^t V^{\pi_\theta}(\mathbf s_t) -
\sum_{t=1}^\infty \gamma^t V^{\pi_\theta}(\mathbf s_t) \right] \\
&= J(\theta') + E_{\tau \sim p_{\theta'}(\tau)} \left[
\sum_{t=0}^\infty \gamma^t (\gamma V^{\pi_\theta}(\mathbf s_{t+1}) -
V^{\pi_\theta}(\mathbf s_t)) \right] \\
&= E_{\tau \sim p_{\theta'}(\tau)}\left[ \sum_{t=0}^\infty
\gamma^t r(\mathbf s_t, \mathbf a_t) \right] + E_{\tau \sim
p_{\theta'}(\tau)} \left[ \sum_{t=0}^\infty \gamma^t (\gamma
V^{\pi_\theta}(\mathbf s_{t+1}) - V^{\pi_\theta}(\mathbf s_t)) \right]
\\
&= E_{\tau \sim p_{\theta'}(\tau)}\left[ \sum_{t=0}^\infty
\gamma^t (r(\mathbf s_t, \mathbf a_t) + \gamma V^{\pi_\theta}(\mathbf
s_{t+1}) - V^{\pi_\theta}(\mathbf s_t) )\right] \\
&= E_{\tau \sim p_{\theta'}(\tau)} \left[ \sum\limits_t
\gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)\right]
\end{aligned}
\] 第一行是概念:
强化学习目标可以表示为在初始状态分布下价值函数的期望值, \(E_{\mathbf s_0 \sim p(\mathbf s_0)}\)
不依赖 \(\theta\)
第二行的意思是: 由于期望的分布不依赖于 \(\theta\), 仅依赖于初态 \(\mathbf s_0\),
那么期望的分布可以改成任何在初始状态下为 \(p(\mathbf s_0)\) 的分布, 这包括 \(p_\theta(\tau), p_{\theta'}(\tau),
p_{\text{any}}(\tau)\), 只要初始状态为 \(\mathbf s_0\)
第三行是第二行到无限的一个差分形式
第四行是对第三行的一个重排, 注意现在是 \(J(\theta') + E_{\tau \sim
p_{\theta'}(\tau)}\)
第五行带入了 \(J(\theta')\)
的定义
第六行把期望结合, 括号里的项和之前 Lecture 6 中 \(A^\pi(\mathbf{s}_t, \mathbf{a}_t) \approx
r(\mathbf{s}_t, \mathbf{a}_t) + V^\pi(\mathbf{s}_{t+1}) -
V^\pi(\mathbf{s}_t)\) 很像啊
于是我们得到了最终结论, \(J(\theta') -
J(\theta) = E_{\tau \sim p_{\theta'}(\tau)} \left[ \sum\limits_t
\gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)\right]\)
我们可以把轨迹 \(\tau\) 展开, 得到 \[ E_{\tau \sim p_{\theta'}(\tau)} \left[ \sum\limits_t \gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)\right] = \sum_t E_{\mathbf s_t \sim p_{\theta'}(\mathbf s_t)} [E_{\mathbf a_t \sim \pi_{\theta'}(\mathbf a_t | \mathbf s_t)} [\gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]] \] 我们可以使用重要性采样把 \(\pi_{\theta'}\) 变成 \(\pi_\theta\), 即 \[ E_{\tau \sim p_{\theta'}(\tau)} \left[ \sum\limits_t \gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)\right] = \sum_t E_{\mathbf s_t \sim p_{\theta'}(\mathbf s_t)} [E_{\mathbf a_t \sim \pi_{\theta}(\mathbf a_t | \mathbf s_t)} [\dfrac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} \gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]] \] 但我们的 \(\mathbf s_t\) 还是在 \(p_{\theta'}\) 上采样的, 我们可能直接换成 \(p_{\theta}\) 吗?不行
\(\pi_{\theta}\) 和 \(\pi_{\theta'}\) 就是你自己定义的策略模型, 所以可以重要性采样, 但是 \(p_{\theta'}(\mathbf s_t)\) 是在策略 \(\pi_{\theta'}\) 下的状态访问频率, 不仅算不出来, 也无法采样 (\(\theta'\) 需要部署在环境上, 状态分布是环境决定的)
抽象化写一下, 我们希望
\[
\sum_t E_{\mathbf s_t \sim \color\red p_{\theta'}(\mathbf s_t)}
[E_{\mathbf a_t \sim \pi_{\theta}(\mathbf a_t | \mathbf s_t)}
[\dfrac{\pi_{\theta'}(\mathbf{a}_t |
\mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)}
\gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]] \approx \sum_t
E_{\mathbf s_t \sim \color\red p_{\theta}(\mathbf s_t)} [E_{\mathbf a_t
\sim \pi_{\theta}(\mathbf a_t | \mathbf s_t)}
[\dfrac{\pi_{\theta'}(\mathbf{a}_t |
\mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)}
\gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]]
\] 我们记右边式子为 \(\bar
A(\theta')\), 如果 \(J(\theta')
- J(\theta) \approx \bar A(\theta')\), 我们就能通过 \(\theta' \leftarrow \arg
\max\limits_{\theta'} \bar A(\theta)\) 来更新 \(\theta'\)
我们接下来有这样的主张: 当 \(\pi_\theta\) "接近" \(\pi_{\theta'}\) 时, \(p_\theta(\mathbf s_t)\)
"接近" \(p_{\theta'}(\mathbf s_t)\)
我们从简单的情况来考虑, 假设 \(\pi_\theta\) 是一个确定型策略, 即 \(\mathbf a_t = \pi_\theta(\mathbf
s_t)\)
这时候的 "接近" 定义为 \(\pi_{\theta'}
(\mathbf a_t \neq \pi_{\theta}(\mathbf s_t)| \mathbf s_t) \leq
\epsilon\), 此时有 \(p_{\theta'}(\mathbf{s}_t) = (1 - \epsilon)^t
p_{\theta}(\mathbf{s}_t) + (1 - (1 - \epsilon)^t)
p_{\text{mistake}}(\mathbf{s}_t)\)
然后这个东西我们在模仿学习中见过, 可以很快得到 \(|p_{\theta'}(\mathbf s_t) - p_{\theta}(\mathbf
s_t)| \leq 2\epsilon t\)
假设 \(\pi_\theta\) 是一个任意分布,
我们定义 "接近" 为对于任意 \(\mathbf
s_t\), \(|\pi_{\theta'}(\mathbf
a_t|\mathbf s_t) - \pi_{\theta}(\mathbf a_t|\mathbf s_t)| \leq
\epsilon\), 这里的界定是逐点界定的, 扩展到期望上也依然可行
我们在这里引入 Lemma, 如果 \(|p_X(x) - p_Y(x)|
= \epsilon\), 那么存在联合发布 \(p(x,y)\), 使得 \(p(x) = p_X(x), p(y) = p_Y(y)\) 且 \(p(x=y) = 1-\epsilon\)
所以仍然有 \(|p_{\theta'}(\mathbf s_t) - p_{\theta}(\mathbf s_t)| \leq 2\epsilon t\)
现在随便选个函数 \(f\), 我们可以来推导当两个分布之间的 TV 散度被界定时, 函数在不同分布上的期望值之差 \[ \begin{aligned} E_{p_{\theta'}(\mathbf s_t)}[f(\mathbf s_t)] = \sum_{\mathbf s_t}p_{\theta'}(\mathbf s_t)f(\mathbf s_t) &\geq \sum_{\mathbf s_t}p_{\theta}(\mathbf s_t)f(\mathbf s_t) - |p_{\theta'}(\mathbf s_t) - p_{\theta}(\mathbf s_t)| \max_{\mathbf s_t} f(\mathbf s_t) \\ &\geq E_{p_{\theta}(\mathbf s_t)}[f(\mathbf s_t)] - 2 \epsilon t \max_{\mathbf s_t} f(\mathbf s_t) \end{aligned} \] 于是有 \[ \sum_t E_{\mathbf s_t \sim \color\red p_{\theta'}(\mathbf s_t)} [E_{\mathbf a_t \sim \pi_{\theta}(\mathbf a_t | \mathbf s_t)} [\dfrac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} \gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]] \\ \geq \sum_t E_{\mathbf s_t \sim \color\red p_{\theta}(\mathbf s_t)} [E_{\mathbf a_t \sim \pi_{\theta}(\mathbf a_t | \mathbf s_t)} [\dfrac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} \gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]] - \sum_t 2 \epsilon t C \] 这里的 \(C\) 就是 \(\max\limits_{\mathbf s_t} E_{\mathbf a_t \sim \pi_{\theta}(\mathbf a_t | \mathbf s_t)} [\dfrac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} \gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]\), 我们可以估计它的大小, 在 \(O(Tr_{\max})\) 数量级(不使用折扣因子)或 \(O(\dfrac{r_\max}{1-\gamma})\) 数量级上(使用折扣因子)
误差项中的所有东西都是常数, 除了 \(\epsilon\), 它是两个策略之间的总 TV 散度
于是, 当 \(|\pi_{\theta'}(\mathbf a_t|\mathbf s_t) - \pi_{\theta}(\mathbf a_t|\mathbf s_t)| \leq \epsilon\) 时, \(\theta' \leftarrow \arg \max\limits_{\theta'} \sum\limits_t E_{\mathbf s_t \sim p_{\theta}(\mathbf s_t)} [E_{\mathbf a_t \sim \pi_{\theta}(\mathbf a_t | \mathbf s_t)} [\dfrac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} \gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]]\) 是一种很好的强化学习更新方法
对于一些策略, 计算 \(|\pi_{\theta'}(\mathbf a_t|\mathbf s_t) - \pi_{\theta}(\mathbf a_t|\mathbf s_t)| \leq \epsilon\) 有些困难, 我们可以把 \(|\pi_{\theta'}(\mathbf a_t|\mathbf s_t) - \pi_{\theta}(\mathbf a_t|\mathbf s_t)|\) 放缩成一个与 KL 散度相关的式子, 现在我们有 \(\sqrt{\dfrac{1}{2}D_{\text{KL}} (\pi_{\theta'}(\mathbf a_t|\mathbf s_t) \| \pi_{\theta}(\mathbf a_t|\mathbf s_t) ) } \leq \epsilon\) 来替代 TV 散度
那么如何施加这个约束呢?硬的不行来软的, 我们使用拉格朗日约束, 令
\[
\mathcal L(\theta', \lambda) = \sum\limits_t E_{\mathbf s_t \sim
p_{\theta}(\mathbf s_t)} [E_{\mathbf a_t \sim \pi_{\theta}(\mathbf a_t |
\mathbf s_t)} [\dfrac{\pi_{\theta'}(\mathbf{a}_t |
\mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)}
\gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]] -
\lambda(D_{KL}(\pi_{\theta'}(\mathbf a_t|\mathbf s_t) \|
\pi_{\theta}(\mathbf a_t|\mathbf s_t)) - \epsilon)
\] 于是我们的更新策略变成了
第一步: 对原始变量最大化 \(\mathcal
L(\theta', \lambda)\)
第二步: \(\lambda \leftarrow \lambda +
\alpha(D_{KL}(\pi_{\theta'}(\mathbf a_t|\mathbf s_t) \|
\pi_{\theta}(\mathbf a_t|\mathbf s_t)) - \epsilon)\)
这里的直觉是如果约束被违反就提高 \(\lambda\), 反之降低,
这个过程被称为对偶梯度下降, 在实践中一些 trick (固定
\(\lambda\), 不完全下降) 也同样有用
我们更全面介绍一下 Lecture 4 末尾提出的自然梯度(natural gradient)方法
我们的目标是 \(\bar A(\theta') = \sum\limits_t E_{\mathbf s_t \sim p_{\theta}(\mathbf s_t)} [E_{\mathbf a_t \sim \pi_{\theta}(\mathbf a_t | \mathbf s_t)} [\dfrac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} \gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)]]\), 当我们计算目标的梯度并使用梯度上升或梯度下降时, 这可以被解释为优化该目标的一阶泰勒展开

一阶泰勒展开即上图简单的绿色直线, 如果不施加约束, 那么直线与原函数(非线性)的偏差会越来越大, 这个约束本质上是我们信任绿色曲线近似蓝色曲线的区域, 即信任区域(上图的红色方框)
当 \(\theta' = \theta\) 时, \(\nabla_\theta \bar A(\theta) = \nabla_\theta J(\theta)\), 因为 \(\dfrac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)} = 1\), 所以实际上在求 \(\theta' \leftarrow \arg \max\limits_{\theta'} \nabla_\theta J(\theta)^T (\theta'-\theta)\)
直接做梯度上升即 \(\theta \leftarrow \theta + \alpha\nabla_\theta J(\theta)\), 但这样通常不满足 KL 散度约束, 因为一个小变化在 KL 散度上的影响可能是巨大的(KL 散度检查比率变化而不是值的大小)
我们把梯度上升的形式写成 \(\theta' \leftarrow \arg \max\limits_{\theta'} \nabla_\theta J(\theta)^T (\theta'-\theta),\quad \|\theta - \theta' \|^2 \leq \epsilon\), 唯一的区别是约束不同, 这导致梯度上升产生的参数接近 \(\theta\), 而 KL 约束下产生的策略接近 \(\pi_\theta\)
我们得到的结论是: 梯度下降是一个错误的约束优化, 约束在了 \(\theta\) 空间而不是分布空间中
直观上, 约束形状对于梯度下降是一个高维球, 但我们希望它是一个椭球,
我们希望椭球沿着高度敏感的方向被压扁, 在一些 \(\theta\) 上有更紧的约束这样 KL
散度就不会炸掉, 我们也同样希望在一些不敏感的 \(\theta\) 上 "拉长" 椭球
我们对 KL 散度可以同样处理一个近似, 将其二阶泰勒展开(其一阶泰勒为 0 故不用), 有 \[ D_{\text{KL}}(\pi_{\theta'} \| \pi_\theta) \approx \frac{1}{2} (\theta'-\theta)^{\top} \mathbf F (\theta'-\theta) \] 这里的 \(\mathbf F = E_{\pi_\theta}(\nabla_\theta \log \pi_\theta(\mathbf a|\mathbf s) \nabla_\theta \log \pi_\theta(\mathbf a|\mathbf s)^{\top})\), 是 \(D_{\text{KL}}\) 的 Hessian 矩阵, 也叫费雪信息矩阵 (Fisher Information Matrix, FIM), 对于这个矩阵, 我们可以通过样本来进行近似计算
我们需要的就是这个, \(\|\theta - \theta' \|^2 \leq \epsilon\) 可以写成 \((\theta'-\theta)^T (\theta'-\theta) \leq \epsilon\), 中间插一个 \(\mathbf F\) 就把约束形状改成椭圆了
于是可以使用拉格朗日函数法推出 \(\theta' = \theta + \alpha \mathbf
F^{-1}\nabla_\theta J(\theta)\), 这就叫做自然梯度
(natural gradient)
如果你卡着 \(\epsilon\) 的边界, 能推出
\(\alpha =
\sqrt{\dfrac{2\epsilon}{\nabla_\theta J(\theta)^T \mathbf{F}^{-1}
\nabla_\theta J(\theta)}}\), 但一般我们还是手动调参
我们回顾 Lecture 4 的例子, 自然梯度确实更加 "自然" 了
TRPO 与 PPO 补充
在最新的讲义 CS285 2026fall 中已经有这一部分内容了, 不过我猜我俩都没考进伯克利, 看不了视频
现在这些式子已经太长了, 下文使用 \(E_{\mathbf s_t, \mathbf a_t}\) 代替 \(E_{\mathbf s_t \sim p_{\theta}(\mathbf s_t)} [E_{\mathbf a_t \sim \pi_{\theta}(\mathbf a_t | \mathbf s_t)} [\dots] ]\), 说明这是在旧策略下的期望
聪明的你发现, 在 natural gradient 中, 出现了 \(\mathbf F^{-1}\) 这个玩意,
把复杂度拉到了立方级
对数学造诣极高的你还能发现, 事实上, \(D_{\text{KL}}(\pi_{\theta'} \| \pi_\theta) =
\dfrac{1}{2} (\theta'-\theta)^T \mathbf{F} (\theta'-\theta) +
O(\|\theta'-\theta\|^3)\), 如果超参数 \(\epsilon\) 设计的过大, \(O(\|\theta'-\theta\|^3)\) 就会迅速膨胀,
KL 散度里的 \(\log(P/Q)\) 十分敏感, 当
\(Q \to 0\) 时迅速飙升,
三阶导数在很多方向上极其巨大
TRPO
算法做出了多点改进,
一是推导了 \(J(\theta') \ge
L_{\theta}(\theta') - C \cdot D_{\text{KL}}^{\max}(\pi_\theta,
\pi_{\theta'})\), 这里的 \(C\) 和之前推导的 \(\sum\limits_t 2 \epsilon t
\;O(\dfrac{r_\max}{1-\gamma})\) 本质上一样
二是通过共轭梯度法计算 \(\mathbf
F^{-1}\nabla_\theta J(\theta)\), 设 \(\mathbf F x= \nabla_\theta J(\theta)\), 则
\(x=\mathbf F^{-1}\nabla_\theta
J(\theta)\),
还有一个技巧是, 因为 \(\mathbf{F} v =
(\nabla_\theta^2 D_{\text{KL}}) v = \nabla_\theta (\nabla_\theta
D_{\text{KL}} \cdot v)\), 我们可以通过两次反向传播得到 \(\mathbf F v\)
共轭梯度法可以在十步左右找到近似的 \(x\), 两次反向传播的时间空间复杂度都是 \(O(N)\) 级别的, 解决了问题
三是回溯线搜索(Backtracking Line Search)
这是工程上的技巧, 既然 \(O(\|\theta'-\theta\|^3)\),
那么炸了就回溯, 先用共轭梯度法算出最大可能步长, 然后进行试探
如果发现真实的 KL 散度 \(\ge
\epsilon\), 或者目标函数反而下降了, 就把步长打折 (eg. 乘以 \(0.8\)) 再试, 直到安全为止
PPO
算法追溯到了问题本源: 我们不就是想约束 KL 散度吗?
在对偶梯度下降中, 有 \[
\mathcal L(\theta', \lambda) = \sum\limits_t E_{\mathbf s_t, \mathbf
a_t} [\dfrac{\pi_{\theta'}(\mathbf{a}_t |
\mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)}
\gamma^tA^{\pi_\theta}(\mathbf s_t, \mathbf a_t)] -
\lambda(D_{KL}(\pi_{\theta'}(\mathbf a_t|\mathbf s_t) \|
\pi_{\theta}(\mathbf a_t|\mathbf s_t)) - \epsilon)
\] 我们把式子变为 \(L^{\text{KLPEN}}(\theta') = E_{\mathbf s_t,
\mathbf a_t} \left[ \dfrac{\pi_{\theta'}(\mathbf a_t | \mathbf
s_t)}{\pi_\theta(\mathbf a_t | \mathbf s_t)}
\hat{A}^{\pi_\theta}(\mathbf s_t, \mathbf a_t) \right] - \beta
D_{\text{KL}}(\pi_\theta \| \pi_{\theta'})\), 扔掉 \(\epsilon\), 软惩罚 \(D_{KL}\), 此时 "每单位" \(D_{KL}\) 的价格是 \(\beta\), 然后在每一轮迭代后动态调整 \(\beta\), 我们有一个目标 KL 散度 \(d_{\text{targ}}\), 每轮迭代后调整如下
- 计算当前真实发生的 \(D_{\text{KL}}\)
- 如果 \(D_{\text{KL}} > d_{targ} \times 1.5\), \(\beta \leftarrow \beta \times 2\)
- 如果 \(D_{\text{KL}} < d_{targ} / 1.5\), \(\beta \leftarrow \beta/2\)
你会说, 这不是纯纯的工程经验吗?这一堆超参是不是太多了点?而且这个 \(\beta\) 不是在事后调整吗?(原文 The updated \(\beta\) is used for the next policy update.) 那要是策略已经炸掉了怎么办?
所以我们一般使用论文提出的另一种 PPO-Clip 方法, 这种方法十分暴力, 感觉和前面学的也没啥关系了
我们令 \(r_t(\theta') = \dfrac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)}\) 代表了新旧策略对同一个动作的偏好变化(>1 说明新策略更喜欢, 反之亦然), 有 \[ L^{\text{CLIP}}(\theta') = E_{\mathbf s_t, \mathbf a_t} \left[ \min(r_t(\theta') \hat{A}^{\pi}(\mathbf s_t, \mathbf a_t), \text{clip}(r_t(\theta'), 1-\epsilon, 1+\epsilon) \hat{A}^{\pi}(\mathbf s_t, \mathbf a_t)) \right] \] 这里的 \(\epsilon\) 是手动调整的超参, 通常 \(\epsilon = 0.2\), 在工程上还有一些 \(\epsilon\) 退火的玩法
我们定义 \(\text{clip}(x, L, U) = \begin{cases} L & \text{if } x < L \\ x & \text{if } L \le x \le U \\ U & \text{if } x > U \end{cases}\), \(\min\) 函数就是对奖励与惩罚的截断, 防止策略剧烈波动
在工程中, 我们一般优化最大化的目标函数为 \[ L^{\text{TOTAL}}(\theta') = E_{\mathbf s_t, \mathbf a_t} \left[ L^{\text{CLIP}}(\theta') - c_1 L^{\text{VF}}(\theta') + c_2 \mathcal{S}[\pi_{\theta'}](\mathbf s_t) \right] \] \(- c_1 L^{\text{VF}}(\theta')\) 是价值函数的损失, 我们希望 Critic 预测当前状态的价值 \(V(\mathbf s_t)\) 尽可能准确, 一般使用均方差误差 $ L^{}(') = (V_{'}(s_t) - V_t{})2$ 即可, 其中 \(V_t^{\text{targ}}\) 是我们在环境中实际收集到的回报, 比如 GAE 算出来的
\(+ c_2 \mathcal{S}[\pi_{\theta'}](\mathbf s_t)\) 是熵奖励, 其中 \(\mathcal{S}[\pi_{\theta'}](\mathbf s_t) = E_{\mathbf a_t \sim \pi_{\theta'}(\mathbf a_t | \mathbf s_t)} [-\log \pi_{\theta'}(\mathbf a_t | \mathbf s_t)]\), 我们鼓励网络前期多进行探索(高熵), 后期收敛, \(c_2\) 通常是一个很小的系数(eg. \(c_2 = 0.01\))
一个基本的 PPO 工程算法(implement + trick)的流程如下:
- 从 \(\pi_\theta(\mathbf a_t | \mathbf s_t)\) 中采样 \(\{\mathbf s_i, \mathbf a_i \}\) (运行 policy)
- 拟合 \(\hat V_{\phi}^\pi(\mathbf s)\) 到采样奖励上
- 对于每个采样的动作对, 使用广义优势估计 GAE 计算近似优势 \(\hat A^\pi(\mathbf s_i, \mathbf a_i)\)
- 将这批收集到的 \(T\) 步数据打乱,
划分为多个 Minibatches, 准备进行 K Epochs 的重复优化
在这里产生 \(\theta_{\text{old}} \leftarrow \theta\) - 对于每个 Minibatch 中的采样, 计算 \(r_t(\theta) = \dfrac{\pi_\theta(\mathbf a_t | \mathbf s_t)}{\pi_{\theta_{\text{old}}}(\mathbf a_t | \mathbf s_t)}\), 并构建 \(L^{\text{TOTAL}}(\theta, \phi)\)
- 计算 \(L^{\text{TOTAL}}(\theta, \phi)\) 关于 \(\theta\) 和 \(\phi\) 的梯度, 更新 \(\theta\) 和 \(\phi\)
- 重复步骤 4 和 5 直到跑完 K Epochs, 清空旧数据, 令 \(\theta_{\text{old}} \leftarrow \theta\), \(\phi_{\text{old}} \leftarrow \phi\), 回到第一步
PPO 虽然做了重要性采样, 但只保留 K epochs 而不是多次使用, 所以仍然是 On-policy 的
这里需要价值网络 \(\phi\), 策略网络 \(\theta\), 以及目标网络 \(\theta_{\text{old}}\)
一个可能的误区是, PPO 被 Clipping 后的数据会被学习, 这是错误的, 你把东西 Clip 在一个常数上后它的梯度就是蛋了, 不会对模型有贡献, 相当于我们抛弃了所有过大偏离的样本
讲到这里, 我们已经从纯粹的数学转到工程与代码了(PPO 也不数学啊), 有人批判 PPO-Clip 的想法太粗糙, 一刀切, 当年的论文纯粹是 OpenAI 加了一堆 trick 后跑出来的, 我把 PPO 37 Tricks 文章放在这里做参考
最后以 CS285 2026fall 上的流程图做收尾, 注意下面的 PPO 指的是 KL-penalty 的

DPO 与 GRPO 补充
看完能和外婆解释的 PPO, DPO, GRPO强化学习 - 知乎
基于人类反馈的强化学习(Reinforcement Learning from Human
Feedback, RLHF) 是大模型的基石, 当模型需要对齐人类的模糊需求时,
我们会引入新的 Reward Model 做整体反馈
Reward Model \(\psi\) 是一个预训练好的,
仅在推理时使用, 针对整个 rollout 输出 \(r\) 给 GAE 的模型

我们稍微进军 LLM RL 领域一下
LLM
训练粗略分为预训练(Pre-training)与后训练(Post-training)两个阶段,
前者做 next token prediction 并积累世界知识,
后者做有监督微调(Supervised Fine-Tuning, SFT),
奖励模型训练, 以及强化学习优化
PPO 主要应用于 LLM 的后训练(Post-training)阶段, 是 RLHF
的关键算法
在 LLM RL 中, 纯粹的 PPO 就不好用了
太™奢侈了, 你想想要训练一个 70B 的 Actor, 训练过程中你需要同时把 Actor、Reference Model、Reward Model 和 Critic 这四个 70B 全部塞进显卡里
于是需要 DPO 算法, 抛弃 Reward Model 和 Critic,
目标变为让模型生成好答案的概率,
大于生成坏答案的概率
这就叫做 Direct Preference Optimization, 直接基于偏好的对比学习, Loss 为
\[
L^{\text{DPO}} (\theta)= E_{(x,y_w,y_l) \sim \mathcal D}\left[ -\log
\sigma \left( \beta \log
\frac{\pi_\theta(y_w|x)}{\pi_{\text{ref}}(y_w|x)} - \beta
\log\frac{\pi_\theta(y_l|x)}{\pi_{\text{ref}}(y_l|x)} \right) \right]
\] \(y_w\) 代表好答案, \(y_l\) 代表坏答案, 好答案的优势 -
坏答案的优势 = 差距, 我们希望最大化, 于是加负号最小化 Loss, \(\beta\) 超参给惩罚强度, sigmoid \(\sigma\) 函数用于映射到 [0,1] 区间
DPO 想要效果好, 最好是用当前模型去采样数据,
然后让人类(或强模型)去标注好坏, 因为需要同分布
在 DPO 中数据构造是大坑, 因为 DPO 对数据噪声极度敏感,
当模型能力达到极高水平时, 人类已经很难给出高质量的偏好数据了, 在 2026
的当下估计也没啥用了
GRPO(Group Relative Policy Optimization, 组相对策略优化) 同样抛弃 Critic, 用组内相对表现来做基线
对于同一个提示词 \(\mathbf s_i\),
不去问价值模型这个状态有多好, 而是让 LLM 生成 \(K\) 个不同的回答 \(a_{i,1}, \dots, a_{i,K}\)
使用奖励模型(Reward Model)或规则(Verifier)对这 \(K\) 个回答分别打分,
然后计算这组得分的平均值
将组内每个回答的得分减去这个平均值, 得分高于平均值的, 优势为正,
鼓励该行为; 得分低于平均值的, 优势为负, 抑制该行为。家人们, 这就是 peer
pressure 啊
对于给定的提示 \(\mathbf s_i\)
和生成的第 \(j\) 个回答 \(\mathbf a_j\), 其优势估计量 \(\hat{A}_{i,j}^\pi = r(\mathbf s_i, \mathbf a_j) -
\dfrac{1}{K}\sum\limits_{k=1}^K r(\mathbf s_i, \mathbf
a_k)\)
GRPO 的策略梯度估计可以表示为重要性采样的形式 \[
\nabla_{\theta} E_{\pi_{\theta}(\mathbf a|\mathbf s)}[r(\mathbf
s,\mathbf a)] \approx \frac{1}{N} \sum_{i,j} \frac{\pi_{\theta}(\mathbf
a_j|\mathbf s_i)}{\bar{\pi}(\mathbf a_j|\mathbf s_i)} \nabla_{\theta}
\log \pi_{\theta}(\mathbf a_j|\mathbf s_i) \hat{A}_{i,j}^\pi
\] 在此基础上加上 Clipping 与 KL Penalty, GRPO 损失函数为 \[
L^{\text{GRPO}}(\theta') = E_{\mathbf s, \{\mathbf a_j\}_{j=1}^K}
\left[ \frac{1}{K} \sum_{j=1}^K \left( \min(r_j(\theta')
\hat{A}^{\pi}(\mathbf s, \mathbf a_j), \text{clip}(r_j(\theta'),
1-\epsilon, 1+\epsilon) \hat{A}^{\pi}(\mathbf s, \mathbf a_j)) - \beta
D_{\text{KL}}(\pi_{\theta'}(\mathbf a_j | \mathbf s) \parallel
\pi_{\text{ref}}(\mathbf a_j | \mathbf s)) \right) \right]
\] 这里的 KL Penalty 迫使新策略 \(\pi_{\theta'}\)
不要过度偏离基座参考模型 \(\pi_{\text{ref}}\)
Lecture 10 最优控制与规划
我们要转向 Model-based RL 了, 本 lecture 为预备知识, 前面的 Lecture(除补充外)都是 Model-free 的

又一次的, 我们把之前复杂的一堆符号都忘掉, 回到最开始, 目标是最大化轨迹上奖励总和的期望
model-free 假设了我们不知道 \(p(\mathbf
s_{t+1}|\mathbf s_t, \mathbf a_t)\), 并且我们不去学习它
在一些情况下, 我们知道 transition dynamics, 例如 Atari
游戏或象棋或简单物理模型等
在一些情况下, 我们可以学习 transition dynamics,
这里可以将通用模型拟合到观察到的转移数据上
如果知道模型, 如何做出决策?
在确定性情况中, 我们关心问题 \(\mathbf{a}_1,
\dots, \mathbf{a}_T = \arg\max_{\mathbf{a}_1, \dots, \mathbf{a}_T}
\sum\limits_{t=1}^T r(\mathbf{s}_t, \mathbf{a}_t) \text{ s.t. }
\mathbf{s}_{t+1} = f(\mathbf{s}_t, \mathbf{a}_t)\)
在随机性情况中, 有开环规划(Open-loop
Planning)和闭环控制 (Closed-loop
Control)两种情况

开环规划直接求解出的是一个固定的动作序列, 有 \[ p_\theta(\mathbf{s}_1, \dots, \mathbf{s}_T | \mathbf{a}_1, \dots, \mathbf{a}_T) = p(\mathbf{s}_1) \prod_{t=1}^T p(\mathbf{s}_{t+1} | \mathbf{s}_t, \mathbf{a}_t) \\ \mathbf{a}_1, \dots, \mathbf{a}_T = \arg\max_{\mathbf{a}_1, \dots, \mathbf{a}_T} E \left[ \sum_t r(\mathbf{s}_t, \mathbf{a}_t) \Big| \mathbf{a}_1, \dots, \mathbf{a}_T \right] \] 这是次优的, 相当于在卷子还没给你之前训练你把题目都蒙出来, 而不是看一题写一题
闭环控制就是我们常见的 RL 了, 有 \[ p(\mathbf{s}_1, \mathbf{a}_1, \dots, \mathbf{s}_T, \mathbf{a}_T) = p(\mathbf{s}_1) \prod_{t=1}^T \pi(\mathbf{a}_t | \mathbf{s}_t) p(\mathbf{s}_{t+1} | \mathbf{s}_t, \mathbf{a}_t) \\ \pi = \arg\max_{\pi} \mathbb{E}_{\tau \sim p(\tau)} \left[ \sum_t r(\mathbf{s}_t, \mathbf{a}_t) \right] \] 这里的 policy \(\pi\) 不一定是全局的神经网络, 也可能是局部策略, 例如 \(\mathbf{a}_t = \mathbf{K}_t \mathbf{s}_t + \mathbf{k}_t\) 这样的时变线性函数
先详解一下 Open-loop Planning 相关的方法
随机优化(Stochastic optimization)是黑箱优化算法,
只关心问题本身, 可以抽象为 \(\mathbf{A} =
\arg\max_{\mathbf{A}} J(\mathbf{A})\)
最简单的方法是随机挑选 \(N\)
个动作序列: \(\mathbf{A}_1, \dots,
\mathbf{A}_N\), 然后根据 \(\arg\max_i
J(\mathbf{A}_i)\) 选出最好的动作序列 \(\mathbf{A}_i\)
聪明一点的为交叉熵方法(Cross-Entropy Method, CEM),
我们会学习一个动作的高斯分布 \(p(\mathbf{A})\)
随机挑选可以认为从均匀分布中选择动作
而我们可以设一个高斯分布, 从其中选择 \(N\) 个动作, 并选择 \(M<N\)
个表现最好的精英样本(elites), 使用这 \(M\) 个样本重新拟合(做最大似然拟合)概率分布
\(p(\mathbf{A})\), CMAES 算法
还可以在此基础上加点动量
CEM 实现简单, 适合并行, 但是对维度数有很大限制(~60 max), 只适用于开环规划
蒙特卡洛树搜索(Monte Carlo tree search, MCTS)主要适用于离散状态棋牌游戏, 涉及一些闭环反馈
我们进行树搜索, 但不完全展开树(指数级昂贵),
而是展开到一定深度后运行某种基准策略(例如完全随机)
注意我们扩展的节点值不等于真实价值, 因为这是随机环境, 有随机策略
我们如何选择扩展哪个节点?一般使用 UCT 策略平衡最优动作与探索

这种方法的扩展非常丰富, 额, 也许你能自己写一个 AlphaGo 出来
我们也可以使用导数方法, 现在用控制论的符号, \(\mathbf s \to \mathbf x, \mathbf a \to \mathbf u\), 对应的无约束优化问题为 \[ \min_{\mathbf{u}_1,...,\mathbf{u}_T}c(\mathbf{x}_1,\mathbf{u}_1)+c(f(\mathbf{x}_1,\mathbf{u}_1),\mathbf{u}_2)+\cdots+c(f(f(\ldots)\ldots),\mathbf{u}_T) \] 如果知道 \(\dfrac{df}{d \mathbf x_t}, \dfrac{df}{d \mathbf u_t}, \dfrac{dc}{d \mathbf x_t}, \dfrac{dc}{d \mathbf u_t}\) 就可以使用梯度来更新, 不过一阶方案效果很差, 通常用二阶方法


下面介绍一个简单的 case, LQR (Linear Quadratic Regulator,
线性二次型调节器)
优化目标仍为 \(\min\limits_{\mathbf{u}_1,\dots,\mathbf{u}_T}
c(\mathbf{x}_1, \mathbf{u}_1) + c(f(\mathbf{x}_1, \mathbf{u}_1),
\mathbf{u}_2) + \dots + c(f(f(\dots)\dots),
\mathbf{u}_T)\),
我们的 \(f(\mathbf{x}_t, \mathbf{u}_t) =
\mathbf{F}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}
+ \mathbf{f}_t\) 为线性的, cost 函数 \(c(\mathbf{x}_t, \mathbf{u}_t) = \frac{1}{2}
\begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}^{\top}
\mathbf{C}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}
+ \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}^{\top}
\mathbf{c}_t\) 是二次的
注意这里的 \(f, c\) 中都有含 \(t\) 下标, 每个时间步的的动力学可能不同
假设我们求最后一步 \(\mathbf u_T\) 与 \(\mathbf x_T\) 的关系式, 此时 Q 函数为 \[ Q(\mathbf{x}_T, \mathbf{u}_T) = \text{const} + \frac{1}{2} \begin{bmatrix} \mathbf{x}_T \\ \mathbf{u}_T \end{bmatrix}^{\top} \mathbf{C}_T \begin{bmatrix} \mathbf{x}_T \\ \mathbf{u}_T \end{bmatrix} + \begin{bmatrix} \mathbf{x}_T \\ \mathbf{u}_T \end{bmatrix}^{\top} \mathbf{c}_T \\ 其中 \;\mathbf{C}_T = \begin{bmatrix} \mathbf{C}_{\mathbf{x}_T,\mathbf{x}_T} & \mathbf{C}_{\mathbf{x}_T,\mathbf{u}_T} \\ \mathbf{C}_{\mathbf{u}_T,\mathbf{x}_T} & \mathbf{C}_{\mathbf{u}_T,\mathbf{u}_T} \end{bmatrix}, \;\mathbf{c}_T = \begin{bmatrix} \mathbf{c}_{\mathbf{x}_T} \\ \mathbf{c}_{\mathbf{u}_T} \end{bmatrix} \] 我们对 \(\mathbf{u}_T\) 求梯度并令其为 0, 有 \[ \nabla_{\mathbf{u}_T} Q(\mathbf{x}_T, \mathbf{u}_T) = \mathbf{C}_{\mathbf{u}_T,\mathbf{x}_T} \mathbf{x}_T + \mathbf{C}_{\mathbf{u}_T,\mathbf{u}_T} \mathbf{u}_T + \mathbf{c}_{\mathbf{u}_T}^{\top} = 0 \] 于是 \(\mathbf{u}_T = -\mathbf{C}_{\mathbf{u}_T,\mathbf{u}_T}^{-1} (\mathbf{C}_{\mathbf{u}_T,\mathbf{x}_T} \mathbf{x}_T + \mathbf{c}_{\mathbf{u}_T})\), 其实全是 const, 可以理解为 \(\mathbf x_T\) 的线性函数, 有 \[ \mathbf{u}_T = \mathbf{K}_T \mathbf{x}_T + \mathbf{k}_T \\ 其中\; \mathbf{K}_T = -\mathbf{C}_{\mathbf{u}_T,\mathbf{u}_T}^{-1} \mathbf{C}_{\mathbf{u}_T,\mathbf{x}_T},\; \mathbf{k}_T = -\mathbf{C}_{\mathbf{u}_T,\mathbf{u}_T}^{-1} \mathbf{c}_{\mathbf{u}_T} \] 好了好了, 这下好了, 简单的小控制, \(\mathbf u_T\) 由 \(\mathbf x_T\) 决定, 那直接带入就好了, 接下来也可以一步步回推, 有 \[ V(\mathbf{x}_T) = \text{const} + \frac{1}{2} \begin{bmatrix} \mathbf{x}_T \\ \mathbf{K}_T\mathbf{x}_T + \mathbf{k}_T \end{bmatrix}^{\top} \mathbf{C}_T \begin{bmatrix} \mathbf{x}_T \\ \mathbf{K}_T\mathbf{x}_T + \mathbf{k}_T \end{bmatrix} + \begin{bmatrix} \mathbf{x}_T \\ \mathbf{K}_T\mathbf{x}_T + \mathbf{k}_T \end{bmatrix}^{\top} \mathbf{c}_T \] 可以化简成 \(V(\mathbf{x}_T) = \text{const} + \frac{1}{2}\mathbf{x}_T^{\top}\mathbf{V}_T\mathbf{x}_T + \mathbf{x}_T^{\top}\mathbf{v}_T\) 的紧凑二次型, 就不展开 \(\mathbf V_T, \mathbf v_T\) 了
现在可以把 \(\mathbf u_{T-1}\) 由
\(\mathbf x_{T-1}\) 表示, 我们有 \(f(\mathbf x_{T-1}, \mathbf u_{T-1}) = \mathbf x_T
= \mathbf{F}_{T-1} \begin{bmatrix} \mathbf{x}_{T-1} \\ \mathbf{u}_{T-1}
\end{bmatrix} + \mathbf{f}_{T-1}\)
我们可以套用 Q 函数, 最后要加一项 \(V(f(\mathbf x_{T-1}, \mathbf u_{T-1})) = V(\mathbf
x_T) = 一大坨\)
这里所有的 \(\mathbf x_T\) 都要用 \(\mathbf{F}_{T-1} \begin{bmatrix} \mathbf{x}_{T-1}
\\ \mathbf{u}_{T-1} \end{bmatrix} + \mathbf{f}_{T-1}\) 替换掉,
所以 Q 函数式子只和 \(\mathbf u_{T-1}, \mathbf
x_{T-1}\) 有关了
我们可以解出来 \(\mathbf{u}_{T-1} =
\mathbf{K}_{T-1} \mathbf{x}_{T-1} + \mathbf{k}_{T-1}\)
这样的东西, 然后递归往回做, 总流程如下

接下来为了让你进一步疯狂, 我们把刚刚的一切推广到随机动力学以及非线性系统上
我们假设 \(\mathbf{x}_{t+1} \sim p(\mathbf{x}_{t+1} | \mathbf{x}_t, \mathbf{u}_t) = \mathcal{N}\left( \mathbf{F}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} + \mathbf{f}_t, \mathbf{\Sigma}_t \right)\)
我们优化的目标变成了最小化代价函数的期望值, 有一个结论:
依然选择 \(\mathbf{u}_t =
\mathbf{K}_t\mathbf{x}_t + \mathbf{k}_t\)
控制理论中这一伟大的结论被称为确定性等价原理(Certainty
Equivalence Principle), 我们可以忽略噪声 \(\mathbf{\Sigma}_t\),
当在高斯分布下对一个二次型函数求期望时,
数学上会发生神奇的解耦现象, 有 \[
\mathbb{E}[Q(\mathbf{x}, \mathbf{u})] = \text{关于(均值)的二次型} +
\text{Tr}(\mathbf{V} \mathbf{\Sigma})
\] 其中, 第二项 \(\text{Tr}(\mathbf{V}
\mathbf{\Sigma})\) 是一个常数, 它只由噪声大小 \(\mathbf{\Sigma}\) 决定, 对 \(\mathbf u\) 求导后消失, 这是好事啊!
在非线性情况下,
一个直观的想法是泰勒展开把系统近似为一个线性-二次系统(linear-quadratic
system), 有 \[
f(\mathbf{x}_t, \mathbf{u}_t) \approx f(\hat{\mathbf{x}}_t,
\hat{\mathbf{u}}_t) + \nabla_{\mathbf{x}_t, \mathbf{u}_t}
f(\hat{\mathbf{x}}_t, \hat{\mathbf{u}}_t) \begin{bmatrix} \mathbf{x}_t -
\hat{\mathbf{x}}_t \\ \mathbf{u}_t - \hat{\mathbf{u}}_t \end{bmatrix} \\
c(\mathbf{x}_t, \mathbf{u}_t) \approx c(\hat{\mathbf{x}}_t,
\hat{\mathbf{u}}_t) + \nabla_{\mathbf{x}_t, \mathbf{u}_t}
c(\hat{\mathbf{x}}_t, \hat{\mathbf{u}}_t) \begin{bmatrix} \mathbf{x}_t -
\hat{\mathbf{x}}_t \\ \mathbf{u}_t - \hat{\mathbf{u}}_t \end{bmatrix} +
\frac{1}{2} \begin{bmatrix} \mathbf{x}_t - \hat{\mathbf{x}}_t \\
\mathbf{u}_t - \hat{\mathbf{u}}_t \end{bmatrix}^{\top}
\nabla_{\mathbf{x}_t, \mathbf{u}_t}^2 c(\hat{\mathbf{x}}_t,
\hat{\mathbf{u}}_t) \begin{bmatrix} \mathbf{x}_t - \hat{\mathbf{x}}_t \\
\mathbf{u}_t - \hat{\mathbf{u}}_t \end{bmatrix}
\] 然后, 不直接求解绝对状态 \(\mathbf{x}_t\) 和绝对控制 \(\mathbf{u}_t\),
而关心当前真实轨迹与名义轨迹之间的偏差
\(\delta\mathbf{x}_t = \mathbf{x}_t -
\hat{\mathbf{x}}_t\) 代表状态偏离了多少; \(\delta\mathbf{u}_t = \mathbf{u}_t -
\hat{\mathbf{u}}_t\) 代表控制量偏离了多少
于是有偏差线性动力学 \(\bar f\)
和偏差二次代价 \(\bar c\) \[
\bar{f}(\delta\mathbf{x}_t, \delta\mathbf{u}_t) = \mathbf{F}_t
\begin{bmatrix} \delta\mathbf{x}_t \\ \delta\mathbf{u}_t \end{bmatrix},
\quad\mathbf{F}_t = \nabla_{\mathbf{x}_t,\mathbf{u}_t}
f(\hat{\mathbf{x}}_t, \hat{\mathbf{u}}_t) \\
\bar{c}(\delta\mathbf{x}_t, \delta\mathbf{u}_t) = \frac{1}{2}
\begin{bmatrix} \delta\mathbf{x}_t \\ \delta\mathbf{u}_t \end{bmatrix}^T
\mathbf{C}_t \begin{bmatrix} \delta\mathbf{x}_t \\ \delta\mathbf{u}_t
\end{bmatrix} + \begin{bmatrix} \delta\mathbf{x}_t \\ \delta\mathbf{u}_t
\end{bmatrix}^T \mathbf{c}_t, \quad \mathbf{C}_t =
\nabla_{\mathbf{x}_t,\mathbf{u}_t}^2 c(\hat{\mathbf{x}}_t,
\hat{\mathbf{u}}_t), \mathbf{c}_t = \nabla_{\mathbf{x}_t,\mathbf{u}_t}
c(\hat{\mathbf{x}}_t, \hat{\mathbf{u}}_t)
\] 这就叫做 iLQR(iterative LQR), 整体流程如下
先在在当前轨迹 \((\hat{\mathbf{x}},
\hat{\mathbf{u}})\) 上计算 \(\mathbf{F}_t, \mathbf{C}_t,
\mathbf{c}_t\),
针对偏差系统跑一遍 LQR, 算出针对偏差的最优反馈策略 \(\delta\mathbf{u}_t = \mathbf{K}_t
\delta\mathbf{x}_t + \mathbf{k}_t\)
利用得到的闭环策略生成新的轨迹 \(\mathbf{u}_t
= \hat{\mathbf{u}}_t + \mathbf{K}_t(\mathbf{x}_t - \hat{\mathbf{x}}_t) +
\mathbf{k}_t\), 并用真正的 \(f\)
推进计算出新的 \(\mathbf{x}_t^{\text{new}}\)
新轨迹作为下一次的 \(\hat{\mathbf{x}},
\hat{\mathbf{u}}\), 重新跑第 1 步,
直到控制量收敛(达到局部最优解)
工程上用 \(\mathbf{u}_t = \hat{\mathbf{u}}_t + \mathbf{K}_t(\mathbf{x}_t - \hat{\mathbf{x}}_t) + \alpha\mathbf{k}_t, \alpha \in [0,1]\) 因为有, 额, trust region 的问题
事实上, iLQR 方法是牛顿法的进一步近似(动力学为一阶而不是二阶)

孩子们, 因为那个 Hessian 矩阵 \(\mathbf
H\) 求导很困难啊
完整求解二阶动力学的方法叫做 DDP(Differential Dynamic
Programming, 微分动态规划), 在离最优解较近时,
它的收敛速度是平方级的, 也在强非线性系统下更稳定, 但是算不动啊, 状态变量
\(\mathbf{x}\) 本身是一个向量,
对它求二阶导数会产生一个三阶张量, 啊哈哈哈哈
Case Study, 论文 Synthesis and Stabilization of Complex Behaviors through Online Trajectory Optimization, IROS 2012, 知乎解读
有关于 iLQR 的优秀工程化文章, Mujoco 就是他们提出来的, 有很多实用小 trick, 例如
- 在控制代价的局部海森矩阵 \(Q_{uu}\) 上添加一个对角项 \(\mu I_m\) 以保证正定(其实没有使用)
- 对状态的偏差进行正则化, 将 \(\mu I_n\) 加到下一个时间步的价值函数二次项 \(V_{xx}'\) 上
- 依赖于步长因子 \(\Delta\) 调度正则化参数 \(\mu\)
- 更精确的期望代价下降估计
- 状态代价 (Smooth-abs): 采用了平滑的绝对值函数 \(l(x) = \sqrt{x^2 + \alpha^2} - \alpha\)
- 控制代价 (Control-limiting): 使用了双曲余弦函数 \(l(u) = \alpha^2(\cosh(u/\alpha) - 1)\) 将信号限制在可行域内
- 使用有限差分, 选择步长代替导数
Lecture 11 Model-Based RL
学习 \(f(\mathbf s_t, \mathbf a_t) = \mathbf s_{t+1}\) 对应的 \(f\), 最简单的方法为收集 \(\mathcal D = \{ (\mathbf s, \mathbf a, \mathbf s')_i \}\) 然后做监督学习, 还真有用!
当然它不是总是有用, 额, 分布会偏移啊, 有点像模仿学习的脱缰, 如果只是拟合几个参数还可以
既然像模仿学习, 那我们也可以用模仿学习的方法来解决问题(eg. DAGGER),
我们希望 \(p_{\pi_0}(\mathbf s_t) =
p_{\pi_f}(\mathbf s_t)\)
在我们学习完 \(f(\mathbf s, \mathbf
a)\) 后, 我们要用 \(f\)
来选择一些新的 \(\mathbf a\)
(一连串)并于真实环境交互得到正确的 \(\mathbf
s\) 加入数据集

我们相信这种方法能够渐进纠正错误, 但我们也可以做得更好,
即刻纠正错误
在 \(f\) 做出第一个 \(\mathbf a\) 后立刻观察环境给出的真实新状态
\(\mathbf{s}'\), 抛弃后面的规划,
在真实的 \(\mathbf{s}'\)
基础上重新规划
ver 1.5 相当于闭环规划, 而 ver 1.0 则是开环规划, ver 1.5 每隔 \(N\) 步更新一次动力学模型

既然现在是闭环控制了, 一般我们第三步 plan 的 horizon 会降低一点
一般认为 Model-Based RL 高效但上限低, Model-Free RL
低效但上限高
Model-Based RL 会进行 Model Exploitation, 真实世界比 \(f(\mathbf s, \mathbf a)\) 复杂多了,
模型可能学习错误导致早早过拟合
我们可以通过不确定性估计来缓解这个问题, 我们不预测动作,
而是预测一个分布, 或者是同时训练多个模型同时预测动作; 当预测的方差极大时
/ 期望 reward 不高时不选择动作
这里其实有很多细节啊, 期望值 ≠ 悲观值 ≠ 乐观值,
有些问题你可能无法承受最坏情况, 而另一些问题可能要赌一个最好情况,
有很多探索策略, 这里先用期望值吧……
现在我们想要训练一个 Uncertainty-Aware Neural Net Model
一个想法是利用输出的熵, 但这是错的
模型的不确定性分为偶然不确定性(Aleatoric,
如噪声)和认知不确定性(Epistemic, 模型没见过的盲区)
输出的熵只能代表偶然不确定性, 如果数据
OOD(Out-of-Distribution), 神经网络的外推能力很差,
它会自信给出一个极小方差的答案, 对应极小的输出熵
所以这里的问题是, 模型对已有的数据很确定,
但我们对模型本身在未知领域的表现并不确定
传统做法是最大似然估计, \(\arg \max_\theta
\log p(\theta|\mathcal{D}) = \arg \max_\theta \log
p(\mathcal{D}|\theta)\), 寻找最完美的参数 \(\theta\), 最大化观测到数据 \(\mathcal{D}\) 的概率, 它估计和最大化的是
\(p(\mathcal{D} | \theta)\)
我们也可以估计 \(p(\theta |
\mathcal{D})\) 来获得不确定性, 估计参数的概率分布
当我们想预测在状态 \(\mathbf{s}_t\)
采取动作 \(\mathbf{a}_t\)
后的下一个状态 \(\mathbf{s}_{t+1}\) 时,
使用下式 \[
\int p(\mathbf{s}_{t+1} | \mathbf{s}_t, \mathbf{a}_t, \theta) p(\theta |
\mathcal{D}) \text d\theta
\] 这样整合了所有可能的模型参数,
在实际计算中要对这个积分进行近似
贝叶斯神经网络(Bayesian Neural Network, BNN)
中每个连接权重不再是数字, 而是概率分布
我们可以通过 \(p(\theta | \mathcal{D}) =
\prod\limits_i p(\theta_i | \mathcal D)\) 来得到参数,
这里假设参数互相独立, 这么估计很孬
更好的方法是 \(p(\theta_i|\mathcal D) =
\mathcal N(\mu_i, \sigma_i)\), 我们还是在 Lecture 13
中重新讲吧……这是后验分布的数学问题
这里的复杂数学逻辑链是: 引入认知不确定性 -> 计算后验分布 \(p(\theta | \mathcal{D})\) -> 引入变分分布近似 -> 放缩得到证据下界 ELBO -> 继续推导得到 ELBO 与 KL 散度的关系 -> 变分自编码器 VAE 解决问题
简单得到下个状态的方法是神经网络集成(Bootstrap
Ensembles), 同时训练 5~10 个独立初始化的神经网络,
用这几个网络预测结果的方差来代替不确定性, \(\int p(\mathbf{s}_{t+1}|\mathbf{s}_t,
\mathbf{a}_t, \theta)p(\theta|\mathcal{D}) \text d\theta \approx
\dfrac{1}{N} \sum\limits_i p(\mathbf{s}_{t+1}|\mathbf{s}_t,
\mathbf{a}_t, \theta_i)\)
为了防止所有网络收敛到一样, \(\theta_i\) 训练在 \(\mathcal{D}_i \in \mathcal D\) 上,
不过有时候 random 初始化网络就够了
假设我们训练了 \(N\) 个不同的模型,
为了防止 Model Exploitation, 我们规划的目标为
\[
J(\mathbf{a}_1, \dots, \mathbf{a}_H) = \frac{1}{N} \sum_{i=1}^N
\sum_{t=1}^H r(\mathbf{s}_{t,i}, \mathbf{a}_t), \quad \mathbf{s}_{t+1,i}
= f_i(\mathbf{s}_{t,i}, \mathbf{a}_t)
\] 步骤如下, Step 1 等价于选择 \(N\) 个模型中的一个

这不是唯一的方法, 还有 Moment Matching(矩匹配) 方法与
BNNs(贝叶斯神经网络) 等方法
通过对不确定性的估计, model-based RL 可以变得又快又好
这里重要的论文是 PILCO, 这是知乎分析: Model-Based RL Ⅲ: 从源码读懂PILCO - 知乎
divert 一下, 介绍一下 Model-Based RL with Images 领域
图像的处理困难点是高维, 冗余信息过多, 部分可观测性 \(\mathbf o \in \mathbf s\)
我们要学习 $p(o_t|s_t), p(s_{t+1}|s_t, a_t), p(r_t|s_t, a_t) $

如果全观测了, \(\mathbf o = \mathbf
s\), 那么用最大似然训练, \(\max\limits_\phi \dfrac{1}{N} \sum\limits_{i=1}^N
\sum\limits_{t=1}^T \log p_\phi(\mathbf s_{t+1,i} | \mathbf s_{t,i},
\mathbf a_{t,i})\)
如果部分可观测, 使用隐空间模型, \(\max\limits_\phi \dfrac{1}{N} \sum\limits_{i=1}^N
\sum\limits_{t=1}^T \mathbb{E} [\log p_\phi(\mathbf s_{t+1,i} | \mathbf
s_{t,i}, \mathbf a_{t,i}) + \log p_\phi(\mathbf o_{t,i} | \mathbf
s_{t,i})]\)
唉, 我们不知道 \(\mathbf s\) 是什么,
只能用后验分布算似然; 这个 \(\mathbb
E\) 来自分布 \((\mathbf s_t, \mathbf
s_{t+1}) \sim p(\mathbf s_t, \mathbf s_{t+1} | \mathbf o_{1:T}, \mathbf
a_{1:T})\), 即期望基于 "给定所有图像和动作后,
隐状态可能是什么的后验分布" 来计算
这个后验分布确实很吓人, 我们还是直接上神经网络 \(q_{\psi}\), 有几种方法构建这个
encoder
一是 \(q_\psi(\mathbf{s}_t | \mathbf{o}_{1:t},
\mathbf{a}_{1:t})\), 模型根据从第 1 步到当前第 \(t\) 步的所有看到过的图像和动作,
来推断当前的隐状态
二是 \(q_\psi(\mathbf{s}_t, \mathbf{s}_{t+1} |
\mathbf{o}_{1:T}, \mathbf{a}_{1:T})\), 一个全平滑后验编码器,
开天眼看未来决定隐状态, 最准确但最复杂
三是 \(q_\psi(\mathbf{s}_t |
\mathbf{o}_t)\), 当场看当场猜, 最简单但最不准确
我们先考虑 \(q_\psi(\mathbf{s}_t | \mathbf{o}_t)\) 最简单的情况, 假设是确定性策略, 有 \(\mathbf s_t = g_\psi(\mathbf o_t)\), 那这还要什么期望, 直接有 \[ \max_{\phi, \psi} \frac{1}{N} \sum_{i=1}^N \sum_{t=1}^T \log p_\phi(g_\psi(\mathbf{o}_{t+1,i})|g_\psi(\mathbf{o}_{t,i}), \mathbf{a}_{t,i}) + \log p_\phi(\mathbf{o}_{t,i}|g_\psi(\mathbf{o}_{t,i})) \] 因为全部是确定性策略, 梯度丝滑流转, 一切皆可微

这个方向比较出名的文章是 Embed to Control 这篇, 虽然有人说比较 toy, 但是可以看到随着训练, 学习的 latent space 越来越像实际 latent space 了
如果直接在图像空间学习呢?直接学 \(p(\mathbf o_{t+1}|\mathbf o_t, \mathbf
a_t)\) 也是可以的, 额, 也许可以
首先直接预测像素有误差累计爆炸, 然后有随机性下的平均化(画面糊成一团),
还有很多视觉冗余与无效计算
不过 有些文章 确实这么干成功了, 通过不输出 RGB 颜色而是输出空间变换核与掩码来避免模糊, 极短预测时序与重规划避免误差爆炸, 至少能做短视野任务, 后面主流还是上 latent space 了
Lecture 12 Model-Based Policy Learning
学完这个 lecture, 以后当人家问你什么是 MBA 的时候就可以即答: Model-Based Acceleration!
回顾一下 Model-based RL version 1.5

我们的开环策略是 sub-optimal 的, 闭环策略, 例如 iLQR 是 Local
的
如果转向深度学习方法, 即建立计算图, 反向传播梯度, 计算给定策略奖励综合,
是否可以呢?
下面先从确定性策略开始讲,
因为随机策略的梯度都可以通过重参数化来实现
这里有三个函数, policy \(\pi\),
动态环境 \(f\), 奖励函数 \(r\)

与 version 1.5 相比, 我们有了显式策略网络而不是规划算法, 原来的方法像是下围棋, 每走一步都要在脑子里往后推演十几步, 然后重新推演; 现在的方法运行时无需规划(训练训完了), 只要无脑 \(\mathbf{a} = \pi_\theta(\mathbf{s})\) 即可
这里的问题和 RNN 中会出现的问题一样, 梯度爆炸或消失,
我们能不能套用之前的方法来解决?
首先, 没有简便的 LQR 方法解决问题, 因为 \(\pi_\theta\) 参数固定, 在每个时间步上一致,
就不能拆成每步上的子问题
然后, RNN 的方法(例如 LSTM)不能直接使用, 因为状态的转移 \(\mathbf{s}_{t+1} = f(\mathbf{s}_t,
\mathbf{a}_t)\) 必须去模拟真实世界, 我们不能强行加入 LSTM
门控通道这样的结构, 否则 \(f\)
不再准确, 而且我们也保护不了 \(\theta\)
的梯度爆炸
这里的一种解决方法是——投降
我们训练模型 \(f(\mathbf{s},
\mathbf{a})\) 是可以做到的, 因为我们只对 \((\mathbf{s}, \mathbf{a}, \mathbf{s}')\)
单步算 loss 来优化模型
我们利用 \(f\) 优化策略 \(\pi_\theta\) 是极为困难的,
因为要多步时序梯度反传, 随时爆炸啊
那么我们就不要导数了, 用 model-free 的方法, model-free
本身不是采样效率低吗?我训出来 \(f(\mathbf{s},
\mathbf{a})\) 后直接在上面采样不就行了?然后跑 PPO, SAC,
其他什么东西都可以了
回忆一下 policy gradient 方法, \(\nabla_\theta J(\theta) \approx \dfrac{1}{N}
\sum\limits_{i=1}^N \sum\limits_{t=1}^T \nabla_\theta \log
\pi_\theta(\mathbf{a}_{i,t}|\mathbf{s}_{i,t})
\hat{Q}_{i,t}^\pi\)
在这里, 我们的 \(\hat{Q}_{i,t}^\pi\)
作为 reward 估算是由动力学模型 \(f(\mathbf{s},
\mathbf{a})\) 生成的轨迹算出来的, 其导数并没有参与上式
如果完全使用反向传播, 有 \[
\nabla_\theta J(\theta) = \sum_{t=1}^T \frac{d\mathbf{a}_t}{d\theta}
\frac{d\mathbf{s}_{t+1}}{d\mathbf{a}_t} \left( \sum_{t'=t+1}^T
\frac{dr_{t'}}{d\mathbf{s}_{t'}} \left(
\prod_{t''=t+2}^{t'}
\frac{d\mathbf{s}_{t''}}{d\mathbf{a}_{t''-1}}
\frac{d\mathbf{a}_{t''-1}}{d\mathbf{s}_{t''-1}} +
\frac{d\mathbf{s}_{t''}}{d\mathbf{s}_{t''-1}} \right)
\right)
\] 里面的 \(\prod\)
把梯度都毁了, 于是我们现在使用 Model-based RL via policy gradient

先训模型 \(f\), 再训 policy \(\pi\), 然后左脚踩右脚上天, 这里的问题还是
\(f\) 的问题, \(f\) 能生成正确的 \(\{ \tau_i \}\) 吗?
错误积累的速度仍然是 \(\mathcal O(\epsilon
T^2)\)
怎么解决这个问题?也许我们可以继续投降, 我们只做
short rollout, 不过单纯的 short rollout 会让我们短视,
我们可以拿一些现实世界的 long rollout 出来, 在中间 split 出一些 short
rollout
这里的问题在于状态的分布改变了, 它是现实与虚拟的混合, 这里可能需要一些
trick 去防止大幅分布跳变
于是我们有了 version 3.0

Dyna-Q 算法将 Online Q-learning 与 model-free RL with a model 结合到了一起

这里的步骤 1-2 是与真实世界交互的, 得到 \((\mathbf{s}, \mathbf{a}, \mathbf{s'},
r)\)
然后步骤 3-4 开始学习 \(\hat{p}(\mathbf{s'}|\mathbf{s},
\mathbf{a})\) 与 \(\hat{r}(\mathbf{s},
\mathbf{a})\), 并进行 Q-learning 更新
在步骤 5-7 中开始虚拟演练, 每次从以前经历过的状态和动作缓存 \(\mathcal{B}\) 中,
随机抽样出一个曾经到过的状态 \(\mathbf{s}\) 和动作 \(\mathbf{a}\), 使用 \(\hat p, \hat r\) 模拟一步得到 \(\mathbf{s'}\) 并得到 \(r\), 用虚拟经验再次更新 Q
函数
上面的步骤 5-7 可以进行一些更改, 例如从队列里挑 Q 值变化最大的状态的前置状态来更新, 或者选择当前最新策略 \(\pi\) 产出的动作, 或者模拟多步轨迹而不是一步, 这些东西都是 Dyna-style 的

于是我们可以把 Q-learning 的图解画得更加花里胡哨

MBA, PMLR 2016
和上面的 Dyna-Style 没啥区别
MBVE, ICML 2018
作出重要指示, 不要把模型数据降级为普通的 Replay Buffer 碎片,
而是用它来精确校准目标价值估计(Value Expansion)
显然, 随着 horizon 长度变长, model error 也在不断变大, 我们设前 \(H\) 步能够精确估计, 后面就用 Q 函数, 当
\(H=0\) 时就是 DDPG, 有类似 \(y_{\text{MVE}} = \sum\limits_{t=0}^{H-1} \gamma^t
\hat{r}(\mathbf{s}_t, \mathbf{a}_t) + \gamma^H \max\limits_{\mathbf{a}}
Q(\mathbf{s}_H, \mathbf{a})\) 这样的东西
MBPO, NeurIPS 2019
使用模型集合(ensemble) + short rollout, 然后数学证明了一些 bound,
可以动态控制展开步数 \(H\), 感觉很
Soild 啊, 看不懂, 有一份知乎解析
divert 一下, 这次的主题是后继表示(Successor Representations, SR)
与其预测 "未来会得到多少奖励", 不如先预测 "未来会遇到什么"
等任务告诉我们喜欢什么之后, 再把两者做一次点积
通常, 评估策略 \(\pi\) 的价值 \(V_\pi(\mathbf s_t)\)
需要知道环境的状态转移概率 \(P(\mathbf
s'|\mathbf s, \mathbf a)\) 和奖励函数 \(r(\mathbf s)\)
我们能不能不显式建模单步转移概率 \(P\)
就完成评估?只要把 状态转移 和 即时奖励 解耦就可以做到, 因为 \[
\begin{aligned}
V^\pi(\mathbf s_t) &= \sum_{t=t'}^{\infty} \gamma^{t'-t}
E_{p(\mathbf s_{t'}|\mathbf s_t)} [r(\mathbf s_{t'})] \quad
(先忽略 \;\mathbf a) \\
&= \sum_{t=t'}^{\infty} \gamma^{t'-t} \sum_{\mathbf s}
p(\mathbf s_{t'} = \mathbf s|\mathbf s_t) r(\mathbf s) \\
&= \sum_{\mathbf s} \left( \sum_{t=t'}^{\infty}
\gamma^{t'-t}p(\mathbf s_{t'} = \mathbf s|\mathbf s_t)
\right)r(\mathbf s) \\
&= \sum_{\mathbf s} \left( p(\mathbf s_{\text{future}} = \mathbf
s|\mathbf s_t) \right)r(\mathbf s) \\
&= \frac{1}{1-\gamma} \mu^\pi(\mathbf s_t)^{\top} \vec r \quad
(向量化所有可能的 \;\mathbf s)
\end{aligned}
\] 这里的 \(\mu^\pi(\mathbf
s_t)\) 代表从状态 \(\mathbf
s_t\) 出发, 在策略 \(\pi\) 下,
未来访问状态 \(\mathbf s'\)
的总折扣期望次数, 它就是后继表示
上面的式子把 \(r\) 干净摘了出来,
启示我们, 如果想要改变奖励函数(但环境动力学不变),
你不需要重新计算状态转移, 只需要重新用新的 \(r(\mathbf s)\)
代入这个公式做一次点积即可
我们可以把 \(\mu^\pi(\mathbf s_t)\) 看作是价值函数与模型的某种混合体, 它与奖励无关, 有贝尔曼方程展开 \[ \begin{aligned} \mu_i^\pi(\mathbf{s}_t) &= (1 - \gamma) \sum_{t'=t}^\infty \gamma^{t'-t} p(\mathbf{s}_{t'} = i | \mathbf{s}_t) \quad (1-\gamma 只是归一化常数)\\ &= (1 - \gamma)\delta(\mathbf{s}_t = i) + \gamma \mathbb{E}_{\mathbf{a}_t \sim \pi, \mathbf{s}_{t+1} \sim p} [\mu_i^\pi(\mathbf{s}_{t+1})] \end{aligned} \] 这里的 \(\delta(\mathbf{s}_t = i)\) 是 0/1 指示函数代表当前状态为 \(i\), 然后加上后续可能到达 \(i\) 状态的次数乘以折扣 \(\gamma\)
我们学习后继表示不一定有 Model-free RL 容易, 这里的 \(\mu\) 也不能处理大型状态空间或是连续状态空间(可能得上概率密度了)
可以用后继特征(Successor Features,
SF)来处理大型状态空间, 有 \(\psi_j^\pi(\mathbf{s}_t) = \sum_{\mathbf{s}}
\mu_{\mathbf{s}}^\pi(\mathbf{s}_t)\phi_j(\mathbf{s})\)
我们引入了特征映射 \(\phi(\mathbf{s})\)
(投影/神经网络) 获得映射后的后继特征 \(\psi^\pi(\mathbf{s}_t)\)
我们还要同时对奖励函数 \(r\) 做这个,
这里有假设 \(r(\mathbf{s}) =
\phi(\mathbf{s})^{\top} \mathbf{w}\), \(\mathbf w\)
可以直观理解为对于特征的偏好
可以推出目前 \(V^\pi(\mathbf{s}_t) =
\psi^\pi(\mathbf{s}_t)^{\top} \mathbf{w}\), 加入动作后也能得出
\(Q^{\pi}(\mathbf s_t, \mathbf a_t) \approx
\psi^{\pi}(\mathbf s_t, \mathbf a_t)^{\top} \mathbf w\)
如果特征的数量远少于状态的数量, 学习它们会容易得多
如何使用后继特征呢?
一个想法是恢复 Q 函数: 训练 \(\psi^\pi(\mathbf
s_t, \mathbf a_t)\), 获得一些样本 \(\{
\mathbf s_i, r_i\}\), 更新 \(\mathbf w
\leftarrow \arg \min_{\mathbf w} \sum_i \| \phi(\mathbf s_i)^{\top}
\mathbf w - r_i \|^2\), 然后就能使用 \(Q^{\pi}(\mathbf s_t, \mathbf a_t) \approx
\psi^{\pi}(\mathbf s_t, \mathbf a_t)^{\top} \mathbf w\) 恢复
\(Q^\pi\) 了, 额, 或者也不用,
可以直接做 \[
\pi'(\mathbf s) = \arg \max_{\mathbf a} \psi^\pi(\mathbf s, \mathbf
a)^{\top} \mathbf w
\] 相当于一步策略迭代, 哎呀, 这里的 Q 函数不是最优的
要想改进一点, 我们可以从多个 policy \(\pi\) 开始, 训练 \(\psi^{\pi_k}(\mathbf s_t, \mathbf a_t)\), 获得样本 \(\{ \mathbf s_i, r_i\}\), 更新 \(\mathbf w\), 做每一个 \(Q^{\pi_k}(\mathbf s_t, \mathbf a_t) \approx \psi^{\pi_k}(\mathbf s_t, \mathbf a_t)^{\top} \mathbf w\), 于是有 \[ \pi'(\mathbf s) = \arg \max_{\mathbf a} \max_k \psi^{\pi_k}(\mathbf s, \mathbf a)^{\top} \mathbf w \] 这个过程被称为 SF-GPI 框架, 用旧策略预测未来特征, 用新样本识别目标向量 \(\mathbf{w}\)(通过 \(r = \phi^{\top} \mathbf{w}\)), 在每一个 \(\mathbf s\) 下, 动态挑选过去最擅长处理这种局面的专家经验, 从而训练出 \(\pi'\)
最后一个问题是扩展到连续空间, 此时 \(\delta(\mathbf s_t = i) = 0\),
不能这么做
我们把这个问题变成一个二分类问题, 判断 \(\mathbf s_{\text{future}}\) 在不在未来上,
下面的 \(F=1\)
代表这个样本来自条件未来分布 \[
p^\pi(F = 1 | \mathbf{s}_t, \mathbf{a}_t, \mathbf{s}_{\text{future}}) =
\frac{p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t,
\mathbf{a}_t)}{p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t,
\mathbf{a}_t) + p^\pi(\mathbf{s}_{\text{future}})}
\] 我们想要训练这个分类器, 正样本为 \(\mathcal{D}_+ \sim
p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t, \mathbf{a}_t)\),
负样本为 \(\mathcal{D}_- \sim
p^\pi(\mathbf{s})\) (总不能正好随到 \(\mathbf s_{\text{future}}\) 吧)
于是同理把 \(F=0\)
的一坨式子写出来叠一起消一消, 有 \(\dfrac{p^\pi(F = 1 | \mathbf{s}_t, \mathbf{a}_t,
\mathbf{s}_{\text{future}})}{p^\pi(F = 0 | \mathbf{s}_t, \mathbf{a}_t,
\mathbf{s}_{\text{future}})} =
\dfrac{p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t,
\mathbf{a}_t)}{p^\pi(\mathbf{s}_{\text{future}})}\),
即 \(\dfrac{p^\pi(F = 1 | \mathbf{s}_t,
\mathbf{a}_t, \mathbf{s}_{\text{future}})}{p^\pi(F = 0 | \mathbf{s}_t,
\mathbf{a}_t,
\mathbf{s}_{\text{future}})}p^\pi(\mathbf{s}_{\text{future}}) =
p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t, \mathbf{a}_t)\),
这里的 \(p^\pi(\mathbf{s}_{\text{future}})\)
只是一个常数
这就是 C-Learning 的思想, 它是 on-policy 的, 但还能进一步扩展到 off-policy 上, 我们通过学习分类器, 得到了概率密度, 所以叫做 Classification-based Learning

SR: 未来会访问每个离散状态多少次?
SF: 状态太多时, 未来会积累多少种特征?
SF-GPI: 奖励变化后, 怎样组合多个旧策略快速行动?
C-Learning: 状态连续时,
怎样用分类器学习未来状态的条件密度或密度比?
Dreamer 补充
这个方向也可以作为 Lec 18-20 的补充……对 ELBO 不够了解的可以去看看, 我只是忍不住提前把它展示给你, 毕竟我看完 Dreamer 系列文章的时候也没学到后面那里, 如果我知道后面要学的话可能也还是忍不住先读完 Dreamer

不, 我们不说 Model-based RL, 不够高端, 我们说 World Model
世界上有这么多 World Model, 例如 JEPA(LeCun 讨厌 RL, 但感觉做得挺像 RL
啊), \(\pi_{0.7}\)(具身智能, 不如
gpt6), Atlas(怎么这么多叫 Atlas
的东西?), Seedance(Video World Model), etc.
我们介绍 Dreamer-style World Model, 它足够新, 足够轻量化(除了
DreamerV4), 足够 RL, 而且足够有趣
对它的理解我个人给出三点直观: 基于像素重建, RNN/Transformer 方法与 latent space, Loss 函数挺复杂
还是先训 Model, 再训 policy(例如 Actor-Critic), 然后循环左脚踩右脚上天, 我们主要关心 Model 的训练部分, 在 DreamerV2 中是这样的

这里的 \(x_t\) 是 Atari Game 的单帧画面, \(z_t\) 是图像的隐状态, \(h_t\) 是整个 World 的隐状态, 我们说这里面有很多模型

核心是 RNN Model 构造 World 隐状态 \(h\) 在时间轴上前进
Representation model 训练 \(x_t \to
z_t\) 的压缩映射, 我们认为如果 World Model 可以从比 \(x_t\) 更小的特征 \(z_t\) 中重建出 \(\hat x_t\) 与 \(x_t\) 相似,
那么代表我们已经得到了这个世界的 Dynamic(这是 Image predictor
部分)
如果 Transition predictor 能通过 \(h_t\) 猜测到下一帧图像的特征 \(\hat z_t\) 尽可能接近 \(z_t\), 那么代表我们学会了世界的
Dynamic
学完 \(h_t, z_t\) 之后就天高任鸟飞了,
可以训练模型来得到 reward 和 done 指标
这里的所有 Model 合起来可以称作 World Model
有很多 trick 值得一讲, 首先, 总 World Model Loss 为下式, 其实大有来头

\(\hat z\) 是先验的, \(z\) 是表征(representation)的, 这里的 \(z\) 不是对角高斯, 而是包含多个分类变量的向量(32x32), 因此优化方式从 reparameterization gradients 变为了 straight-through gradients, 即
1 | sample = one_hot(draw(logits)) # sample has no gradient |
前向 one-hot, 反向 softmax, 这么搞是有偏但方差低的, 直接 one-hot draw 就容易跳变了
另外一个训练 trick 是 KL-balance trick, 强调先验 \(\hat z\) 近似后验 \(z\) 再训后验接近先验, \(\alpha = 0.8\)
让先验接近后验: 训练世界模型的预测能力
让后验接近先验: 约束图像编码结果,
防止后验随意编码大量先验无法预测的细节

不学就用 stop-gradient, 因为后验一开始是准的, 而先验 \(\hat z\) 在 \(h\) 没训练好前是一坨, 不要强行让后验接近先验
对于 Actor-Critic 部分其实比较简单, 当前实现取
imagine_context_length=4 的真实序列, 利用真实状态和动作建立
Transformer 的历史 KV cache, 然后从末端嫁接 16 步 imagined rollout
然后真实 sample_reward 和 sample_termination
被丢弃, Actor-Critic 只使用 imagined suffix
这样可以解决真实与想象边界的分布跳变问题
DreamerV3 与 V2 的区别仅仅在于更 robust 的工程, 避免了调 5-8 个神经网络超参的陷阱
使用了 Symlog + Two-hot loss + Symexp
Symlog 压缩目标尺度, \(\text{symlog}(x) =
\text{sign}(x) \log(|x|+1)\)
Two-hot 把回归变成分类, 将 Symlog 后的目标投到两个相邻的固定区间上,
例如目标位于 2 和 3 之间的 30% 处, 就使用 \([0.7,0,3]\) 作为这两个类别的目标,
再使用交叉熵训练
Symexp 负责恢复真实尺度 \(\text{symexp}(x) =
\text{sign}(x) \exp(|x|+1)\)
训练损失在压缩后的空间计算, 即使最终价值跨度很大,
训练过程看到的数值范围仍然较小
DreamerV3 的 Actor loss 看起来十分吓人, \[
J(\theta)=\sum_{t=1}^{T}
\operatorname{sg}\left(\frac{R_t^\lambda-v_\psi(s_t)}{\max(1,S)}\right)
\log\pi_\theta(a_t\mid s_t)+\eta H[\pi_\theta(\cdot\mid s_t)] \\
\mathcal L_{\mathrm{actor}}=-J(\theta)
\] 其中 \(S=\operatorname{EMA}\left(\operatorname{Percentile}_{95}(R_t^\lambda)-\operatorname{Percentile}_{5}(R_t^\lambda),
0.99\right)\), 用回报的 95% 分位数与 5% 分位数之差,
估计当前回报范围, EMA 代表指数移动平均, 在 DreamerV3 中 \(m_t=0.99m_{t-1}+0.01x_t\)
这样一来, 稀疏奖励不放大噪声, 大型奖励缩小 Advantage
DreamerV3 的 Actor-Critic 可以理解为: 先用世界模型生成一批潜在空间中的虚拟经验, 再把它当作 on-policy 轨迹, 用分布式 Critic 学习 λ-return, 用 REINFORCE 更新 Actor
Actor 和 Critic 都接收 \(s_t = (h_t,
z_t)\), 两个网络是相互独立的 3 层 MLP
每轮训练先从 replay buffer 采样真实序列 \((x_{1:T},a_{1:T},r_{1:T},c_{1:T})\),
经过世界模型编码和 RSSM 推理, 得到真实观测对应的后验状态 \(s_t = (h_t, z_t)\), 从这儿开始展开最多
\(H=15\) 的 imagine rollout
Critic 拿 Two-hot loss 算, Actor 拿 Critic 做 baseline 算 REINFORCE
类似物, 梯度不穿过 Critic
DreamerV4
已经到达重工业了, 这才像 World?
我们说 DreamerV2 22M Param(20M World, 1M Critic, 1M Actor)
DreamerV3 200M Param
DreamerV4 2B Param(400M for the tokenizer and 1.6B for the dynamics
model)

Transformer, Flow matching, Offline RL(On Minecraft diamond), 100h
label, Scalable
感觉这个方向也到了某种 scaling 时代, 个人玩不转了
最近看到了 STORM 这篇文章, 可以称作 DreamerV3 lite?

把 RNN 换成两层 Transformer, image decode 不用 \(h,z\) 只用 \(z\), 同时 \(z\) 也只用 \(x\) 而不是 \(h,x\) 来 encode
轻量化, 训得快, 而且比 DreamerV3 效果好(在 Atari 100k benchmark 上),
有点神奇
Lecture 13 Exploration 1
为什么 RL 玩有的游戏比其他游戏更加困难?为什么 Alpha-Go 在十年前就打败了所有人, 而 RL 至今还无法打通 Minecraft?(其实 DreamerV4 已经可以 offline RL 挖到钻石了)这一局面为什么会产生?我们能怎样挽救这一局面?
RL 的问题随着 task 的扩展程度以及对规则的理解多少而变得越来越困难
探索与利用需要权衡(Exploration-exploitation balance)
探索问题有两种潜在定义:
智能体如何发现高回报策略?这些策略需要复杂行为,
而这些行为单独来看并不会带来回报
智能体如何决定是尝试新的行为(以发现回报更高的行为),
还是继续做它目前所知的最佳行为?
我们做以下定义
利用(Exploitation): 做已知能带来最高回报的事情
探索(Exploration): 做以前从未做过的事情, 希望获得更高的回报
我们想问能不能直接得到圣杯, 获得 Optimal Exploration
Strategy
首先, 什么是 Optimal?
我们衡量探索策略的指标是 regret, 我们希望其在时间步长 \(T\) 上相较于最优策略的差距最小, 即下式最小
\[
\text{Reg}(T) = T \mathbb E(r(a ^\star)) - \sum_{t=1}^T r(a_t)
\] 然后,
所有问题都可解吗?有一个简单的光谱来帮你判断问题的复杂程度

最简单的多臂老虎机或者上下文老虎机只需要我们做出 1-step,
可以把它们很容易转化为 MDP 或 POMDP,
对于 small, finite MDPs, 我个人的理解就是一个动态规划过程,
或者说建模成一个贝叶斯模型
对于 large inftyite MDPs, 我们在理论上束手无策,
只能做一些技巧与经验优化
什么是 Bandit?老虎机?赌博机器?土匪?
Bandit 是探索中最简单的模型, 我们近似理解为老虎机
单臂老虎机(one-armed bandit) 中的唯一动作是拉拉杆 \(\mathcal A = \{\text{pull arm}\}\),
然后会得到奖励分布中抽取的奖励
多臂老虎机(multi-armed bandit) 可以理解为一排老虎机,
问题变成了玩哪台最赚, 有时候问题是求最高累计收益,
你可以想象我们的探索过程先是把每台机子试一试最后固定玩某些机子
我们形式化一点, 对于 multi-armed bandit, 动作 \(a_i\) 对应奖励 \(r(a_i)\)
我们假设 \(r(a_i) \sim
p_{\theta}(r_i)\), 这里的 \(\theta_i
\sim p(\theta)\) 满足某种未知的先验分布,
不过我们可能也有一些先验知识
每个 \(\theta\)
对应一个动作的奖励分布参数, 对于离散 Bernoulli 奖励, 为: \(p(r_i = 1)=\theta_i,
\;\;p(r_i=0)=1-\theta_i\)
我们将其定义为 POMDP, 其中状态 \(\mathbf s
= [\theta_1, \dots, \theta_n]\), 如果我们知道了 \(\mathbf s\), 选择最高的 \(\theta_i\) 对应的老虎机即可
但我们不知道, 不过我们有信念(belief)!我们的信念是
\(\hat p(\theta_1, \dots, \theta_n)\),
每拉动一次拉杆, 你观察到它的奖励, 然后你更新对那个 \(\theta\) 的信念
但是, 即使对于二元状态, belief state 也太大了,
首先可能各个臂具有某种相关性(eg. 共享结构, 正负相关), 此时状态在 \(n\) 维连续空间 \([0,1]^n\) 上; 即使各个臂相互独立, 要寻找
\(n\) 个参数, 随着规划步长的增多, 也有
\(n^T\) 的历史数规模,
我们并不指望直接解出来这个 POMDP
我们可以掏出一种, 两种, 三种探索方法!
很多方法在 \(\mathcal O\) 上的 regret
是一致的, 但是在实操中不同
第一种方法是乐观探索(Optimistic exploration),
为每个动作 \(a\) 估计平均奖励 \(\hat \mu_a\)
至于利用, 最简单的方式为 \(a = \arg \max \hat
\mu_a\),
更好的方法是 \(a = \arg \max \hat \mu_a + C
\sigma_a\), 这样它就会选中那些你不确定的动作,
从而达到探索的目的,
这里的 \(\sigma_a\) 是与方差相关的指标,
例如 UCB(Upper Confidence Bound) 方法 \[
a = \arg \max \hat \mu_a + \sqrt{ \frac{2 \ln T}{N(a)}}
\] 其中 \(N(a)\) 是动作 \(a\) 被选择的次数, 我们可以证明遗忘量级是
\(O(\log T)\) 的,
这是多臂老虎机渐进最优的结果了
乐观探索是一种 Model-free 的方法, 我们没有建模这种不确定性,
只是在算次数
第二种方法是概率匹配/后验抽样(Probability matching/posterior
sampling)
整体思想是保持信念 \(\hat p(\theta_1, \dots,
\theta_n)\), 假设 belief state 是完全准确的并根据其选择最优策略,
最后更新 belief state中的参数
我们在理论上得不到什么保证, 但实践中它跑得很好
第三类方法使用某种信息增验(Information gain)
信息增验的思想为选择能最大减少不确定熵的方向来探索
假设有隐变量 \(z\), 我们做出观察 \(y\), 这个 \(y\) 是在给定的 belief 下最能够减少熵 \(\mathcal H\) 的 \(y\), 我们定义 信息增验IG
为 \[
\text{IG}(z,y) = E_y [ \mathcal H(\hat p(z)) - \mathcal H(\hat p(z)|y) ]
\] 一般来讲, 观察 \(y\)
取决于动作 \(a\), 于是有 \[
\text{IG}(z,y|a) = E_y [ \mathcal H(\hat p(z)) - \mathcal H(\hat
p(z)|y)|a ]
\] 这里的 \(E_y\) 严格来说是
\(E_{y \sim p(y|H_t, a)}\), 其中 \(H_t\) 是历史信息 \((s_1,a_1,r_1,\dots,s_t)\)
这里的进一步 trade-off 是 balance 信息量大的动作与次优动作的探索,
给一个示例

总结一下三种方法

这三种方法都有不确定性估计, 假定新信息的某种价值(UCB 假设未知情况是好的, Thompson sampling 假设采样得到的数据为真, IG 假设信息增益越大越好)
接下来我们关心一些能在 Deep RL 中起作用的探索, 我们有一些 bandit 中的直觉, 包括:
- 新状态是好状态、exploration bonus (eg. \(\sqrt{\dfrac{2 \ln T}{N(a)}}\))、状态访问计数
- 学习 Q-functions 或 policy 上的 belief 分布
- 新状态的 Information Gain
从 Optimistic exploration in RL 开始,
例如我们可以计数 \(N(\mathbf s, \mathbf
a)\) 或 \(N(\mathbf s)\),
然后定义 \(r^{+}(\mathbf s, \mathbf a) =
r(\mathbf s, \mathbf a) + \mathcal B(N(\mathbf s))\)
这种方法简单高效, 但是需要调整奖励权重与计数问题
如何计数?如果是某种连续情形怎么计数呢?我们利用相似性
我们拟合某种密度模型到 \(p_\theta(\mathbf
s)\) 或 \(p_\theta(\mathbf s, \mathbf
a)\) 上, 然后尝试能不能定义出某种 pseudo-count
对于传统的 MDP, 在 \(\mathbf s\)
被看到前后, 有

我们希望将其扩展到 \(p_\theta(\mathbf s)\) 与 \(p_{\theta'}(\mathbf s)\) 上, 然后, 我们可以得到 \(\hat N(\mathbf s)\), 还能得到 \(\hat n\)
我们有 \(p_\theta(\mathbf s_i)=\dfrac{\hat
N(\mathbf s_i)}{\hat n}, \; p_{\theta'}(\mathbf s_i)=\dfrac{\hat
N(\mathbf s_i)+1}{\hat n+1}\),
于是可以解得 \[
\hat n = \frac{1-p_{\theta'}(\mathbf s_i)}{p_{\theta'}(\mathbf
s_i)-p_{\theta}(\mathbf s_i)} \\
\hat N(\mathbf s_i) = \hat n p_{\theta}(\mathbf s_i) =\frac{
p_{\theta'}(\mathbf s_i) (1-p_{\theta'}(\mathbf
s_i))}{p_{\theta'}(\mathbf s_i)-p_{\theta}(\mathbf s_i)}
\] 注意我们的 pseudo-count 可能是负的甚至趋向正无穷,
这表示模型观察并学习 \(\mathbf s\) 后,
反而降低了它的预测概率, 这可能是工程上或者步长或者噪声等等引起的, 额,
你应该 clip 掉这种东西并检查代码是不是太烂了
一些常见的奖励函数包括 \(\sqrt{\dfrac{2 \ln n}{N(\mathbf s)}}, \sqrt{\dfrac{1}{N(\mathbf s)}}\) 以及 \(\dfrac{1}{N(\mathbf s)}\), 最后一种的探索奖励衰减很快啊
对于 \(p_\theta(\mathbf s)\),
我们的重要要求是其能够产生密度分数, 而不是产生样本 \(\mathbf s \sim p_\theta\)
所以像是 GAN 这样的生成器被我们抛弃了, 而使用 EX2 这样的模型, 为当前状态
\(s^\star\) 构造一个二分类问题,
我怎么好像看过这个思路呢?
如果分类器能够具体分类 \(\mathbf s\)
与其他状态, 那么说明状态 \(\mathbf s\)
非常新颖(密度很高)
对于每一个观测到的 state \(\mathbf{s}\), 我们拟合一个 classifier 将其与所有过去的 states \(\mathcal{D}\) 区分开, 我们利用 classifier error 来获得 density. 我们认为 \(\{\mathbf{s}\}\) 是 positive, 而 \(\mathcal{D}\) 是 negative
我们可以证明状态的密度 \(p_\theta(\mathbf s) = \dfrac{1-D_{\mathbf s}(\mathbf s)}{D_{\mathbf s}(\mathbf s)}\), 其中 \(D_{\mathbf s}(\mathbf s)\) 为将 \(\mathbf s\) 归类为 positive 的概率
在连续状态空间上需要加噪, 不然所有状态都是新颖的, 要不还是看 知乎笔记 吧
还有一种基于 hash 计数的方法,
其核心思想是在不同的表示下进行常规计数
我们寻找一种 hash 将相似状态映射到相同 hash 值上, \(\mathbf s\) 变成了 k-bit code \(\phi(\mathbf s)\)
这里的 hash function 是一个 auto encoder 网络,
它首先被训练为最大化重建质量, 然后砍掉一半用来做 hash

我感觉这个方法虽然很漂亮, 但也有固有缺陷, 阈值相似关系不是等价关系, 我们所希望得到的前者不具有传递性, 存在 \(A\sim B,\; B\sim C,\;A\not\sim C\) 的情况
还有文章训练一个 reachability network, 维护一个图, 通过 k 阶邻居定义相似性, 或者在 kNN 上构造 pseudo-count, 也都很不错
下面讨论 Posterior Sampling in RL
训练所谓的 belief state 就是训练一个模型
在 MDP 中, 因为动作会影响后来状态, 我们选择 Q 函数, 维护它的近似后验
\(\hat p(Q)\)

一个抽象的东西是, 什么叫做 sample Q-function?
其实就是 Lec 11 的神经网络集成, 在 \(\mathcal D_i \in \mathcal D\)
上训练独立的多个 Q 函数, 采样就是随机挑一个
这也太糙了, 也可以通过训练含有多个头的模型来避免这种昂贵性,
但是也会损失一定独立性
我们通过 random Q 探索而不是 random action 探索是为了防止单步动作的无限震荡, 想象在潜水游戏中需要下降捕鱼以及上升回复氧气, 如果用 random action 大概率会来回上升下降从而憋死自己
random Q 探索不需要改变 reward function, 一般在收敛时所有的 Q 函数都很好, 不过它不是最好的探索方法, bonus 的上限更高
最后讨论 Information Gain in RL
问题是, 需要哪个变量的信息增益?
是 reward?如果 reward 稀疏就没用了
是状态密度 \(p(\mathbf
s)\)?状态密度的信息增多可以理解为出现了新颖状态
还有一种选择是 dynamic, 即 \(p(\mathbf
s'|\mathbf s, \mathbf a)\), 它也与新颖状态相关
但是这些东西在 state space 或 action space 较大时都难以处理, 我们需要近似, 这是 IG in RL 方法的困难所在
于是我们可以最大化预测增益(prediction gain),
它可以近似信息增益, 不, 这里不是 pseudo-count \[
\log p_{\theta'}(\mathbf s) - \log p_{\theta}(\mathbf s)
\] 有论文指出, IG 可以写成 KL 散度 \(D_{\text{KL}}(p(z|y) \| p(z))\), 我们的
\(z = \theta\), \(y= (\mathbf s_t, \mathbf a_t,
\mathbf s_{t+1})\)
于是我们希望最大化 \(D_{\text{KL}}(p(\theta|h,
\mathbf s_t, \mathbf a_t, \mathbf s_{t+1}) \| p(\theta|h))\),
这里 \(h\) 代表历史, 这也是一种 IG,
如果一种转移让对 \(\theta\) 的 belief
发生大幅变化, 那么这是新颖的
\(p(\theta|h)\) 可以代表看完历史数据
\(h\) 后, 我们认为各种环境模型参数
\(\theta\) 分别有多可信
不过这个 \(\theta\)
可能是一个神经网络的数百万个权重, 我们还得做 \(q(\theta|\phi) \approx p(\theta|h)\),
其中 \(q(\theta|\phi) = \mathcal
N(\theta;\mu,\text{diag}(\sigma^2)), \phi=(\mu, \sigma)\),
相当于往一个对角高斯上近似
IG 的数学很吸引人, 但是它们的复杂性使得它们使用更加困难
我们还有更多的启发式方法来进行 exploration, 终究, 我们只需要某种
"新颖分数" 即可
例如, 用 \(\hat f_{\theta}(\mathbf s, \mathbf
a)\) 来拟合 \(f^{\star}(\mathbf s,
\mathbf a)\), 我们可以算它们的 L2 误差, 误差高的地方更加新颖

这里的 \(f^{\star}(\mathbf s, \mathbf
a)\) 最方便的选择是 \(\mathbf
s'\), 另一个选择是一个随机网络 \(\phi\) 下的 \(f_{\phi}(\mathbf s, \mathbf a)\),
我们其实不需要它有太多意义,
我们只希望它(在未访问过的地方)不容易被拟合,
这样我们就会去探索它的边边角角
这种方法叫做 Random Network Distillation(RND), 需要三个网络,
一个随机固定, 一个 RND 预测器, 一个 RL 网络
model error, model gradient, etc. 都可以用来衡量新颖性, 感觉分三类来介绍探索方法还是太少了......
Lecture 14 Exploration 2
我们换个视角, 能不能做 no reward exploration?
我们还能学习到多样化的行为吗? (UNSUPERVISED!)
我们能够得到的 能力/回报 有
- 在无监督的情况下学习 skills, 再利用这些 skills 实现真正的任务
- 学习一系列 sub-skills 并使用 hierarchical RL
- explore 所有可能的行为
我们能为一个未知的未来做准备吗? 能达到真正的智能而不是 ad-hoc 调参吗?
从信息论开始, notations:
\(p(\mathbf x)\) 是 \(\mathbf x\) 的分布,
\(\mathcal H(p(\mathbf x)) = - \mathbb
E_{\mathbf x \sim p(\mathbf x)} [\log p(\mathbf x)]\) 表示 \(p(\mathbf x)\) 的熵,
其可以表示分布覆盖的广泛程度
\(\mathcal I(\mathbf x;\mathbf y) =
D_{\text{KL}} (p(\mathbf x, \mathbf y) \| p(\mathbf x)p(\mathbf y)) =
\mathbb E_{(\mathbf x, \mathbf y) \sim p(\mathbf x, \mathbf y)} \left[
\log\dfrac{p(\mathbf x, \mathbf y)}{p(\mathbf x)p(\mathbf y)} \right] =
\mathcal H(p(\mathbf y)) - \mathcal H(p(\mathbf y|\mathbf
x))\)
这表示变量 \(\mathbf x, \mathbf y\)
之间的互信息(mutual information),
可以从变量独立性与不确定性(熵减)两个方向理解
对于 RL 方面, notations:
\(\pi(\mathbf s)\) 是策略 \(\pi\) 的状态边缘分布(或者说 \(p_\theta(\mathbf s)\))
\(\mathcal H (\pi(\mathbf s))\) 是策略
\(\pi\) 的状态边缘熵, 我们说一个随机
policy 的熵是很大的
在强化学习中有 empowerment 的概念,
其(一种形式)定义为下一个状态与当前动作的互信息, 即 \[
\mathcal I(\mathbf s_{t+1}; \mathbf a_t) = \mathcal H(\mathbf s_{t+1}) -
\mathcal H(\mathbf s_{t+1}|\mathbf a_t)
\] 我们希望 empowerment 大, 这代表我们希望下一个状态熵大,
并且下一个状态熵在当前 action 下较小,
后者代表对环境有控制力(确定性理解), 前者代表探索覆盖较大,
两者结合才有利于探索
现在正式讨论在没有 reward 的情况下通过 reaching goal 来学习
我们如何提出目标? 我们的目标是某个状态,
智能体要学习达到这个状态, 在无监督学习的语境下,
智能体应该要达到提供的任何状态
一种想法就是 latent model, 我们利用 latent space 提出一系列 goals
并且实现

在最最开始, 我们要训练 VAE(或者任意生成模型), 学习 latent space,
包括压缩 \(q_\phi(z|x)\) 与还原 \(p_\theta(x|z)\)
第一步说明我们的 goal 是从隐空间中采样并还原的, 这样 imagined goal
应当接近环境中合理可实现的状态
第二步我们使用策略 \(\pi(a|x,x_g)\)
达到目标, 它可能成功或失败, 反正最终到达了 \(\bar x\)
第三步是更新策略, 有很多种方法
第四步是更新生成模型
这种最简单的方法会导致局部自我强化, 缺少探索,
需要增加未访问状态的权重(Step 4), 这是 Skew-Fit 的思想

总体就是做一个加权最大似然(weighted MLE), \(\theta, \phi \leftarrow \arg \max_{\theta, \phi}
\mathbb E [ w(\bar x)\log p(\bar x) ]\)
这个 \(w(\bar x)\) 就是权重,
现在需要在模型中找出来, 而生成模型本来就能给出密度分数, 于是 \(w(\bar x) = p_{\theta}(\bar
x)^{\alpha}\)
这里的 \(\alpha \in [-1, 0)\),
这样可以增加 \(\mathcal H(p(\mathbf
x))\),
最终收敛到有效状态(latent)上的均匀分布
算法的目标是 \(\max \mathcal
H(p(G))\), RL 的目标是训练最终状态 \(S\) 接近目标 \(G\), 也就是 \(p(G|S)\) 的熵尽可能小
于是总的目标等价于 \(\max \mathcal I(S,G) =
H(p(G)) - H(p(G|S))\), 即最大化互信息
另一种方法要求某种 intrinsic motivation, 这就是, 额, 换一种说法的 reward bonus 项
假设使用 Lec 13 的方法, 我们的探索惩罚状态密度, 用信息熵的说法就是
\(\tilde r(\mathbf s) = r(\mathbf s) - \log
p_{\pi}(\mathbf s)\)
在这里可以把 \(r(\mathbf s)\)
换成你想要的 \(\log p^{\star}(\mathbf
s)\) 做状态分布匹配, 鼓励向目标分布 \(p^{\star}(\mathbf s)\) 看齐
我们的做法一共两步: 更新 \(\pi(\mathbf
a|\mathbf s)\) 来最大化 \(\mathbb
E_{\pi}(\tilde r(\mathbf s))\) 以及更新 \(p_\pi(\mathbf s)\)
这样最后是密度 \(p_\pi\) 均匀覆盖而不是 policy \(\pi\) 均匀覆盖, policy 很可能循环聚焦某部分地方并来回震荡
考虑两个状态: \(\mathcal S=\{A,B\},\; p^\star=(0.5,0.5)\)
假设当前策略访问分布为: \(p_{\pi^1}=(0.9,0.1)\)
那么 \(B\) 很罕见, 内部奖励会强烈鼓励访问 \(B\), 新策略可能变成: \(p_{\pi^2}\approx(0,1)\)
如果现在完全丢掉旧数据, 只用最新策略重新拟合密度, 那么 \(A\) 又变成罕见状态
下一轮策略可能变成: \(p_{\pi^3}\approx(1,0)\), 然后再次反转: \((1,0)\rightarrow(0,1)\rightarrow(1,0)\rightarrow\cdots\)
每一个单独策略都没有匹配目标分布, 只是在两个极端之间振荡
为什么会这样, 你展开 \(\mathbb
E_{\pi}(\tilde r(\mathbf s))\) 就发现不对劲了, 我们加上时间步上标
\(k\)
在更新完 \(p_{\pi^k}(\mathbf s)\) 后,
固定奖励 \(\tilde r^k(\mathbf s) = \log
p^*(\mathbf s)-\log p_{\pi^k}(\mathbf s)\), 下一步训练新策略
\(\pi^{k+1}\), 实际优化的是 \[
\mathbb E_{\mathbf s\sim p_{\pi^{k+1}}} \left[\log p^*(\mathbf s)-\log
p_{\pi^k}(\mathbf s)\right]
\] 而不是 \[
\mathbb E_{\mathbf s\sim p_{\pi^{k+1}}} \left[ \log p^*(\mathbf s)-\log
p_{\pi^{k+1}}(\mathbf s) \right]
\] 正确的做法不是无限的追自己尾巴, 而是拟合之前所有策略的混合, 即
\(\bar\pi_K =
\frac1K\sum_{k=1}^{K}\pi^k\)
最后混合的策略会达到纳什均衡,
我们就要这个混合物(不是最后 step 策略!!!), 纳什均衡很神奇吧
有一个非常简单的结论, 如果你知道目标将会被 adversary 设置成最差的, 那么你就应当训练所有的 state, 最大化状态熵形成均匀分布, 这说明 exploration 是有用的
我们从 goal 转化为 skill, 我希望获得多样化的 skill, 下面分析的文章是
DIAYN
我们的 goal 实际上就是 state, 它只是一个终点, 而 skill 更抽象,
例如机器人跳跃, 周期性奔跑, 旋转
在 2D 导航中, skill 可能对应 上, 下, 左, 右 四种行走方式,
它可能没有终点的概念
我们的 skill 定义为 \(\pi(\mathbf a|\mathbf
s, z)\), \(z\) 只是一个编号
index
这里的直觉是不同的 skill 应当访问不同的状态空间区域(state-action
regions), 反着来说, 假设存在判别器能够根据 \(s\) 判断出 \(z\), 那么我们想要的 policy
应当会主动产生对应不同状态的技能
这好像有点绕, 我其实是故意往类似 GAN 的方向上讲的, 只不过这里不是对抗而是合作

对于 policy 网络, 其奖励为 \(r(\mathbf s,
z) = \log p(z|\mathbf s) \approx \log q_\phi(z|\mathbf s)\),
为了最大化它, 就要为 \(z|\mathbf s\)
分配足够大的概率
最终的目标是 \(\pi(\mathbf a|\mathbf s, z) =
\arg \max\limits_\pi \sum\limits_z \mathbb E_{\mathbf s \sim \pi(\mathbf
s|z)} [r(\mathbf s, z)]\)
从互信息的角度来看, 我们最大化 \(I(z,\mathbf s) = \mathcal H(z) - \mathcal
H(z|\mathbf s)\)
第一项要求每个技能编号都被采样, 第二项要求看到状态后不难判断技能,
这也能推导出 reward
这里互信息的思想确实很巧妙
HER 补充
her 这部电影在 2014 年上映,
讲述了一段比我的笔记精彩万分的人工智能的故事。我知道它很好, 我准备去看,
但还没有时间, 或者说我假装没有时间。
但从另一个方向来看, 我正在慢慢接近 HER。我从白日梦想家电影中的 Wake Up
一曲开始听 Arcade Fire(拱廊之火) 的歌曲, 先是他们拿到格莱美奖的 Funeral
专辑, 然后是六年后的 The Suburbs 专辑, 后面就是他们为 her 做的 OST
了。我最喜欢里面的 Sleepwalker 一曲, 可能因为我很喜欢 sleep, 也经常
walk, 也可能因为我单纯把歌曲的孤独投射在自己上,
尽管我没有主人公的跌宕爱情体验。顺便一提, 他们 25 年的新专烂透了,
不要去听。
可能有点跑题, 我想说的是, 我与 her 的关系其实体现了 HER 的核心思想,
一些错误的探索是有用的。这里的类比是, 虽然我想要看电影, 但是最后失败了,
去听音乐, 如果站在目标为听音乐的视角上, 这就是成功的。一些其他的类比是,
虽然失败了, 但是挺热闹, 获得了追求热闹的成功经验。
HER 全称 Hindsight Experience Replay(事后经验重现), 是一种数据利用方法, 主要定位其实是解决奖励稀疏问题
我们之前的无奖励 RL 其实还是想象了某种奖励/优化量?在 HER
中我们对常用的 MDP \((\mathcal S, \mathcal A,
P, R, \gamma)\) 增加一个目标 \(g \in
\mathcal G\), 这个目标描述了任务希望达到什么样的状态, 如果 \(\mathbf s=g\) 则为完成目标, 反则未完成,
奖励函数就是这个二值的及其稀疏的函数
这里, 我们在 replay buffer 中将 \(\mathbf
s\) 与 \(g\) 拼接, 数据格式为
\((\mathbf s_t \| g, \mathbf a_t, r_{g,t},
\mathbf s_{t+1}\|g)\), 策略变为 \(\pi(\mathbf s, g)\)
由于奖励的稀疏性, 采集到的一条轨迹大概率对于所需要完成的任务来说是失败的, HER 最大的创新是对于轨迹上的每一个 transition 都去计算一下换作其他目标 \(g'\) 该 transition 会怎样, 这样可以大大增加 replay buffer 的样本数量, 有一些选择 \(g'\) 的方法例如
每次只选择这一条轨迹的最后一个状态
使用未来时间步的 \(k\) 个随机状态
使用轨迹上的 \(k\) 个随机状态

由算法流程可知, HER可以结合任意的 off-policy
算法
由实验可知(这里是 robot 的 pushing/sliding/pick-and-place 任务), HER
效果好(甚至好于 reward shaping), 即使所需目标从未遇到过,
最后执行时仍有不错效果
Lecture 15 Offline RL 1
Offline RL 不是 imitation learning, 就像橘子不是太阳一样, 虽然经常有人弄混
目前我们的 RL 方法都带有某种 iteration 的思想, 交互, 收集数据, 改进
policy, 重复
监督方法是怎么做的?它们关心更封闭已知环境,
然后用大量数据使模型泛化(Large Model + Large Dataset)
我们显然不能在 RL 每次迭代中使用全新 rollout 出来的 ImageNet 大小数据集,
但我们想用 data-driven 方法
从 on-policy RL(eg. Policy Gradient) 方法到 off-policy RL(eg.
Q-learning) 方法, buffer 增加了 data-efficiency,
但还是需要当前策略下的收集数据
在 Offline RL 中, 你假设有人(有别的策略)为你收集了 buffer \(\mathcal D\), 我们用这部分数据训练最好的
\(\pi\),
然后它一经部署就不再训练(也可以再训练, 那就是 offline-to-online RL,
但核心是用离线数据直接可以获得部分功能)
 一些 RL 应用不支持完全的 trial and error, 这时候 Offline RL
就是必要的
正式来说, Offline RL 需要 \(\mathcal
D=\{(\mathbf s_i, \mathbf a_i, \mathbf s'_i, r_i)\}\)
其中数据来自其他策略分布, \(\mathbf s \sim
d^{\pi_\beta}(\mathbf s), \mathbf a \sim \pi_{\beta}(\mathbf a|\mathbf
s), \mathbf s' \sim p(\mathbf s'|\mathbf s, \mathbf a), r
\leftarrow r(\mathbf s, \mathbf a)\)
不, 我们不知道这里的 \(\pi_\beta\)
是啥, 我们最终 RL 的目标还是学习最大化折扣奖励的总和的 \(\pi_{\theta}\), 即 \[
\max_\pi \sum_{t=0}^T \mathbb E_{\mathbf s_t \sim d^\pi(\mathbf s),
\mathbf a_t \sim \pi(\mathbf a|\mathbf s)} [\gamma^t r(\mathbf s_t,
\mathbf a_t)]
\]
另一类问题, off-policy evaluation(OPE), 要求给定 \(\mathcal D\), 估计 \(J(\pi_{\beta}) = \mathbb E_{\pi_\beta} \left[ \displaystyle\sum\limits_{t=1}^Tr(\mathbf s_t, \mathbf a_t) \right]\),
这个问题可能比学习 \(\pi_\theta\) 更加困难, 因为 Offline RL 可以寻找保守策略, OPE 就不好处理 OOD 部分了
我们能够学到更好的策略吗?
Offline RL 能够在有好有坏的数据集中学习好的技能(模仿学习会全部模仿,
最后平均下来得到平庸), Offline RL 可以比数据集中的最佳行为更好,
可以理解为模型的能力是数据的凸包?模型可以拼接数据以得到更强能力
Offline RL 可以从混乱中找到秩序,
例如一系列稍弱的人类驾驶行为加起来可能强于最好的单个人类
纯 Offline RL 可能表现不佳, 580k Offline RL 的数据只要加上 28k 的 Online RL 微调就能让 Failure 从 13% 降低到 4%

在 HalfCheetah 中, Offline RL 的 Q 函数估计极大,
然而在训练中表现很差
根本的问题是 counterfactual query(反事实查询), 我们用
\(\mathcal D\) 训练出来的 policy
实际上在 training 时被提问: "对于我们在之前见过状态下的所有动作,
哪一个是最好的?"
有些动作我们见过所以知道好坏, 有些动作我们能够泛化出来好坏,
但是仍然存在动作我们完全没有见过相似的。Online RL 不担心这一点,
因为它们能与真实世界交互获得结果, 总结一下, Offline RL OOD 了,
并且处理不了

这里有一个精密的 trade-off, 如果不处理 OOD 数据就没有泛化, 如果追求泛化就容易错误处理 OOD 数据, out-of-sample 和 out-of-distribution 是有区别的
在统计学中, 这就是分布偏移(Distribution
shift),
在训练传统神经网络 \(\theta\leftarrow\arg\min_\theta \mathbb E_{\mathbf
x\sim p(\mathbf x),y\sim p(y|\mathbf x)} \left[(f_\theta(\mathbf
x)-y)^2\right]\) 时我们知道通常来说的最大预测项 \(\mathbf x^\star=\arg\max_{\mathbf x}
f_\theta(\mathbf x)\) 可以写为 \(f_\theta(\mathbf x)=f(\mathbf x)+\epsilon(\mathbf
x)\) 通常也包含了最大的误差
而我们在做类似 Q-learning 时策略更新会选择 Q 值最大的动作, \(\pi(\mathbf s)\approx\arg\max_{\mathbf a}
Q_\theta(\mathbf s,\mathbf a)\),
这会导致策略可能选择数据集中很少出现甚至完全没有出现的动作, 这些动作
Critic 没有足够监督, Q 值只是神经网络的外推结果。即使当前的 \((\mathbf s,\mathbf a)\) 来自离线数据,
下一步动作 \(\pi(\mathbf s')\)
也可能不在数据集中, target 依赖于未经充分训练的 Q 值,
造成bootstrapping error accumulation(自举误差累积),
最后全都完蛋, 优化过程主动寻找并利用模型的预测错误
我们想寻找比 \(\pi_\beta\) 更好的 policy, 于是疯狂利用 OOD 找那些不确定的下一步, 类似的问题也会出现在 actor-critic 等算法中, 没有 reward signal, 就不能纠正错误
我们介绍一些 Offline 的方法, 从远古的 Batch RL via Importance Sampling 讲起, 回忆一下 Lec 5
在 policy gradient 中, 有 \(\nabla_\theta
J(\theta) = \mathbb E_{\tau\sim p_\theta(\tau)} \left[
\sum\limits_{t=0}^{T} \gamma^t \nabla_\theta\log\pi_\theta(\mathbf
a_t|\mathbf s_t) Q^{\pi_\theta}(\mathbf s_t,\mathbf a_t)
\right]\)
我们的 Offline RL 只有历史数据, \(\tau_i \sim
\pi_\beta(\tau)\), 于是我们用重要性采样修正分布
额, 有点符号滥用, 总不能写成 \(p_\beta(\tau)\) 吧, 重要的是参数变成了 \(\beta\), 下文中可能会 \(p_\theta(\tau)\) 与 \(\pi_\theta(\tau)\) 混用
修正后为 \(\nabla_\theta J(\theta) \approx
\dfrac1N\sum\limits_{i=1}^{N}
\dfrac{\pi_\theta(\tau_i)}{\pi_\beta(\tau_i)} \sum\limits_{t=0}^{T}
\gamma^t\nabla_\theta\log\pi_\theta(\mathbf a_{t,i}|\mathbf s_{t,i})
\hat Q(\mathbf s_{t,i},\mathbf a_{t,i})\), 这里的 \(\dfrac1N\sum\limits_{i=1}^{N}
\dfrac{\pi_\theta(\tau_i)}{\pi_\beta(\tau_i)}\) 就是 \(\mathbb E_{\tau\sim p_\theta(\tau)}\),
然后继续展开, 消去, 有 \(\dfrac{\pi_\theta(\tau)}{\pi_\beta(\tau)} =
\displaystyle\prod\limits_{t=0}^{T} \dfrac{\pi_\theta(\mathbf
a_t|\mathbf s_t)}{\pi_\beta(\mathbf a_t|\mathbf s_t)}\),
我们知道这个连乘用不了, 即使它是无偏的, 之前怎么处理的?假设 \(\dfrac{\pi_\theta(\mathbf a_t|\mathbf
s_t)}{\pi_\beta(\mathbf a_t|\mathbf s_t)} \approx
\displaystyle\prod\limits_{t=0}^{T} \dfrac{\pi_\theta(\mathbf
a_t|\mathbf s_t)}{\pi_\beta(\mathbf a_t|\mathbf s_t)}\),
但这里不行, 因为 \(\pi_\theta\) 和
\(\pi_\beta\) 的差距太大了,
这样一步全近似有点太糙了
我们可以把重要性权重分成过去与未来, 有 \[
\nabla_{\theta} J(\theta) \approx \frac{1}{N}
\sum_{i=1}^{N} \sum_{t=0}^{T}
\underbrace{\left(\prod_{t'=0}^{t-1}\frac{\pi_{\theta}(\mathbf{a}_{t',i}\mid\mathbf{s}_{t',i})}{\pi_{\beta}(\mathbf{a}_{t',i}\mid\mathbf{s}_{t',i})}\right)
}_{\substack{
\text{修正了到达状态 }\mathbf{s}_{t,i}\text{ 概率的差异}\\
\text{有}\mathbf{s}_t\sim d^{\pi_\beta}(\mathbf{s}_t),
\text{但要求}\mathbf{s}_t\sim d^{\pi_\theta}(\mathbf{s}_t)
}}
\nabla_{\theta}\gamma^{t}
\log\pi_{\theta}(\mathbf{a}_{t,i}\mid\mathbf{s}_{t,i})
\underbrace{\left(\prod_{t'=t}^{T}\frac{\pi_{\theta}(\mathbf{a}_{t',i}\mid\mathbf{s}_{t',i})}{\pi_{\beta}(\mathbf{a}_{t',i}\mid\mathbf{s}_{t',i})}\right)
\hat{Q}(\mathbf{s}_{t,i},\mathbf{a}_{t,i})
}_{\text{修正了错误奖励 }\hat{Q}(\mathbf{s}_{t,i},\mathbf{a}_{t,i})
\text{ 的差异}}
\] 两部分连乘有各自作用, 我们可以划掉前面的 \(\prod\limits_{t'=0}^{t-1}\dfrac{\pi_{\theta}(\mathbf{a}_{t',i}|\mathbf{s}_{t',i})}{\pi_{\beta}(\mathbf{a}_{t',i}|\mathbf{s}_{t',i})}\),
这假设 \(\pi_\theta\) 和 \(\pi_\beta\) 是接近的, 但是没办法,
状态分布偏差可能没有未来回报偏差重要
在后面的 \(\prod\limits_{t'=t}^{T}\dfrac{\pi_{\theta}(\mathbf{a}_{t',i}|\mathbf{s}_{t',i})}{\pi_{\beta}(\mathbf{a}_{t',i}|\mathbf{s}_{t',i})}
\hat{Q}(\mathbf{s}_{t,i},\mathbf{a}_{t,i})\) 上, 我们利用 reward
to go 近似为 \(\sum\limits_{t'=t}^T
\left(\prod\limits_{t''=t}^{t'}\dfrac{\pi_{\theta}(\mathbf{a}_{t'',i}|\mathbf{s}_{t'',i})}{\pi_{\beta}(\mathbf{a}_{t'',i}|\mathbf{s}_{t'',i})}\right)
\gamma^{t'-t}r_{t',i}\) 不过这坨玩意还是指数级的,
非常容易炸
一种解决方式是 Doubly Robust 估计, 用两个 estimator
来使得估计更加稳定, 我们有 \[
\begin{aligned}
V^{\pi_\theta}(\mathbf s_0)
& \approx \sum\limits_{t=0}^T
\left(\prod\limits_{t'=0}^{t}\dfrac{\pi_{\theta}(\mathbf{a}_{t'}|\mathbf{s}_{t'})}{\pi_{\beta}(\mathbf{a}_{t'}|\mathbf{s}_{t'})}\right)
\gamma^{t}r_{t} \\
&= \sum\limits_{t=0}^T \left(\prod\limits_{t'=0}^{t}
\rho_{t'} \right) \gamma^{t}r_{t} \quad (其中\;\rho_{t'} =
\dfrac{\pi_{\theta}(\mathbf{a}_{t'}|\mathbf{s}_{t'})}{\pi_{\beta}(\mathbf{a}_{t'}|\mathbf{s}_{t'})})
\\
&= \rho_0r_0 + \rho_0\gamma\rho_1r_1 + \rho_0\gamma\rho_1\gamma
\rho_2 r_2 + \dots \\
&= \rho_0(r_0 + \gamma(\rho_1(r_1 + \gamma(\rho_2(r_2 + \dots)))))
\\
&= \bar V^T \quad (有\;\bar V^{T+1-t} = \rho_t(r_t + \gamma \bar
V^{T-t}))
\end{aligned}
\] 这里的上标 \(T+1-t\) 不是幂,
而是表示从时刻 \(t\) 到终点还剩多少步,
\(\bar V^{T+1-t} \coloneqq
\sum\limits_{t'=t}^{T} \left(
\prod\limits_{t''=t}^{t'}\rho_{t''} \right)
\gamma^{t'-t}r_{t'}\)
Doubly Robust 估计的思想就是先用价值函数给出一个低方差的预测,
再用重要性采样对预测误差进行校正
假设我们先训练出来了 \(\widehat Q(\mathbf s,
\mathbf a)\), 并有了 \(\widehat
V(\mathbf s) = \mathbb E_{\mathbf a\sim\pi_\theta} \left[ \widehat
Q(\mathbf s,\mathbf a) \right]\), 对于 bandit 情况, 有估计 \(\widehat V_{\mathrm{DR}}(\mathbf s) = \widehat
V(\mathbf s) + \rho(\mathbf s,\mathbf a) \left[ r-\widehat Q(\mathbf
s,\mathbf a) \right]\), 这样的估计有双重保证, 分两种情况: 一是
\(\hat Q(\mathbf s, \mathbf a)\)
正确的情况下肯定无偏, 二是 \(\rho(\mathbf
s,\mathbf a)\) 正确的情况下偏差能够被修正
接下来我们将其扩展到 RL 上, 我们有 \(\bar V_{\mathrm{DR}}^{T+1-t} = \widehat V(\mathbf s_t) + \rho_t \left[ r_t + \gamma\bar V_{\mathrm{DR}}^{T-t} - \widehat Q(\mathbf s_t,\mathbf a_t) \right]\), 中括号里的部分可以理解为 TD 残差(Temporal Difference residual), 我们 Q-learning 干过类似的事去估计 \(A^\pi(\mathbf s, \mathbf a)\)
这个方法是 off-policy evaluation(OPE) 方法, 它不是 RL 方法, 不过估计器也是很有用的……
另一种 OPE 方法是 Marginalized importance
sampling(边缘化重要性采样),
为什么我们重要性采样的比值只能是动作概率的比值乘积?我们直接用状态或状态-动作对概率的比值,
\(w(\mathbf s,\mathbf a) =
\dfrac{d^{\pi_\theta}(\mathbf s,\mathbf a)}{d^{\pi_\beta}(\mathbf
s,\mathbf a)}\),
于是我们估计价值变成了 \(J(\theta) \approx
\dfrac{1}{N}\sum\limits_i w(\mathbf s_i, \mathbf a_i)r_i\),
所以怎么确定 \(w(\mathbf s,\mathbf
a)\)?
在 GenDICE 论文中,
有下式,
\[
d^{\pi_\beta}(\mathbf s',\mathbf a')w(\mathbf s',\mathbf
a') =(1-\gamma)p_0(\mathbf s')\pi_\theta(\mathbf a'|\mathbf
s')+
\gamma\sum_{\mathbf s,\mathbf a}\pi_\theta(\mathbf a'|\mathbf
s')p(\mathbf s'|\mathbf s,\mathbf a)d^{\pi_\beta}(\mathbf
s,\mathbf a)w(\mathbf s,\mathbf a)
\] 大致含义为: 目标策略在 \((\mathbf
s',\mathbf a')\) 的访问量 = 初始注入量 +
从其他状态动作流入的访问量 左边 \(d^{\pi_\beta}(\mathbf s',\mathbf
a')w(\mathbf s',\mathbf a')\) 实际就是 \(d^{\pi_\theta}(\mathbf s',\mathbf
a')\), 有 \(\sum\limits_{\mathbf
s,\mathbf a} d^\pi(\mathbf s,\mathbf a)=1\), 考虑折扣 \(\gamma\), 分开 \(t=0, t \ge 1\), 就是右边的两项,
右边的第二项表示从所有可能的前驱状态-动作对流入,
它本身也是一个定点迭代问题
高维连续状态下, 准确估计密度比本身很困难, 所以这个方法用于 OPE
而不是策略学习
第二种传统方法是 Linear Fitted Value Functions
现在通常不用线性拟合而是深度网络拟合了,
不过线性方法给出了许多工具以及闭式解
线性方法较不关心 distribution shift 的问题, 因为其表示能力有限(OOD 行为更可控, 不会让误差左脚踩右脚上天)
Warm up! 假设有特征矩阵 \(\Phi\) 为
\(|S| \times K\) (状态数 x
特征维度)
因为是线性模型, 我们假设存在权重向量 \(\mathbf
w_r\), 有奖励近似 \(\Phi \mathbf w_r
\approx r\), 最小二乘法下有 \(\mathbf
w_r = (\Phi^\top \Phi)^{-1}\Phi^\top \vec{\mathbf r}\)
我们还需要一个转移模型, 有 \(\Phi \mathbf
P_{\Phi} \approx \mathbf P^{\pi}\Phi\),
这里是希望拟合真实的转移矩阵 \(\mathbf
P^{\pi}\) (维度为 \(|S|\times|S|\)) 对转移的影响, 我们直接用
\(\mathbf P_\Phi\) (维度为 \(K \times K\)) 近似了, 可以用最小二乘法推出
\(\mathbf P_\Phi =
(\Phi^\top\Phi)^{-1}\Phi^\top\mathbf P^\pi \Phi\)
接下来估计价值函数 \(V^\pi\),
我们同样假定它是线性的, \(V^\pi \approx \Phi
\mathbf w_V\), 之前 Bellman equation 的思想也可以在这里使用, 有
\(V^\pi = \mathbf r + \gamma \mathbf P^\pi
V^\pi\), 即 \(V^\pi = (\mathbf I-
\gamma P^\pi)^{-1} \mathbf r\), 同理也可以推导 \(\mathbf w_V\)

总结一下, 这就是 least-squares temporal difference (LSTD, 最小二乘时间差分法), 我们得到了使用线性特征求解价值函数的 model-free 公式, 但是在 \(\mathbf w_V = (\Phi^\top\Phi - \gamma \Phi^\top \mathbf P^\pi \Phi)^{-1} \Phi^\top \vec{\mathbf r}\) 中我们还是要知道 \(\mathbf P^\pi\) 和 \(\mathbf r\), 下面探讨怎么从样本中学习这些
我们有数据 \(\mathcal D = \{ (\mathbf s_i, \mathbf a_i, r_i, \mathbf s'_i) \}\), 不知道所有状态 \(S\), 所以考虑用维度为 \(|\mathcal D| \times K\) 的 \(\Phi'\) 来代替, 那么这里的每一行就代表一个样本的特征 \(\phi(\mathbf s'_i)\), \(\mathbf P^\pi \Phi\) 就是下一时间步特征, 可以由 \(\Phi' = \phi(\mathbf s'_i)\) 代替, 同时 \(\mathbf r_i = r(\mathbf s_i, \mathbf a_i)\)
这种用样本集合替换状态集合的技巧叫做 empirical MDP(经验
MDP),
于是我们的 Offline RL 只做两步: 估计 value function 以及改进策略
有注意到什么不对劲了吗?数据 \(\mathcal
D\) 来自 \(\pi^\beta\)
怎么能估计 \(\mathbf P^\pi \Phi\)
呢?下面介绍 LSTDQ 算法
LSTD 只能用于策略评估, 本质上是在解经验版的 Bellman
方程, 而策略改进需要知道动作的好坏, 但是 \(V\) 的定义把动作平均掉了(另一种理解是 \(\mathbf s\xrightarrow{\mathbf a \sim \pi}\mathbf
s'\) 的转移把 \(\pi^\beta\)
拉进来了)
LSTDQ 估计 Q 函数, 对应的状态 \(\Phi\)
维度暴增为 \(|S||A| \times K\)
(实际应用是 \(\Phi_{\mathcal D}\in\mathbb
R^{N\times K}\)), 然后 \(\mathbf w_Q =
(\Phi^\top\Phi - \gamma \Phi^\top \Phi')^{-1} \Phi^\top \vec{\mathbf
r}\), 这里有 \(\Phi'_i =
\phi(\mathbf s'_i, \pi(\mathbf s'_i))\), 特征映射 \(\phi\) 与 \(\Phi\) 是不变的, 而 \(\pi\) 会变化带动 \(\Phi'\) 变化
这引出了最终的 LSPI(Least-squares policy iteration) 算法
- 对于 \(\pi_k\) 计算 \(\mathbf w_Q\)
- 通过 \(\pi_{k+1} = \arg \max_{\mathbf a}
\phi(\mathbf s, \mathbf a)\mathbf w_Q\) 更新策略
- 设置 \(\Phi'_i = \phi(\mathbf s'_i, \pi_{k+1}(\mathbf s'_i))\)
这里的 \(\arg \max_{\mathbf a}\) 会加剧分布偏移
Lecture 16 Offline RL 2
本 Lec 介绍现代的 Offline RL 方法, 缓解 distribution shift 的不良影响
Offline RL 需要 \(\mathcal D=\{(\mathbf s_i,
\mathbf a_i, \mathbf s'_i, r_i)\}\)
其中数据来自其他策略分布, \(\mathbf s \sim
d^{\pi_\beta}(\mathbf s), \mathbf a \sim \pi_{\beta}(\mathbf a|\mathbf
s), \mathbf s' \sim p(\mathbf s'|\mathbf s, \mathbf a), r
\leftarrow r(\mathbf s, \mathbf a)\)
目标是学习最大化折扣奖励的总和的 \(\pi_{\theta}\), 即 \[
\max_\pi \sum_{t=0}^T \mathbb E_{\mathbf s_t \sim d^\pi(\mathbf s),
\mathbf a_t \sim \pi(\mathbf a|\mathbf s)} [\gamma^t r(\mathbf s_t,
\mathbf a_t)]
\] 为了获得比 \(\pi_\beta\)
更好的 policy, Q-function 在 OOD 上对抗式拟合更高的价值, 使其不断被高估,
是 Offline RL 的主要问题

一类解决方式为策略约束方法,
我们的 policy evaluation 如常: \(Q(\mathbf s,
\mathbf a) = r(\mathbf s, \mathbf a) + \gamma \mathbb E_{\mathbf a'
\sim \pi_{new}(\mathbf a'|\mathbf s')} [Q(\mathbf s',
\mathbf a')]\)
在 policy improvement 部分加上 KL 约束: \(\pi_{new} = \arg \max_{\pi} \mathbb E_{\mathbf a
\sim \pi(\mathbf a|\mathbf s)} [Q(\mathbf s, \mathbf a)]\;\;s.t.
D_{\text{KL}}(\pi\|\pi_{\beta}) \leq \epsilon\)
它太 naive 了, 有一些问题, 首先我们不知道 \(\pi_\beta\), 需要估计它; 其次, 它表现得 "既过于悲观又不够悲观", 我们的 policy 被限制在一个小空间里(eg. 假设 \(\pi_\beta\) 是纯随机策略), 但它仍然能够在某些地方愚弄 Q-function
假设用约束方法, 我们需要什么形式的约束呢?
KL 散度约束很容易实现, 但我们不一定想要
可以考虑某种更具体的支持约束, \(\pi(\mathbf
a|\mathbf s) > 0\) 仅当 \(\pi_\beta(\mathbf a|\mathbf s) \geq
\epsilon\), 不选择没出现过的动作更加符合直觉,
但是这种方法难以实现, 需要一些近似方法, 例如 MMD
如何实现这些约束?
显式实现的方法就是把约束写成拉格朗日惩罚项融进去, 例如, 原目标为 \[
\theta \leftarrow \arg \max_{\theta} \mathbb E_{s \sim D}[\mathbb
E_{\mathbf a \sim \pi_\theta(\mathbf a|\mathbf s)}[Q(\mathbf s, \mathbf
a)]]
\] 我们改写 \(D_{\text{KL}}(\pi \|
\pi_\beta) = \mathbb E_{\pi} [\log \pi(\mathbf a|\mathbf s) - \log
\pi_\beta(\mathbf a|\mathbf s)] = -\mathbb E_\pi[\log \pi_\beta(\mathbf
a|\mathbf s)] - \mathcal H(\pi(\mathbf a|\mathbf s))\), 然后有
\[
\theta \leftarrow \arg \max_{\theta} \mathbb E_{s \sim D}[\mathbb
E_{\mathbf a \sim \pi_\theta(\mathbf a|\mathbf s)}[Q(\mathbf s, \mathbf
a)] + \lambda \log \pi_\beta(\mathbf a|\mathbf s) + \lambda \mathcal
H(\pi(\mathbf a|\mathbf s))]
\] 然后搞对偶下降或者搜超参什么的, 这里的 \(\pi_\beta\) 需要做一些行为克隆的事情来得到,
这才是最难的
另一种显式实现方法是改 reward, \(\bar
r(\mathbf s, \mathbf a) = r(\mathbf s, \mathbf a) - D(\pi,
\pi_\beta)\)
现代的 Offline RL 不采用上面的两种方法, hh
既然你都知道 \(\pi_{new} = \arg \max_{\pi}
\mathbb E_{\mathbf a \sim \pi(\mathbf a|\mathbf s)} [Q(\mathbf s,
\mathbf a)]\;\;s.t. D_{\text{KL}}(\pi\|\pi_{\beta}) \leq
\epsilon\) 了, 为什么不解这个优化问题呢?
可以解得 \(\pi^\star(\mathbf{a}|\mathbf{s}) =
\dfrac{1}{Z(\mathbf{s})} \pi_\beta(\mathbf{a}|\mathbf{s}) \exp\left(
\dfrac{1}{\lambda} A^\pi(\mathbf{s},\mathbf{a}) \right)\), 其中
\(Z(\mathbf{s})\) 是归一化常数, \(\lambda\) 可以通过求对偶问题确定,
但一般当成超参来调整, 这个式子的含义是:
最优解由行为策略乘以[优势函数的指数除以拉格朗日乘子]得出
当 \(\lambda \to 0\) 时为贪婪策略,
直接给最大化优势的动作以 1 的概率, 当 \(\lambda\) 较大时, 在 \(\pi_\beta\) 下低概率的动作仍然难以选到
实际中无法表达 \(\pi^\star\)(只有
\(\pi_\beta\) 的样本而不是 \(\pi_\beta\)), 我们希望 \(\pi_{new}\) 拟合 \(\pi^\star\), 即 \(\mathbf{\theta}_{\mathrm{new}} =
\arg\min_{\mathbf{\theta}} D_{\mathrm{KL}} \left( \pi^\star \Vert
\pi_{\mathbf{\theta}} \right)\)
去掉与 \(\mathbf{\theta}\) 无关的项,
等价于 \(\mathbf{\theta}_{\mathrm{new}} =
\arg\max_{\mathbf{\theta}} \mathbb{E}_{\mathbf{a}\sim\pi^\star} \left[
\log \pi_{\mathbf{\theta}} (\mathbf{a}|\mathbf{s})
\right]\)
然后把上面的式子当成重要性采样用, \(\dfrac{
\pi^\star(\mathbf{a}|\mathbf{s}) }{ \pi_\beta(\mathbf{a}|\mathbf{s}) } =
\dfrac{1}{Z(\mathbf{s})} \exp\left( \dfrac{ A^{\pi_{\mathrm{old}}}
(\mathbf{s},\mathbf{a}) }{\lambda} \right)\), 最终得到 \[
\mathbf{\theta}_{\mathrm{new}}=
\arg\max_{\mathbf{\theta}}
\mathbb{E}_{(\mathbf{s},\mathbf{a})\sim\mathcal D}
\left[\underbrace{
\frac{1}{Z(\mathbf{s})}
\exp\left(\frac{A^{\pi_{\mathrm{old}}}(\mathbf{s},\mathbf{a})}{\lambda}\right)
}_{w(\mathbf{s},\mathbf{a})}
\log\pi_{\mathbf{\theta}}(\mathbf{a}|\mathbf{s})
\right]
\] 这是一个加权最大似然, \(w(\mathbf{s},\mathbf{a})\) 就是权重,
更多模仿权重更高的动作, 具体推导可见 这份笔记
最终我们得到 AWAC(Advantage-Weighted Actor-Critic) 算法

\(\mathcal L_C(\phi)\)
负责评价动作, \(\mathcal
L_A(\theta)\) 根据评价结果有选择地模仿动作
\(\mathcal L_C(\phi)\) 是标准的
actor-critic 做法, 只是 \(\mathcal
L_A(\theta)\) weighted 罢了
注意一下, 我们只保证了 \(\pi^\star\)
满足 KL 约束, \(\pi_\theta\) 不一定满足
KL 约束, 在 AWAC 中, 为了估计 advantage, 还是需要查询 OOD 动作,
我们只是希望对于适当的 \(\lambda\)
在训练后会遵守约束
这里的想法是将 \(\mathbb E_{\mathbf a'
\sim \pi_{new}}[Q(\mathbf s', \mathbf a')]\) 使用神经网络
\(V(\mathbf s')\) 表示,
以下面形式来训练这个网络, 所有数据都在 \(\mathcal D\) 上 \[
V \leftarrow \arg \min_V \frac{1}{N} \sum_{i=1}^N \mathcal L(V(\mathbf
s_i) ,Q(\mathbf s_i, \mathbf a_i))
\] 我们将相似的 state 看作一个, 这样就有充足的 action 这里如果用
MSE Loss 在 \(\mathcal D\)
上训练肯定是错的, 因为那样最终 \(V(\mathbf s)
\approx \mathbb E_{\mathbf a\sim\pi_\beta} Q(\mathbf s,\mathbf
a)\), 没有改进
有一个直觉, 因为 \(V\) 能够泛化,
那么多个相似的 \((\mathbf s_i,\mathbf
a_i)\) 会共同影响 \(V(\mathbf
s)\), 为什么要用 MSE Mean 呢?我们可以挑一个
expectile(期望分位数),
一个较高的分位数来表示最优秀那部分的表现, 我们使用非对称 Loss
来引导上分位数(see Lec 8 TQC), 有 \(\mathcal L
= l_2^\tau(x)= \begin{cases} (1-\tau)x^2 & \text{if } x>0 \\ \tau
x^2 & \text{else } \end{cases}\), 其中 \(x=V-Q\), 这里取 \(\tau > 0.5\) 就会鼓励高估拟合上分位数,
给 V<Q 的部分大量惩罚, 一般来讲 \(\tau =
0.9\)
另一方面理解, 因为我们在 \(\mathcal
D\) 上学习, MSE Loss 其实是一种低估, 因为我们没有使用训练到的
\(\pi_{new}\) 上的动作
我们还可以说, 这种方法鼓励 \(V\)
训练成为 \(\pi_\beta\)
支撑的所有动作中 Q 函数的最大值, 我们在每个局部
state 学习哪个更好, 从而拼接得到最好的 policy
以上就是 IQL 算法, 用 expectile loss 更新 \(V\), 用 \(V\) one-step 更新 \(Q\), 然后用 Weighted 更新 \(A\), 推荐 知乎笔记
下面介绍 CQL 算法,
它的直观想法不是仅在 \(\mathcal D\)
上训练做策略约束, 而是学习一个 Conservative(保守的) Q
函数, 可以证明在得当 \(\alpha\)
的选择下, 它是真实 Q 函数的一个下界 \[
\mathcal L_{\mathrm{CQL}}(Q)=\underbrace{\mathcal
L_{\mathrm{TD}}(Q)}_{\text{拟合 Bellman 方程}}
+ \underbrace{\alpha\log\sum_{\mathbf a}\exp Q(\mathbf s,\mathbf a)
}_{\text{压低所有可能的高 Q 动作}}
- \alpha\underbrace{\mathbb E_{\mathbf a\sim\mathcal D}Q(\mathbf
s,\mathbf a)
}_{\text{提高数据动作的 Q}}
\] 或者说 \[
\hat Q^\pi = \arg \min_Q \max_\mu \alpha \mathbb E_{\mathbf s\sim
\mathcal D, \mathbf a \sim \mu(\mathbf a|\mathbf s)}[Q(\mathbf s,
\mathbf a)] - \alpha \mathbb E_{(\mathbf s, \mathbf a) \sim \mathcal
D}[Q(\mathbf s, \mathbf a)] \\
+ \mathbb E_{(\mathbf s, \mathbf a, \mathbf s') \sim \mathcal D}
\left[ (Q(\mathbf s, \mathbf a) - r(\mathbf s, \mathbf a) + \mathbb
E_{\pi}[Q(\mathbf s', \mathbf a')])^2 \right]
\] 
一边压低, 一边撑高; 如果所有大 Q 值对应于数据的动作, 两项应该会平衡;
如果大 Q 值不在数据上, 则会被压低, 而数据 Q 值则会被抬起来
我们可以保证, \(\forall \mathbf s \in \mathcal
D, \;\mathbb E_{\pi(\mathbf a|\mathbf s)}[\hat Q^\pi(\mathbf s, \mathbf
a)] \leq E_{\pi(\mathbf a|\mathbf s)}[Q^\pi(\mathbf s, \mathbf
a)]\)
CQL 的第一步就是更新 \(\hat Q^\pi\),
第二步就是更新 \(\pi\) (离散求最大值,
连续更新 \(\pi_\theta\))
在实际中 \(\hat Q^\pi\) 的式子还要减掉
\(\mathcal R(\mu)\) 的正则项才能与 Loss
的 log-sum-exp 对应(而不是硬 max), 一般 \(\mathcal R(\mu) = \mathcal H(\mu)\),
这样同时压低多个高 \(Q\) 动作, Loss
项里面都不用 \(\mu\) 项了, 哇哦
在连续分布上, sum-exp 求不出来, 需要做重要性采样, 因为是 one-step 的, 方差还是很稳定的
另一个方向是 Model-based Offline RL, Model-based 其实非常适合 Offline RL, 因为有了 model 就可以做反事实推测了, 用 model 回答 what-if 问题
不过还是会 OOD 啊, 首先还有老一套方法, 上惩罚!例如 MOPO
我们做 \(\tilde r(\mathbf s, \mathbf a) =
r(\mathbf s, \mathbf a) - \lambda u(\mathbf s, \mathbf a)\),
这里的 \(u\) 是一个不确定性惩罚,
我们需要之前的不确定性技术来处理 \(u\),
例如训练 model ensembles
先跳过 \(u\) 的寻找,
假设我们能够找到至少与模型的真实误差一样大的 \(u\), 并且 \(V\) 能够表示真实的 \(V\), MOPO 证明了 \[
\eta_M(\hat\pi)\geq\sup_\pi\left\{\eta_M(\pi)-2\lambda\epsilon_u(\pi)\right\}
\] 这代表如果用 Model 训练一个策略 \(\hat \pi\),
其真实回报将至少与我们可以找到的最佳策略减去它的某种误差一样大
另一个结论是 \[
\eta_M(\hat\pi)\geq\eta_M(\pi^\delta)-2\lambda\delta
\] 用 Model 训练一个策略 \(\hat
\pi\), 其真实回报与以 \(\delta\)
误差界定的最佳策略相差无几
带入 \(\pi_\beta\), 因为 \(\epsilon_u(\pi_\beta) \approx 0\), 我们知道
\(\eta_M(\hat\pi)\gtrsim
\eta_M(\pi_\beta)\), 这也是某种改进保证吧
带入 \(\pi^\star\), 可以得到 MOPO
策略距离真正最优策略有多远,
取决于模型在最优策略所访问区域上的误差
更进一步的, COMBO 从
MOPO 和 CQL 上改进, CQL 中我们最小化 policy 产生的 actions 的 Q-values,
而 COMBO 最小化 model 产生的 state-action 对的 Q-values \[
\widehat{Q}^{k+1}\leftarrow\arg\min_{Q}\;\beta
\left(\mathbb{E}_{\mathbf{s},\mathbf{a}
\sim \rho(\mathbf{s},\mathbf{a})}
\left[Q(\mathbf{s},\mathbf{a})\right] -
\mathbb{E}_{\mathbf{s},\mathbf{a}\sim\mathcal{D}}
\left[Q(\mathbf{s},\mathbf{a})\right]
\right) \\
+
\frac{1}{2}\mathbb{E}_{(\mathbf{s},\mathbf{a},\mathbf{s}')\sim d_f}
\left[\left(
Q(\mathbf{s},\mathbf{a}) -
\left(r(\mathbf{s},\mathbf{a}) +
\gamma\mathbb{E}_{\mathbf{a}'\sim
\pi(\mathbf{a}'\mid\mathbf{s}')}
\left[\widehat{Q}^{k}(\mathbf{s}',\mathbf{a}')
\right]\right)\right)^2\right]
\] 这里的直觉是: 如果模型生成的结果与真实数据明显不同, 那么 Q
函数很容易使模型看起来很糟糕
上面的 \(\rho(\mathbf s, \mathbf a)\)
是在学习到的模型 \(\hat{\mathcal M}\)
中执行当前策略 \(\pi\) 得到的 s-a 分布,
\(d_f\)
是一种真实数据与模型数据的混合分布, 要不还是去看 知乎笔记 吧
Trajectory Transformer 是一种 Model-based, non-Dyna style, Offline RL 方法, 而且我猜它用了 Transformer
如果你看不懂(我也看不懂), 可以背一些关键词, 例如 beam-search-based planning, autoaggressive 训练目标, 训练预测 \(s_i-a_i-r\); 也许这些词语能给你一些这个算法的直觉
我们训练一个能够预测 s-a 序列的模型, 一个 trajectory model, \(p_\beta(\tau) = p_\beta (\mathbf s_1, \mathbf a_1,
\dots, \mathbf s_T, \mathbf a_T)\),
这个模型在数据集的轨迹上进行密度估计从而提供 s-a 序列的概率,
在实际使用中, 轨迹拆得更细一点, 把 \(\mathbf
s_t, \mathbf a_t\) 都拆成了 \(s_t^1,
s_t^2, \dots\) 这样的单维度
我们使用一个表达能力强大的模型 —— Transformer

我们训练的目标是尽可能拟合离线数据,
而选择高回报行为主要发生在推理阶段的搜索过程中
当训练完成后, 环境给出当前状态 \(\mathbf
s_t\), TT 首先把它离散成 token, 连同最近的一段历史一起输入模型,
然后生成许多的 s-a trajectories, 使用 beam search
而不是贪心从而保留多条轨迹, 然后打分选择(这里的打分就比较独立了,
大概是展开几步后接一个 reward-to-go, 还可以接一个不确定性惩罚),
打分结束后只走一步然后全部重来(哈哈, 写了 Assignment 4
就知道这玩意有多慢了)
高概率的轨迹避免了 OOD, 是这个方法成功的原因,
同时大模型!大就是好啊!


Offline RL 让人眼花缭乱, 下面还有一堆补充, 我还比较好奇 Offline to
Online 呢
这么多选择, 用哪个算法呢?有一些经验建议
- CQL: 仅一个超参数, 被广泛验证
- IQL: 更灵活(Offline + Online), 更多超参
- AWAC: 适合 Offline + Online finetune, 但似乎不如 IQL
- COMBO: 适合有 Good model 的情况
- Trajectory Transformer: 强大模型, 计算成本高, Horizon 有限制(没学 policy 啊)
Offline RL 是十分强大的, 现实世界进行 Online RL 需要很多相关准备, 然后不可避免要丢弃之前收集的数据, 而 Offline RL 的数据集可以使用人类提供的数据, controller 的数据, baseline policy 的数据或是以上的混合, 数据数据数据, 只要数据足够多, 那么我就足够强(Disclaim: 临时个人观点, 南大的俞扬教授就很反对, 认为利用数据喂出来是某种捷径)
有一些 gap 仍然存在, 例如 Offline RL 的评估仍然是 Online 的, 这可能是危险的; 还有一些统计学保证的问题, 以及如何 scale Offline RL 的问题
Diffusion RL 补充
首先, 什么是 Diffusion Model 来着?前面有讲过 flow matching,
这俩是同一个东西吗?都是加噪去噪?
这里有一篇教程: 零推导理解 Diffusion 和
Flow Matching - 知乎, 它们的区别是, 额, 圆弧和直线插值的区别?
给定真实数据 \(x_0\), diffusion
前向过程通过 \(T\)
次累计对其添加高斯噪声, 得到 \(x_1, x_2,
\dots, x_T\), 即以下 \(q\) 过程
\[
q(x_t|x_{t-1}) = \mathcal N(x_t;\sqrt{1-\beta_t} x_{t-1}, \beta_t
\mathbf I), \\
q(x_{1:T}|x_0) = \prod_{t=1}^T q(x_t|x_{t-1})
\] 随着 \(t\) 的增大, \(x_t\) 越来越接近纯噪声
如果我们能够逐步得到逆转后的分布 \(q(x_{t-1}|x_t)\),
就可以从完全的标准高斯分布 \(x_T \sim \mathcal
N(0,\mathbf I)\) 还原出原分布 \(x_0\), 我们用参数为 \(\theta\) 的深度模型去预测逆向的 \(p_\theta(x_{t-1}|x_t)\)
训练时, 我们已经拥有真实数据 \(x_0\), 因此可以随机选择一个扩散步 \(t\), 向 \(x_0\) 加入已知的高斯噪声, 得到 \(x_t\), 再要求模型预测刚才加入的噪声, 有
Loss \[
\mathcal L_{\mathrm{diff}}
=
\mathbb E\left[
\|\epsilon-\epsilon_\theta(x_t,t)\|^2
\right].
\] \(\epsilon\)
是实际加入的噪声, \(\epsilon_\theta\)
是模型预测的噪声
训练完成后, 可以从纯噪声 \(x_T\)
开始反复调用模型 \(x_T\rightarrow
x_{T-1}\rightarrow\cdots\rightarrow x_0\),
最终生成一个与训练数据具有相似分布的新样本
Diffusion Model 还可以接收条件 \(c\), 记作 \(p_\theta(x_{t-1}|x_t,c)\), 条件的作用是告诉模型希望生成什么, 在强化学习中, 可以令 \(x_0=\mathbf a\), 条件为 \(c=\mathbf s\) 以生成当前状态下的动作, \(c\) 还可以包含目标、期望回报或任务约束
将 Diffusion Model 用于 RL, 最直接的做法就是把它视为一个条件策略
\(\pi_\theta(\mathbf a|\mathbf
s)\)
相比常见的单峰高斯策略, Diffusion Policy 能表示多峰动作分布
Diffusion Q-Learning 的做法基本就是把生成动作的生成器换用 diffusion model, critic 仍然使用 Double Q-learning 方式
Diffusion Policy 定义为 \(\pi_\theta(\mathbf a|\mathbf s) = p_\theta(\mathbf
a^{0:N}|\mathbf s) = \mathcal N(\mathbf a^N;0,\mathbf I) \prod_{i=1}^N
p_\theta(\mathbf a^{i-1}|\mathbf a^i, \mathbf s)\)
对于数据集的动作 \(\mathbf a\),
让网络预测噪声, 这部分 Loss 和上文类似, \(L_d(\theta) = \mathbb E\left[ \left\| \epsilon-
\epsilon_\theta(a^i,\mathbf s,i) \right\|^2 \right]\)
然后为了超越行为克隆, 加入 \(L_q(\theta) =
-\alpha\, \mathbb E_{\mathbf s\sim\mathcal D,\, \mathbf
a^0\sim\pi_\theta} [Q_\phi(\mathbf s,\mathbf a^0)]\) 鼓励高 Q 值,
最终 actor 目标为两者之和
总的流程为:
用目标 diffusion policy 在 \(\mathbf
s'\) 下完整去噪, 生成 \(\mathbf
a'\)
使用 \(r+\gamma\min Q'(\mathbf
s',\mathbf a')\) 更新两个 critic
对数据动作 \(\mathbf a\) 加噪, 计算
diffusion 去噪损失 \(L_d\)
当前 diffusion policy 给定 \(\mathbf
s\) 从噪声生成动作 \(\mathbf
a^0\) 并计算 \(-\alpha Q(\mathbf
s,\mathbf a^0)\)
用 \(L_d-\alpha Q(\mathbf s,\mathbf
a^0)\) 联合更新 diffusion policy, 然后软更新目标网络
为什么这样能行?diffusion behavior cloning 缓解了分布偏移, Double
Q-learning 缓解了 Q 值虚高, diffusion 更能表示多峰行为策略
为什么这样还不够?diffusion loss 只是软约束, 仍可能 OOD;
优化策略来最大化 Q function 的时候, 不但需要通过 Diffusion 采样完整的
action, 还要带梯度计算以完成梯度下降,
对于更大的模型设计可能训练过程会相当痛苦
看实验测试一片 SOTA, 吓哭了

IDQL 是 IQL 和上面的 DQL(指 Diffusion Q-Learning 而不是 Double Q-Learning) 生下的产物
IQL 的伟大贡献是 expectile loss 来鼓励学习最优的 Q,
IDQL 在这里继续 generalize, 证明了 loss 可以换成任意一个凸函数 \(f\), \(f\)
实际上控制了我们学习的隐式策略 \(\pi_{\text{imp}}(\mathbf a|\mathbf s)\),
而这个隐式策略是和行为策略 \(\pi_\beta\) 密切相关的(!!!)
我们定义梯度 \(f' = \dfrac{\part
f}{\part V(\mathbf s)}\), 学习的 critic 为 \(V^*(\mathbf s) = \arg \min_{V(\mathbf s)} \mathcal
L_V^f(V(\mathbf s))\), 当 \(f =
l_2^\tau\) 时退化为 IQL
可以定义重要性权重 \(w(\mathbf s, \mathbf a) =
\dfrac{|f'(Q(\mathbf s, \mathbf a)-V^*(\mathbf s))|}{Q(\mathbf s,
\mathbf a)-V^*(\mathbf s)}\), 有 \(\pi_{\text{imp}}(\mathbf a|\mathbf s) \propto
\pi_\beta(\mathbf a|\mathbf s) w(\mathbf s, \mathbf a)\)
这里的 \(w(\mathbf s, \mathbf a)\)
的选择还能退化到其他文章, 例如 SfBC
原始的 IQL 最后一步不是用类似 AWAC/AWR
方法来做加权最大似然吗?理论部分证明了这样做不够准确, 因为 \(\pi_{\text{imp}}\) 与 \(\pi_\beta\) 强相关, 而后者可能是多峰的, 而
\(\pi_\theta\) 通常用单峰高斯,
神经网络输入状态 \(\mathbf s\),
输出每个动作维度的均值和标准差
这启发我们引入 diffusion 训练拟合行为策略 \(\pi_\theta \approx \pi_\beta\), 在
test-time 不做 AWAC/AWR 了, 而是直接从 \(\pi_\theta(\mathbf a|\mathbf s)\) 采样
\(\{\mathbf a_1, \dots, \mathbf
a_K\}\), 然后选择 \(\arg \max_{\mathbf
a_k} \hat Q_{\phi}(\mathbf s, \mathbf a_k)\) 动作, 总流程如下

测评一下, IDQL 又成为新 SOTA 了, 这里的 IDQL-1 说明每个域只能调整一个超参数的情况, 不用调参总是好的

我在此留下一个开放式问题, 为什么不直接让 diffusion 拟合最终的 advantage-weighted 策略, 而是将最优策略解耦成 behavior policy 和 weight 的相乘, 分别训练 behavior policy 和 (下游任务的 \(Q,V\) 和 critic loss 决定的) weight?
Lecture 17 RL Theory
本 lecture 内容只是 Reinforcement Learning: Theory and Algorithms 的简单介绍
你的意思是说我们框框学了 16(15) 个 Lecture 现在才学习 RL
理论吗?
哈哈, 反正 RL 是 trade-off 叠 assumption 叠 engineering 的东西, 其实没有
theory 也可以?
我们可以学习一部分的理论, 例如, \(N\) 样本, \(k\) 次迭代下的 RL 的结果最好是多好?
有点抽象, 对于具体的 Q-learning, 这相当于问类似 \(\| \hat Q_k - Q^{\star} \| \leq \epsilon\)
在 \(1-\delta\)
的概率下类似的东西
例如我们希望只要样本数量足够, 有类似 \(N \geq
f(\epsilon, \delta)\) 这样的式子, 其中 \(f\) 是一个我们希望的好函数, 我们不希望
\(N\) 随着 \(\epsilon, \delta\)
的下降而指数上升或类似的
或者我们问 \(\| Q^{\pi_k} - Q^{\star} \| \leq \epsilon\), 注意 \(\hat Q_k\) 是构想的 Q 函数(可能高估), \(Q^{\pi_k}\) 是与真实环境交互出来得到的真正价值
我们还可以问的理论问题是,
不同的探索(exploration)方法会带来多大的遗憾(regret)上界?
提一嘴探索问题吧, 最坏情况的探索及其悲观,
好的探索一般代表它能学到一个好的策略,
这个策略偏离最优策略的程度在多项式时间内由状态数, 动作数与 \(1/(1-\gamma)\) 的 horizon 决定, 即 \(\text{Poly}(|S|, |A|, 1/(1-\gamma))\)
本 lecture 主要关注样本复杂性的问题, 我们一般假装探索效率良好,
可以闭着眼睛摇晃身体假装探索前进
先引入一些假设, 使得理论不太脱离于实际也不那么困难去推导
对于 Learning 部分的理论, 我们有 generative model 假设, 假设我们能在 MDP
中采样任意 \((\mathbf s, \mathbf a)\)
对
或者引入神谕!oracle exploration 说我们能够对于每对 \((\mathbf s, \mathbf a)\) 采样 \(\mathbf s' \sim P(\mathbf s'|\mathbf s,
\mathbf a)\) N 次
我们想证明 RL 总是 "良好工作"(尽管……fitted Q-iteration
已经证明了不收敛……)
我们想知道 error 是如何受问题参数影响的(大折扣系数更好还是小的更好?减半
error 需要多少倍的样本?)
Levine 在这里坦诚相待, 我们从未有过一个理论上证明的好强化学习算法,
理论的作用是通过分析极大简化的特殊情况来获得定性和某些启发性的结论,
假设总是不切实际, 而理论只是粗略指南
正式开始一些推导, 例如, 对于 oracle exploration, 我们最简单的
model-based RL 为 \(\hat P(\mathbf
s'|\mathbf s, \mathbf a)= \dfrac{\#(\mathbf s,\mathbf a, \mathbf
s')}{N}\), 然后对于 policy \(\pi\), 使用 \(\hat P\) 估计 \(\hat Q^\pi\), 最后用无穷范数比较 \(Q^\pi, \hat Q^\pi, Q^\star, \hat Q^\star\)
看看到底多好
我们要从监督学习中寻找一些工具, 例如霍夫丁不等式(Hoeffding's
inequality)
如果我们希望失败概率 \(\delta \ge
\Pr(\vert{}\text{error}\vert{} > \epsilon)\), 经过一些化简, 有
\(N \le \dfrac{(b - a)^2}{2\epsilon^2} \log
\dfrac{2}{\delta}\)
所以这里重要的结论是 \(\epsilon \propto
1/\sqrt{n}\)
上面的 Hoeffding's inequality 是拿来估计连续随机变量的,
那么对于离散随机变量呢?
L1 误差与 TV 散度相关, 我们很喜欢啊
令失败概率 \(\delta =
e^{-N\epsilon^2}\), 可以解得 \(\epsilon
= \dfrac{1}{\sqrt{N}} \sqrt{\ln\dfrac{1}{\delta}}\), 又是 \(\epsilon \propto 1/\sqrt{n}\) 哦哈哈
我们还可以得到 \(\Vert{}\hat{P}(\cdot\vert{}s,
a) - P(\cdot\vert{}s, a)\Vert{}_1 \le \sqrt{\vert{}S\vert{}} \left(
\dfrac{1}{\sqrt{N}} + \sqrt{\dfrac{\ln(1/\delta)}{N}} \right) \le
c\sqrt{\dfrac{\vert{}S\vert{}\log 1/\delta}{N}}\) 这样的东西
接下来我们将 \(P\) 与 \(Q^\pi\) 联系起来
我们有 \(Q^\pi(\mathbf s, \mathbf a) =
r(\mathbf s, \mathbf a) +\gamma\sum\limits_{\mathbf s'} P(\mathbf
s'|\mathbf s, \mathbf a) V^\pi(\mathbf s')\),
或写成向量式 \(Q^\pi = r+\gamma
PV^\pi\)

这里的 \(\Pi\) 是策略矩阵, \(V^\pi = \Pi Q^\pi\),
在数学上等价于根据策略对动作求期望, 得到了状态价值函数 \(V^\pi\)
注意是 \(|S||A|\)
的一维向量而不是二维向量, \(P^\pi\) 是
\((\mathbf s, \mathbf a)\) 到 \((\mathbf s, \mathbf a)\) 的二维矩阵, 而
\(P\) 是环境转移矩阵
\(P\) 的作用是从 \((\mathbf s, \mathbf a)\) 到下一个 \(\mathbf s'\), \(\Pi\) 的作用是从 \(\mathbf s'\) 决定下一个 \(\mathbf a'\), 合起来就是 \(P^\pi\)
因为 \(Q^\pi = r + \gamma P^\pi
Q^\pi\), 于是有 \(Q^\pi = (I - \gamma
P^\pi)^{-1}r\), 这个式子帮助我们把 \(P\) 与 \(Q^\pi\) 联系起来
我们有两个 Lemma, 第一个是 \(Q^\pi - \hat
Q^\pi = \gamma(I-\gamma\hat P^\pi)^{-1} (P-\hat P)V^\pi\), 这里的
\(P-\hat P\) 是概率差距
另一个 Lemma 为: 给定 \(P^\pi\) 与 \(v \in \mathbb R^{|S||A|}\) 中的任意向量, 有 \[ \| (I-\gamma P^\pi)^{-1}v \|_{\infty} \leq \| v \|_{\infty}/(1-\gamma) \] 这代表以 \(v\) 为奖励对应的 Q 函数, 其最大值不超过原来的 \(1/(1-\gamma)\) 倍, 还挺直观, 假设单步奖励 \(v\) 在任何状态下的绝对值最大都不超过一个常数 \(c\), 累积回报的最大可能值就是等比求和 \(\sum\limits_{t=0}^{\infty} \gamma^t c = \dfrac{c}{1-\gamma} = \dfrac{\| v \|_{\infty}}{(1-\gamma)}\)
现在把两个 Lemma 结合起来, 有 \[
\begin{aligned}
\Vert{} Q^\pi - \hat Q^\pi \Vert{}_{\infty} &= \Vert{}
\gamma(I-\gamma\hat P^\pi)^{-1} (P-\hat P)V^\pi \Vert{}_{\infty} \\
&\leq \frac{\gamma}{1-\gamma} \Vert{} (P-\hat P)V^\pi
\Vert{}_{\infty} \quad (相当于v = (P-\hat P)V^\pi) \\
&\leq \frac{\gamma}{1-\gamma} \left( \max_{\mathbf s,\mathbf a}
\Vert{}P(\cdot\vert{}\mathbf s,\mathbf a) - \hat P(\cdot\vert{}\mathbf
s,\mathbf a)\Vert{}_1 \right) \Vert{}V^\pi\Vert{}_{\infty} \quad
(范数性质, 单独做\;P - \hat P)\\
&\leq \frac{\gamma}{(1-\gamma)^2} \left( \max_{\mathbf s,\mathbf a}
\Vert{}P(\cdot\vert{}\mathbf s,\mathbf a) - \hat P(\cdot\vert{}\mathbf
s,\mathbf a)\Vert{}_1 \right) \quad (用\;\frac{1}{1-\gamma}放掉
\Vert{}V^\pi\Vert{}_{\infty}, r_\max=1) \\
&\leq \frac{\gamma}{(1-\gamma)^2} c_2 \sqrt{\frac{\vert{}S\vert{}
\log 1/\delta}{N}}
\end{aligned}
\] 额, \(\Vert{} Q^\pi - \hat Q^\pi
\Vert{}_{\infty} \leq \epsilon = \dfrac{\gamma}{(1-\gamma)^2} c_2
\sqrt{\dfrac{\vert{}S\vert{} \log 1/\delta}{N}}\),
啥意思?有什么用?
一是更多样本更好, 二是误差随时间范围二次增长 (\(\dfrac{\gamma}{(1-\gamma)^2}\)),
三是误差与状态空间大小 \(\sqrt{\vert{}S\vert{}}\) 成正比
其他类似问题呢?有 \[
\| Q^\star - \hat Q^\star\|_\infty = \| \sup_\pi Q^\pi - \sup_\pi
\hat Q^\pi \|_\infty \leq \sup_\pi \| Q^\pi -\hat Q^\pi \|_\infty \leq
\epsilon \\
\| Q^\star - Q^{\hat \pi^\star}\|_\infty = \| Q^\star -\hat Q^{\hat
\pi^\star}+ \hat Q^{\hat \pi^\star}- Q^{\hat \pi^\star}\|_\infty \leq \|
Q^\star -\hat Q^{\hat \pi^\star} \|_\infty + \| \hat Q^{\hat \pi^\star}-
Q^{\hat \pi^\star}\|_\infty \leq 2\epsilon
\] 第一行是在模型的最优 Q-function 与现实的最优 Q-function
的差距
第二行是模型的最优策略 \(\hat{\pi}^\star\) 到现实后与现实的最优
Q-function 的差距, 后面的 \(\hat{Q}^{\hat{\pi}^\star}\) 其实就是 \(\hat{Q}^\star\)
这告诉我们, 即使只能在一个充满误差的模拟器里训练 Agent, 只要能控制住
\(\epsilon\), 真实世界最多只有 \(2\epsilon\) 误差
上面的部分属于 model-based RL, 那么 model-free RL 的理论主要关心什么问题呢?
曾几何时, 我们有 fitted Q-iteration, 被打入了不收敛的冷宫
现在, 我们重新捞出来看看能不能有点理论的油水
Q-iteration 的核心是 \(Q_\phi(\mathbf{s},
\mathbf{a}) = r(\mathbf{s}, \mathbf{a}) + \gamma \max_{\mathbf{a}'}
Q_\phi(\mathbf{s}', \mathbf{a}')\), 我们不想看这坨,
把它用 Bellman 算子处理了, 我们剩下类似 \(Q_{k+1} \leftarrow TQ_k\) 这样的东西
不过现实世界不是这样的, 我们的算子是样本估计的, 同时我们的 Q
函数是神经网络, 于是为
\[
\hat{Q}_{k+1} \leftarrow \arg\min_{\hat{Q}} \Vert{}\hat{Q} -
\hat{T}\hat{Q}_k\Vert{}
\] 我们用的是近似 Bellman 算子, \(\hat
TQ = \hat r + \gamma \hat P \max\limits_{\mathbf a} Q\), 在这里
\(\hat r, \hat P\) 只是观测到的平均值,
不是模型, 采样误差不可避免, 真是悲剧啊 (;´д`)ゞ
因为 \(L_2\) 范数不收敛甚至发散, 上面的
\(\Vert{}\hat{Q} -
\hat{T}\hat{Q}_k\Vert{}\) 在 \(L_\infty\) 范数下分析
我们想要得到 \(\lim\limits_{k \to \infty} \|
\hat Q_k - Q^\star \|_\infty\) 的上界, 这里的误差来源于 \(T \neq \hat T\)
的采样误差与 \(\hat{Q}_{k+1}
\neq \hat{T}\hat{Q}_k\) 的近似误差
先分析采样误差, 全部领域展开! \[
\begin{aligned}
\vert{}\hat{T}Q(\mathbf s, \mathbf a) - TQ(\mathbf s, \mathbf a)\vert{}
&= \vert{} \underbrace{\hat{r}(\mathbf s, \mathbf a) - r(\mathbf s,
\mathbf a)}_{\text{奖励的采样误差}} + \gamma \underbrace{\left(
\mathbb{E}_{\hat{P}}[\max_{\mathbf a'} Q(\mathbf s', \mathbf
a')] - \mathbb{E}_{P}[\max_{\mathbf a'} Q(\mathbf s',
\mathbf a')] \right)}_{\text{状态转移的采样误差}} \vert{} \\
&\le \vert{}\hat{r}(\mathbf s, \mathbf a) - r(\mathbf s, \mathbf
a)\vert{} + \gamma \vert{}\mathbb{E}_{\hat{P}}[\max_{\mathbf a'}
Q(\mathbf s', \mathbf a')] - \mathbb{E}_{P}[\max_{\mathbf
a'} Q(\mathbf s', \mathbf a')]\vert{}
\end{aligned}
\] 然后我们就可以用处理了, 对于奖励的采样误差, 用 Hoeffding's
inequality 控制
对于状态转移的采样误差, 把期望变求和, 放大, 用上面的式子控制 L1 距离, 有
\[
\begin{aligned}
\vert{}\hat{T}Q(\mathbf s, \mathbf a) - TQ(\mathbf s, \mathbf a)\vert{}
&\leq 2R_{\max}\sqrt{\frac{\log (1/\delta)}{2N}} + \sum_{\mathbf
s'} (\hat{P}(\mathbf s'\vert{}\mathbf s, \mathbf a) - P(\mathbf
s'\vert{}\mathbf s, \mathbf a)) \max_{\mathbf a'} Q(\mathbf
s', \mathbf a') \\
&\leq 2R_{\max}\sqrt{\frac{\log (1/\delta)}{2N}} + \sum_{\mathbf
s'} (\hat{P}(\mathbf s'\vert{}\mathbf s, \mathbf a) - P(\mathbf
s'\vert{}\mathbf s, \mathbf a)) \max_{\mathbf s', \mathbf
a'} Q(\mathbf s', \mathbf a') \\
&= 2R_{\max}\sqrt{\frac{\log (1/\delta)}{2N}} +\|
\hat{P}(\cdot\vert{}\mathbf s, \mathbf a) - P(\cdot\vert{}\mathbf s,
\mathbf a)) \|_1 \;\| Q \|_\infty \\
&\leq 2R_{\max}\sqrt{\frac{\log (1/\delta)}{2N}} + c \| Q\|_\infty
\sqrt{\frac{\log 1/ \delta}{N}}
\end{aligned}
\] 如果扩展到所有的 \((\mathbf s,
\mathbf a)\) 对上, 扩展到我们希望的 \(L_\infty\) 范数上, 有 \[
\| \hat TQ- TQ \|_\infty \leq 2R_{\max}c_1\sqrt{\frac{\log
(|S||A|/\delta)}{2N}} + c_2 \| Q\|_\infty \sqrt{\frac{\log |S|/
\delta}{N}}
\] 这里的 \(\| Q\|_\infty\) 是
\(\mathcal O(R_\max
\dfrac{1}{1-\gamma})\) 级别的, 额, 这个在 Lecture 9 提过一点,
我们还是不证明了
接下来分析近似误差, 找出当前估计的 Q 函数 \(\hat{Q}_k\) 与真正的最优 Q 函数 \(Q^\star\) 之间的距离
这里有假设 \(\| \hat{Q}_{k+1} - T\hat{Q}_k
\|_\infty \leq \epsilon_k\), 先假装 \(T
= \hat T\), 同时强假设近似误差在 \(L_\infty\) 上有界 \(\epsilon_k\), 有 \[
\begin{aligned}
\vert{}\vert{}\hat{Q}_k - Q^{\star}\vert{}\vert{}_\infty
&= \vert{}\vert{}\hat{Q}_k - T\hat{Q}_{k-1} + T\hat{Q}_{k-1} -
Q^{\star}\vert{}\vert{}_\infty \\
&= \vert{}\vert{}(\hat{Q}_k - T\hat{Q}_{k-1}) + (T\hat{Q}_{k-1} -
TQ^\star)\vert{}\vert{}_\infty \quad (最优不动点\;TQ^\star = Q^\star)\\
&\le \vert{}\vert{}\hat{Q}_k - T\hat{Q}_{k-1}\vert{}\vert{}_\infty +
\vert{}\vert{}T\hat{Q}_{k-1} - TQ^\star\vert{}\vert{}_\infty \\
&\le \epsilon_{k-1} + \vert{}\vert{}T\hat{Q}_{k-1} -
TQ^\star\vert{}\vert{}_\infty \\
&\le \epsilon_{k-1} + \gamma\vert{}\vert{}\hat{Q}_{k-1} -
Q^{\star}\vert{}\vert{}_\infty \quad (算子收缩性 \;\gamma) \\
&\le \epsilon_{k-1} + \gamma \epsilon_{k-2} + \gamma^2
\epsilon_{k-3} + \dots + \gamma^k \vert{}\vert{}\hat{Q}_0 -
Q^{\star}\vert{}\vert{}_\infty \quad (展开递归) \\
&\le \sum_{i=0}^{k-1} \gamma^i \epsilon_{k-i-1} + \gamma^k
\vert{}\vert{}\hat{Q}_0 - Q^{\star}\vert{}\vert{}_\infty
\end{aligned}
\] 最后一个式子告诉我们, 随着 \(k \to
\infty\), 人是会忘本的, 于是有 \[
\lim_{k \to \infty} \| \hat Q_k - Q^{\star} \|_\infty \leq
\sum_{i=0}^\infty \gamma^i \max_k \epsilon_k = \frac{1}{1-\gamma} \|
\epsilon \|_\infty
\] 所以视野越长, 每次 iteration 都会注入误差, 误差会越大
最后我们结合一下采样误差(sample error)和近似误差(approximation error) \[ \begin{aligned} \| \hat Q_k - T\hat Q_{k-1} \|_\infty &= \vert{}\vert{}\hat{Q}_k - \hat T\hat{Q}_{k-1} + \hat T\hat{Q}_{k-1} - T\hat{Q}_{k-1}\vert{}\vert{}_\infty \\ &\leq \underbrace{ \vert{}\vert{} \hat{Q}_k - \hat T\hat{Q}_{k-1}\vert{}\vert{}_\infty }_{近似误差} + \underbrace{\vert{}\vert{} \hat T\hat{Q}_{k-1} - T\hat{Q}_{k-1} \vert{}\vert{}_\infty}_{采样误差} \end{aligned} \] 其实, 额, 现代 RL 更喜欢 \(p\) 范数不那么强的假设, 我们有一个类似的式子 \[ \vert{}\vert{}\hat{Q}_k - Q^\star\vert{}\vert{}_{p,\mu} = \left( E_{(\mathbf s,\mathbf a)\sim\mu(\mathbf s,\mathbf a)}[\vert{}\hat{Q}_k(\mathbf s,\mathbf a) - Q^\star(\mathbf s,\mathbf a)\vert{}^p] \right)^{1/p} \] 这里的 \(\mu\) 是 replay buffer 下的分布, 至于外面的就不管了
Lecture 18 变分推断与生成模型
不是来学 RL 的吗?这给我整哪来了?本部分的内容其实在前文都有提及, 只是深入一点罢了
从 概率模型(Probabilistic Model) 开始, 最简单概括一下, 它就是 \(p(x)\), 稍微复杂一点有 \(p(y|x)\), 我们这里关心 \(y\) 而不是 \(x\), \(x\) 是一种 evidence variable, \(y\) 是一种 query variable, 我们的 policy \(\pi_\theta(\mathbf a|\mathbf s)\) 就是一种条件概率模型
在本 lec, 我们主要关心隐变量模型(latent variable models), 隐变量是那些既不是 query variable 也不是 evidence variable 的变量, 它们需要被积分掉

我们想找到一个能准确拟合上面三个簇的分布, 在这里我们的隐变量是三值之一的分类离散变量
\(p(y|x) = \sum_z p(y|x,z)p(z|x)\) 的条件模型则可以举 lec 2 BC 中左右绕树的例子
更 general 一点, 我们的 \(p(x)\)
是一个复杂的东西, 而有一个简单的先验 \(p(z)\)
我们要学习条件分布 \(p(x|z)\),
通常这个分布的形式是简单的, 但是其参数可能是一个输入
\(z\) 的神经网络(非常复杂!), 例如 \(\mathcal N(\mu_{nn}(z),
\sigma_{nn}(z))\)

于是我们可以用 "简单" 的 \(p(x|z), p(z)\) 来表示 \(p(x)\), 有 \(p(x) = \int p(x|z)p(z) \mathrm dz\), 这就是我们表示复杂分布的方法
如何训练隐变量模型呢?我们的模型是 \(p_\theta(x)\), 数据有 \(\mathcal D=\{ x_1, x_2, x_3, \dots, x_N
\}\), 我们使用最大似然拟合, 有 \(\theta
\leftarrow \arg \max_{\theta} \dfrac{1}{N} \sum_i \log
p_\theta(x_i)\), 带入隐变量模型, 有 \[
\theta = \arg \max_\theta \frac{1}{N} \sum_i \log \left( \int
p_{\theta}(x_i|z)p(z) \mathrm dz \right)
\] 这样在数学上正确, 在计算上不可能, 我们最好拟合真正的
log-likelihood
我们可以优化 expected log-likelihood, 其正确性我们会稍后陈述, 具体地,
优化 \[
\theta \leftarrow \arg \max_\theta \frac{1}{N} \sum_i \mathbb E_{z \sim
p(z|x_i)} [\log p_\theta(x_i,z)]
\] 相当于猜测隐变量模型(猜测 \(x_i\) 对应的 \(z\), 假装它是正确的), 这里是从 \(p(z|x_i)\) 中做加权平均似然(猜测所有的
\(z\))
期望值可以用样本处理, 问题变成了怎么得到 \(p(z|x_i)\), 有没有觉得事情在向我们熟悉的
ELBO 发展?你的直觉是对的, 我们继续拿 \(q_i(z)
= \mathcal N(\mu_i, \sigma_i)\) 来近似 \(p(z|x_i)\),
问题是这样套娃拟合为什么会降低复杂度?\(p(z|x_i)\) 难道是什么很简单的东西吗?
\(q_i(z)\) 是单峰的, 我们可以证明它可以构建 \(\log p(x_i)\) 的下界, 然后把 max log-likelihood 问题变成了 max lowerbound 问题, 然后这个下界在某种意义上是紧的, 它很有用
我们现在重新推一下 lec 13 的式子, 我相信你肯定很会那些 \(\int ,\mathbb E\) 互换与加减项与 \(\log E(x) \geq E[\log x]\) 技巧 \[ \begin{aligned} \log p(x_i) &= \log \int_z p(x_i|z)p(z) \\ &= \log \int_z p(x_i|z) p(z) \frac{q_i(z)}{q_i(z)} \\ &= \log \mathbb E_{z \sim q_i(z)} \left[ \frac{p(x_i|z)p(z)}{q_i(z)} \right] \\ &\geq \mathbb E_{z \sim q_i(z)} \left[ \log \frac{p(x_i|z)p(z)}{q_i(z)} \right] \\ &= \mathbb E_{z \sim q_i(z)} [\log p(x_i|z) + \log p(z)] - \mathbb E_{z \sim q_i(z)} \log q_i(z) \\ &= \mathbb E_{z \sim q_i(z)} [\log p(x_i|z) + \log p(z)] + \mathcal H(q_i) \end{aligned} \]
RHS 就是 ELBO(Evidence Lower Bound, 证据下界), 我们提过这个了

直观理解 ELBO 对分布的塑造, max log p 会造成概率的尖峰, 然后最大化熵会稍稍 "展开" 尖峰使其没那么尖锐
ELBO 指出 \(\log p(x_i) \geq \mathbb E_{z
\sim q_i(z)} [\log p(x_i|z) + \log p(z)] + \mathcal H(q_i)\),
下面用 \(\mathcal L_i(p,q_i)\) 表示
RHS
如果 \(q_i(z) \approx p(z|x_i)\),
则下界是最紧的, 我们也可以引入 KL 散度再推一遍公式 \[
\begin{aligned}
D_{\text{KL}}(q(x_i \| p(z|x_i)) &= \mathbb E_{z \sim q_i(z)} \left[
\log\frac{q_i(z)}{p(z|x_i)} \right] = \mathbb E_{z \sim q_i(z)} \left[
\log\frac{q_i(z)p(x_i)}{p(x_i,z)} \right] \\
&= -\mathbb E_{z \sim q_i(z)} \left[ \log p(x_i|z) + \log p(z)
\right] + \mathbb E_{z \sim q_i(z)} \left[ \log q_i(z) \right] + \mathbb
E_{z \sim q_i(z)} \left[ \log p(x_i) \right] \\
&= -\mathbb E_{z \sim q_i(z)} \left[ \log p(x_i|z) + \log p(z)
\right] - \mathcal H(q_i) + \log p(x_i) \\
&= - \mathcal L_i(p,q_i) + \log p(x_i)
\end{aligned}
\] 于是 \(\log p(x_i) =
D_{\text{KL}}(q_i(z) \| p(z|x_i)) + \mathcal L_i(p,q_i) \geq \mathcal
L_i(p,q_i)\)
这证明了下界可以是紧的, 只要我们的多维高斯 \(q_i(z)\) 正好能够模拟 \(p(z|x_i)\) 就行(真的可能吗?)
这提示我们在实操工程中的学习方法, 先学习 \(q\) 来提高下界, 再学习 \(p\), 轮流转, 这是传统的 EM algorithm
深入工程部分发现坑会很多

我可以取 \(x_i\), 我可以对于 \(z \sim q_i(z)\) 然后得到 \(\mathcal L_i(p,q_i)\), 然后我可以做 \(\theta \leftarrow \theta + \alpha \nabla_\theta
\mathcal L_i(p,q_i)\) 的梯度上升来更新 policy, 但我怎么更新 \(q\)
\(q\) 的参数量好像很大啊, 每一个 \(x_i\) 都有对应的 \((\mu_i, \sigma_i)\), 这样虽然准确了一点,
但是不可能完成
于是继续遇事不决神经网络, 首先, 网络 \(p_\theta(x|z)\) 是生成器, 我们引入这个神经网络后发现积分仍然不可优化, 转而优化 ELBO, 要优化一个 \(\mathcal L_i\), 拆到最后发现要学习网络推断器 \(q_\phi(z|x_i)\) 优化参数 \(\phi\), 这个神经网络的输出是多元高斯分布的参数
这种方法论叫做摊销变分推断(Amortized Variational Inference, AVI), 变分自编码器(VAE) 是 AVI 在深度学习领域最著名的具体实现架构
不不不, 不能直接一个网络去拟合 \(p(x)\), 不然有维度灾难, 匮乏生成新样本的能力以及缺失中间表示的结构
我们没有显示算 \(p(x)\), 而是优化 \(\log p(x)\) 的下界(ELBO), 我们生成的数据 \(p_\theta(x|z)\) 越来越像, 猜测的后验 \(q_\phi(z|x)\) 也越来越准
于是目前的流程是: (对于每个 \(x_i\))计算 \(\nabla_\theta \mathcal L(p_\theta(x_i|z), q_\phi(z|x_i))\), 采样 \(z \sim q_\phi(z|x_i)\), 计算 \(\nabla_\theta \mathcal L \approx \nabla_\theta \log p_\theta(x_i|z)\), 然后做梯度下降, \(\theta \leftarrow \alpha \nabla_\theta \mathcal L\), 还有 \(\phi \leftarrow \alpha \nabla_\phi \mathcal L\)
如果你没被绕晕的话, 我们还没说怎么计算 \(\nabla_\phi \mathcal L\)
对于 \(\mathcal L_i = \mathbb E_{z \sim
q_\phi(z|x_i)} [\log p_\theta(x_i|z) + \log p(z)] + \mathcal
H(q_\phi(z|x_i))\) 中, \(\phi\)
出现在了两处, 一是取期望的分布, 二是熵项
对于第一项, 我们能不能理解为 \(J(\phi) = \mathbb E_{z \sim q_\phi(z|x_i)} [r(x_i,
z)]\) 然后做 policy gradient?
可以, 但 policy gradient 并非最优, 因为不是在未知的 \(\tau \sim p_\theta(\tau)\) 上做,
而是在已知的 \(z \sim q_\phi(z|x_i)\)
上做的
我们的 \(q_\phi\) 是一个高斯分布,
我们可以使用重参数化技巧, 令 \(z = \mu_\phi(x)
+ \epsilon \sigma_\phi(x),\) 其中 \(\epsilon \sim \mathcal N(0,1)\), 于是 \[
\begin{aligned}
J(\phi) &= \mathbb E_{z \sim q_\phi(z|x_i)} [r(x_i, z)] \\
&= \mathbb E_{\epsilon \sim \mathcal N(0,1)} [r(x_i, \mu_\phi(x) +
\epsilon \sigma_\phi(x))]
\end{aligned}
\] 现在我们估计 \(\nabla_\phi
J(\phi)\) 的流程如下:
首先, 从 \(\mathcal N(0,1)\) 中采样
\(\epsilon_1, \dots, \epsilon_M\),
然后蒙特卡洛估计, \(\nabla_\phi J(\phi)
\approx \dfrac{1}{M} \sum_j \nabla_\phi r(x_i, \mu_\phi(x_i) +
\epsilon_j \sigma_\phi(x_i))\)
这里的 \(r\) 是 \(\log p_\theta(x_i|z) + \log p(z)\),
对它求导是可行的, policy gradient 则没有用到 \(r\) 的导数, 导致方差很大, 缺少 \(r\) 的信息
另一种理解为:
policy gradient: 对分布参数求导, 使用 \(\nabla_\phi \log q_\phi\), 把 \(r\) 当黑盒评分
重参数化: 对样本映射求导, 使用 \(\nabla_z r \cdot \nabla_\phi z\), 利用 \(r\) 的局部梯度
对于第二项, 因为 \(q_\phi(z|x) = \mathcal N(\mu_\phi(x), \sigma_\phi(x))\), 它本质是解析的, 可以见 知乎笔记 3.2 部分
对于单样本使用上文的重参数化方法, 因为 \(\mathbb E_{z \sim q_\phi(z|x_i)} \log p(z) + \mathcal H(q_\phi(z|x_i)) = - D_{\text{KL}} (q_\phi(z|x_i) \| p(z))\), 有 \[ \mathcal L_i \approx \log p_\theta (x_i | \mu_\phi(x_i) + \epsilon \sigma_\phi(x_i)) - D_{\text{KL}} (q_\phi(z|x_i) \| p(z)) \] 其中前项可以反向传播, 后项因为是对两个高斯分布做 KL 散度, 本质是解析的, 也能反向传播

上面就是整个的计算图

现在才开始讲 VAE 是不是有点晚了?上面就是 VAE 的模型架构,
计算图还是那个计算图, 最终目标可以写成 \[
\max_{\theta, \phi} \frac{1}{N} \sum_i \log p_\theta(x_i |
\mu_\phi(x_i)+ \epsilon \sigma_\phi(x_i)) - D_{\text{KL}} (q_\phi(z|x_i)
\| p(z))
\] 变分自编码器 VAE
使我们能够训练一个能表示某种输入(通常是图像)的隐变量模型
训练好模型后, 使用 \(z \sim p(z), x \sim
p(x|z)\) 来获得一个 \(x\)
VAE 主要用于 representation learning, 例如在 Atari 游戏中, 我们先训练
VAE, 然后用 \(z\) 替代 \(\mathbf s\) (eg. Atari 游戏画面)
作为更好的状态表示
为什么 \(z\) 是更好的状态表示?首先,
\(z\) 的维度之间互相独立,
可以解耦图像的变化
从 \(p(x)\) 到 \(p(y|x)\) 的条件模型会有什么变化?这里 \(p(y|x)\) 可能是复杂多峰的, 并且我们不关心
\(x\) 的分布
做法大体类似, 两个网络都增加一个 \(x\)
输入, 有 \[
\mathcal L_i = \mathbb E_{z \sim q_\phi(z|x_i, y_i)} [\log p_\theta
(y_i|x_i,z) + \log p(z|x_i)] + \mathcal H(q_\phi(z|x_i, y_i))
\] 
架构也没有太大变化, 多模态模仿学习中常用这一类方法
再复杂一点, 我们要上 State space models 了, 从 单帧静态隐变量 扩展到
时间序列隐状态轨迹
对于 POMDP, 我们把整个 \(z_1, z_2, \dots,
z_T\) 当成 hidden state, 把整个观测序列 \(o_1, o_2, \dots, o_T\) 当成 \(\mathbf x\)

我们的 prior 不再独立, 除了第一步从高斯中来, 剩下的都是 dynamic
得到的
我们的 decoder 是独立的, 但 encoder 不是,
因为单个观测实际上不足以表示整个 hidden state
不过, 额, 这个其实比较自由, 如果你看了 Lec 12 的 Dreamer 补充, STORM 的 image encoder 就是
\(z_t \sim q_\phi(z_t|o_t) = \mathcal
Z_t\),
这可能也算一种解耦?不过这样可能会丧失一点时间维度上的表示力

Lecture 19 控制与推理
本节研究如何将控制问题重新定义为推理问题, 有点困难,
有一些看上去很吓人的东西, 知乎笔记, SAC
笔记 Policy Gradient Algorithms | Lil'Log
唉唉, 越学 RL 越发现混乱, 我们学习的顺序不是线性的, 也不是树状的,
马上就要成为 DAG 甚至是有环图了, 现在我们重新学 actor-critic 算法,
本节还会讲一下 Soft
Actor-Critic 看看它 Soft 在哪里
我们认为人类是理性的, 也就是说, 人类被某种效用函数驱使进行各种活动,
如果我们能知道效用函数, 那么就能更好预测人类的行为动作
但人类也不是完全理性的, 走路不一定按照两点之间线段最短进行, 行为存在
stochastic
我们可以证明在 fully-observed 的情况下, 最优策略是确定性策略; 需要一点
"无伤大雅的随机性"

下面重新建模一下 RL 问题, 不加解释的引入一些定义(为了某种最终数学理论优雅 soft), 可能有点抽象
我们的目标还是建模 \(p(\mathbf s_{1:T}, \mathbf a_{1:T})\), 引入二进制变量 \(\mathcal O\) 表示在这一时刻是否试图达到最优, 目标变成了 \(p(\tau|\mathcal O_{1:T})\), 这里设置 \(p(\mathcal O_t | \mathbf s_t, \mathbf a_t) = \exp(r(\mathbf s_t, \mathbf a_t))\) (其中 reward 为负值来保证概率处于 [0,1] 间), 有点像 q-iteration 中的那种随机性设置, 于是有 \[ \begin{aligned} p(\tau | \mathcal O_{1:T}) &= \frac{p(\tau, \mathcal O_{1:T})}{p(\mathcal O_{1:T})} \\ &\propto p(\tau) \prod_t \exp(r(\mathbf s_t, \mathbf a_t)) = p(\tau) \exp \left( \sum_t r(\mathbf s_t, \mathbf a_t) \right) \end{aligned} \] 在确定性 dynamic 情况下, \(p(\tau)\) 只是一个 0/1 指示变量, 最可能的轨迹是概率最高的轨迹, 其余轨迹仍然概率非 0, 我们建模了次优行为(这不就是个 trick?)
在这个图模型中, 我们有三种操作值得关心
一是计算反向消息, \(\beta_t(\mathbf s_t,
\mathbf a_t) = p(\mathcal O_{t:T}|\mathbf s_t, \mathbf a_t)\),
这代表给定当前的状态和行为, 当前及之后的行为是否最优
二是计算 policy, \(p(\mathbf a_t | \mathbf
s_t, \mathcal O_{1:T})\), 我感觉 \(\mathcal O\) 给了一个期望/先验来塑造 \(\mathbf a\)?
三是计算正向消息, \(\alpha_t(\mathbf s_t) =
p(\mathbf s_t|\mathcal O_{1:t-1})\), 代表如果前面的行为满足最优,
那么当前状态的分布是什么
先从反向消息开始推导 $$ \[\begin{aligned} \beta_t(\mathbf{s}_t,\mathbf{a}_t) &= p(\mathcal{O}_{t:T} | \mathbf{s}_t,\mathbf{a}_t) \\ &= \int p(\mathcal{O}_{t:T},\mathbf{s}_{t+1} | \mathbf{s}_t,\mathbf{a}_t) \mathrm d \mathbf{s}_{t+1}\\ &= \int \textcolor{red}{\underline{\textcolor{black}{p(\mathcal{O}_{t+1:T}\mid\mathbf{s}_{t+1})}}} p(\mathbf{s}_{t+1} | \mathbf{s}_t,\mathbf{a}_t) p(\mathcal{O}_{t} | \mathbf{s}_t,\mathbf{a}_t) \mathrm d \mathbf{s}_{t+1} \\[6pt] \textcolor{red}{\underline{\textcolor{black}{p(\mathcal{O}_{t+1:T}\mid\mathbf{s}_{t+1})}}} &= \int p(\mathcal{O}_{t+1:T}|\mathbf{s}_{t+1}, \mathbf{a}_{t+1}) p(\mathbf{a}_{t+1} | \mathbf{s}_{t+1}) \mathrm d \mathbf{a}_{t+1} \\ &= \int \beta_{t+1}(\mathbf{s}_{t+1},\mathbf{a}_{t+1}) p(\mathbf{a}_{t+1} | \mathbf{s}_{t+1}) \mathrm d \mathbf{a}_{t+1} \\ \end{aligned}\]这里不一定是最优, 只是一般用最优, 即 \(\mathcal O = \mathbf 1\), 但也可以换成任意 01 序列, 下文默认 \(\mathcal O_t \Leftrightarrow \mathcal O_t = 1\)
$$ 我们认为原式子是 \(\mathbf
s_{t+1}\) 边缘化的结果, 于是插回去,
然后总的思想是恢复递归函数定义, 建立 \(\beta_t\) 与 \(\beta_{t+1}\) 的关系
一个有趣的问题是 \(p(\mathbf{a}_{t+1} |
\mathbf{s}_{t+1})\) 是什么?它不是 policy, 而是动作先验, 真正的
policy 现在要考虑 \(\mathcal O\)
了
如果在尚未考虑 "未来是否表现良好" 的情况下,
我们可以假设它是均匀(uniform)的, 这代表这项是一个可忽略常数
推导完这些后就可以从 \(T-1 \to 1\) 计算反向消息了, 有 \[ \beta_t(\mathbf{s}_t,\mathbf{a}_t) = p(\mathcal{O}_{t} | \mathbf{s}_t,\mathbf{a}_t) \mathbb E_{\mathbf s_{t+1} \sim p(\mathbf s_{t+1} |\mathbf s_{t} ,\mathbf a_{t} )} [\beta_{t+1}(\mathbf{s}_{t+1})] \\ 其中 \;\beta_{t}(\mathbf{s}_{t}) = \mathbb E_{\mathbf a_{t} \sim p(\mathbf s_{t}|\mathbf a_{t})} [\beta_t(\mathbf{s}_t,\mathbf{a}_t)] \] 这里有变化 \(\int p(\mathbf{s}_{t+1} | \mathbf{s}_t,\mathbf{a}_t)\mathrm d \mathbf{s}_{t+1} = \mathbb E_{\mathbf s_{t+1} \sim p(\mathbf s_{t+1} |\mathbf s_{t} ,\mathbf a_{t})}\)
接下来我们要用 closer(more abstract) 的方式来理解上文, \(\log \beta_t\) 是 "Q-function like"
的
令 \(V_t(\mathbf s_t) = \log \beta_t(\mathbf
s_t),\; Q_t(\mathbf s_t, \mathbf a_t) = \log \beta_t(\mathbf s_t,
\mathbf a_t)\), 在 log space 上, 有 \[
V_t(\mathbf s_t) = \log \int \exp(Q_t(\mathbf s_t, \mathbf a_t)) \mathrm
d \mathbf a_t
\] exp 完后 log 会让 Q 中最大的 (s,a) 对占据主导, 这就是 soft
max(不是 softmax)
另一方面说, 有 \[
Q_t(\mathbf s_t, \mathbf a_t) = r(\mathbf s_t, \mathbf a_t) + \log
\mathbb E [\exp(V_{t+1}(\mathbf s_{t+1}))]
\] 在确定性情况下, 转移唯一, 与 bellman equation 等价
在随机情况下, 最大项会主导转移, 这其实不是一个好想法(因为动作可以选择,
而小概率高价值状态却不能保证)
我们后面会解决随机情况的问题
如果动作先验 \(p(\mathbf{a}_{t+1} | \mathbf{s}_{t+1})\) 不是均匀分布的会怎样?
此时 \(V_t(\mathbf s_t) = \log \int \exp(Q_t(\mathbf s_t, \mathbf a_t) + \log p(\mathbf a_t|\mathbf s_t)) \mathrm d \mathbf a_t\)
我们只要重新定义 \(\tilde Q_t(\mathbf s_t, \mathbf a_t) = r(\mathbf s_t, \mathbf a_t) + \log p(\mathbf a_t|\mathbf s_t) + \log \mathbb E [\exp(V_{t+1}(\mathbf s_{t+1}))]\) 即可, 我们总是可以通过调整 reward 的方式来融入动作先验的影响
接下来看看怎么计算 policy \(p(\mathbf
a_t|\mathbf s_t, \mathcal O_{1:T})\), 有 \[
\begin{aligned}
p(\mathbf a_t|\mathbf s_t, \mathcal O_{1:T})
&= p(\mathbf a_t|\mathbf s_t, \mathcal O_{t:T}) \quad
\text{(过去未来独立性)}\\
&= \frac{p(\mathbf a_t, \mathbf s_t|\mathcal O_{t:T})}{p(\mathbf
s_t| \mathcal O_{t:T})} \\
&= \frac{p(\mathcal O_{t:T}|\mathbf a_t, \mathbf s_t)p(\mathbf a_t,
\mathbf s_t)/p(\mathcal O_{t:T})}{p(\mathcal O_{t:T}|\mathbf
s_t)p(\mathbf s_t)/p(\mathcal O_{t:T})} \quad \text{(分子分母用
bayes' rule)} \\
&= \frac{p(\mathcal O_{t:T}|\mathbf a_t, \mathbf s_t)}{p(\mathcal
O_{t:T}| \mathbf s_t)} \frac{p(\mathbf a_t, \mathbf s_t)}{p(\mathbf
s_t)} \\
&= \frac{\beta_t(\mathbf s_t, \mathbf a_t)}{\beta_t(\mathbf s_t)}
p(\mathbf a_t|\mathbf s_t) = C \cdot \frac{\beta_t(\mathbf s_t, \mathbf
a_t)}{\beta_t(\mathbf s_t)} \quad \text{(忽略动作先验)}
\end{aligned}
\] 这就代表 policy 可以从反向消息中恢复, 有 \(\pi(\mathbf a_t|\mathbf s_t) =
\dfrac{\beta_t(\mathbf s_t, \mathbf a_t)}{\beta_t(\mathbf
s_t)}\)
或者, 在 log space 中, 有 \(\pi(\mathbf
a_t|\mathbf s_t) = \exp(Q_t(\mathbf s_t, \mathbf a_t) - V_t(\mathbf
s_t)) = \exp(A_t(\mathbf s_t, \mathbf a_t))\),
也可以加入 temperature \(\alpha\), 此时
\(\pi(\mathbf a_t|\mathbf s_t) =
\exp(\dfrac{1}{\alpha}A_t(\mathbf s_t, \mathbf a_t))\), 可以在
hard max 和 soft max 之间插值
最后计算正向消息 \(\alpha_t(\mathbf s_t) = p(\mathbf s_t|\mathcal O_{1:t-1})\) \[ \begin{aligned} \alpha_t(\mathbf{s}_t) &= p(\mathbf{s}_t | \mathcal{O}_{1:t-1}) \\[2pt] &= \int p(\mathbf{s}_t,\mathbf{s}_{t-1},\mathbf{a}_{t-1}|\mathcal{O}_{1:t-1}) \,\mathrm{d}\mathbf{s}_{t-1} \,\mathrm{d}\mathbf{a}_{t-1} \\[2pt] &= \int p(\mathbf{s}_t|\mathbf{s}_{t-1},\mathbf{a}_{t-1},\mathcal{O}_{1:t-1}) p(\mathbf{a}_{t-1}|\mathbf{s}_{t-1},\mathcal{O}_{1:t-1}) p(\mathbf{s}_{t-1}|\mathcal{O}_{1:t-1}) \,\mathrm{d}\mathbf{s}_{t-1} \,\mathrm{d}\mathbf{a}_{t-1} \\[2pt] &= \int p(\mathbf{s}_t|\mathbf{s}_{t-1},\mathbf{a}_{t-1}) p(\mathbf{a}_{t-1}|\mathbf{s}_{t-1},\mathcal{O}_{t-1}) p(\mathbf{s}_{t-1}|\mathcal{O}_{1:t-1}) \,\mathrm{d}\mathbf{s}_{t-1} \,\mathrm{d}\mathbf{a}_{t-1} \end{aligned} \] 整体方法类似反向消息, 我们得到三项, 第一项是 dynamic, 考虑剩余两项, 全部应用 Bayes' rule \[ \begin{aligned} &p(\mathbf{a}_{t-1}|\mathbf{s}_{t-1},\mathcal{O}_{t-1}) p(\mathbf{s}_{t-1}|\mathcal{O}_{1:t-1}) \\ &\quad= \frac{ p(\mathcal{O}_{t-1}|\mathbf{s}_{t-1},\mathbf{a}_{t-1}) p(\mathbf{a}_{t-1}|\mathbf{s}_{t-1}) }{p(\mathcal{O}_{t-1}|\mathbf{s}_{t-1})}\, \frac{ p(\mathcal{O}_{t-1}|\mathbf{s}_{t-1}) p(\mathbf{s}_{t-1}|\mathcal{O}_{1:t-2}) }{p(\mathcal{O}_{t-1}|\mathcal{O}_{1:t-2})} \\ \\ &本质是\; p(\mathbf{a}_{t-1}|\mathbf{s}_{t-1},\mathcal{O}_{t-1})p(\mathcal{O}_{t-1}|\mathbf{s}_{t-1}) = p(\mathbf{a}_{t-1},\mathcal{O}_{t-1}|\mathbf{s}_{t-1}) = p(\mathcal{O}_{t-1}|\mathbf{s}_{t-1},\mathbf{a}_{t-1})p(\mathbf{a}_{t-1}|\mathbf{s}_{t-1}) \\ &以及\; p(\mathbf{s}_{t-1}|\mathcal{O}_{1:t-1})p(\mathcal{O}_{t-1}|\mathcal{O}_{1:t-2}) = p(\mathbf{s}_{t-1},\mathcal{O}_{t-1}|\mathcal{O}_{1:t-2}) = p(\mathcal{O}_{t-1}|\mathbf{s}_{t-1})p(\mathbf{s}_{t-1}|\mathcal{O}_{1:t-2}) \end{aligned} \] 于是 \[ \begin{aligned} &p(\mathbf{a}_{t-1}|\mathbf{s}_{t-1},\mathcal{O}_{t-1}) p(\mathbf{s}_{t-1}|\mathcal{O}_{1:t-1}) \\ &\quad= \frac{ p(\mathcal{O}_{t-1}|\mathbf{s}_{t-1},\mathbf{a}_{t-1}) p(\mathbf{a}_{t-1}|\mathbf{s}_{t-1}) p(\mathbf{s}_{t-1}|\mathcal{O}_{1:t-2}) }{p(\mathcal{O}_{t-1}|\mathcal{O}_{1:t-2})}\, \end{aligned} \] 其中 \(p(\mathcal{O}_{t-1}|\mathbf{s}_{t-1},\mathbf{a}_{t-1})\) 是第一步反向消息(通常已知), \(p(\mathbf{a}_{t-1}|\mathbf{s}_{t-1})\) 是动作先验(扔掉), \(p(\mathbf{s}_{t-1}|\mathcal{O}_{1:t-2})\) 是 \(\alpha_{t-1}(\mathbf s_{t-1})\)(我们递归处理的部分, \(1 \to T\)), \(p(\mathcal{O}_{t-1}|\mathcal{O}_{1:t-2})\) 是 normalization factor, 归一化就行, 更多细节略
我们还可以得到 state marginal \(p(\mathbf
s_t | \mathcal O_{1:T})\), 它代表如果整条轨迹都试图最优, 在第
\(t\) 步最可能位于哪些状态 \[
\begin{aligned}
p(\mathbf{s}_t|\mathcal{O}_{1:T})
&=
\frac{p(\mathbf{s}_t,\mathcal{O}_{1:T})}{p(\mathcal{O}_{1:T})}
=\frac{
p(\mathcal{O}_{t:T}|\mathbf{s}_t)
p(\mathbf{s}_t,\mathcal{O}_{1:t-1})
}{p(\mathcal{O}_{1:T})} \\[2pt]
&=
p(\mathcal{O}_{t:T}|\mathbf{s}_t)
p(\mathbf{s}_t|\mathcal{O}_{1:t-1})
\frac{p(\mathcal{O}_{1:t-1})}{p(\mathcal{O}_{1:T})}\\[2pt]
&\propto
\beta_t(\mathbf{s}_t)\,\alpha_t(\mathbf{s}_t)
\end{aligned}
\] 最后一步是因为 \(p(\mathcal
O_{1:t-1})/p(\mathcal O_{1:T})\) 不随着 \(\mathbf s_t\) 改变, 只是归一化常数
这个式子其实特别优雅, 它告诉我们一个状态在给定 \(\mathcal O_{1:T}\)
下的出现概率与反向消息乘以正向消息成正比

反向消息和正向消息各自构成一个锥形代表能够达到目标的状态,
状态边缘分布就是两个锥形的交集,
代表能够从起点达到终点的那些可能状态
中间步骤的可能状态最多, 而起点与终点较为确定, 状态较小,
这是符合直觉的
目前所讨论的推理过程都是精确推理, 在复杂高维连续空间, 动态未知的场景中怎么办呢?这就要用到变分推理工具了
之前, 我们将 状态反向消息 与
状态-动作反向消息 的对数解释为价值函数和 Q 函数
我们说 \(Q_t(\mathbf s_t, \mathbf a_t) =
r(\mathbf s_t, \mathbf a_t) + \log \mathbb E [\exp(V_{t+1}(\mathbf
s_{t+1}))]\) 是有问题的, 它会被最幸运的状态主导
为什么会出现这种情况?因为有点因果倒置了, marginalize 了 state,
如果假设取得最优解, 那一定是买彩票取得的,
即使真实去买彩票大概率会亏钱
我们想知道 \(p(\mathbf s_{1:T}, \mathbf
a_{1:T} | \mathcal O_{1:T})\) 或是 \(p(
\tau | \mathcal O_{1:T})\), 然而在边缘化 state 后 policy 变成了
\(p(\mathbf a_{t} | \mathbf s_{t}, \mathcal
O_{1:T})\)

另一种看法为 \(p(\mathbf s_{t+1} | \mathbf s_t, \mathbf a_t, \mathcal O_{1:T}) \neq p(\mathbf s_{t+1} | \mathbf s_t, \mathbf a_t)\), 我们本质上改变了动态, 但动态是不能变的
我们想找到新的轨迹分布 \(q(\mathbf s_{1:T}, \mathbf a_{1:T})\), 它接近高奖励轨迹的后验 \(p(\mathbf a_{t} | \mathbf s_{t}, \mathcal O_{1:T})\) , 同时固定环境动力学 \(p(\mathbf s_{t+1} | \mathbf s_t, \mathbf a_t)\)
如果我们假设 \(\mathbf x = \mathcal O_{1:T}, \mathbf z = (\mathbf s_{1:T}, \mathbf a_{1:T})\), 这个问题等价于寻找 \(q(\mathbf z)\) 来近似 \(p(\mathbf z|\mathbf x)\), 其中 \(q\) 只在真实的环境中 \[ q(\tau)=p(\mathbf s_1) \prod_t \underbrace{q(\mathbf a_t | \mathbf s_t)}_{\text{可以优化的策略}} \underbrace{p(\mathbf s_{t+1} | \mathbf s_t,\mathbf a_t)}_{\text{保持真实环境转移}} \] 我们只学习 \(q(\mathbf a_t | \mathbf s_t)\), 这就是轨迹分布, 下文 \(q\) 变 \(\pi\) 的时候不要惊讶

还记得吗? \(\underbrace{\log p(\mathcal
O_{1:T})}_{\text{与 q 无关}} = \underbrace{ \mathbb E_{\tau\sim q}
\left[\log p(\tau,\mathcal O_{1:T})-\log q(\tau)\right] }_{\mathcal
L(q)\text{: 下界}} + \underbrace{ D_{\mathrm{KL}}\!\left(
q(\tau)\,\|\,p(\tau |\mathcal O_{1:T}) \right) }_{\geq 0}\),
提升下界就是最小化 \(q\) 与后验的 KL
散度。于是, 孩子们, 我们又要去推 log p(x) >= ELBO
那坨玩意了(这是这份笔记第几次干这活了?)
我们宇宙的起点是 \(\log p(\mathbf x) \geq
\mathbb E_{\mathbf z \sim q(\mathbf z)} [\log p(\mathbf x, \mathbf z) -
\log q(\mathbf z)]\), 有 \[
\begin{aligned}
\log p(\mathcal O_{1:T})
&\geq \mathbb E_{(\mathbf s_{1:T}, \mathbf a_{1:T}) \sim q}
[\log p(\mathbf s_1) + \sum_{t=1}^T \log p(\mathbf s_{t+1}|\mathbf s_t,
\mathbf a_t) + \sum_{t=1}^T \log p(\mathcal O_t | \mathbf s_t, \mathbf
a_t) \\
&\quad\quad\quad\quad\quad\quad \underbrace{-\log p(\mathbf s_1) -
\sum_{t=1}^T \log p(\mathbf s_{t+1}|\mathbf s_t, \mathbf a_t) -
\sum_{t=1}^T \log q(\mathbf a_{t}|\mathbf s_t)}_{\log q(\mathbf z)} ] \\
&= \mathbb E_{(\mathbf s_{1:T}, \mathbf a_{1:T}) \sim q} \left[
\sum_t ( r(\mathbf s_t, \mathbf a_t) - \log q(\mathbf a_t|\mathbf s_t) )
\right] \\
&= \sum_t \mathbb E_{(\mathbf s_{t}, \mathbf a_{t}) \sim q}
[r(\mathbf s_t, \mathbf a_t) + \mathcal H(q(\mathbf a_t|\mathbf s_t))]
\end{aligned}
\] 啊什么 reward 是哪来的?还记得 \(p(\mathcal O_t=1\mid\mathbf s_t,\mathbf a_t)
\propto \exp\bigl(r(\mathbf s_t,\mathbf a_t)\bigr)\)
吗?取对数就是了
于是我们要最大化 \(\sum_t \mathbb E_{(\mathbf
s_{t}, \mathbf a_{t}) \sim q} [r(\mathbf s_t, \mathbf a_t) + \mathcal
H(q(\mathbf a_t|\mathbf s_t))]\), 这看起来就很 RL 了
额, 我们倒着做, 有点像 LQR, 对于 \(T\) 与 \(q(\mathbf a_T|\mathbf s_T)\) 还是简单的吧, 有 \[ \begin{aligned} q(\mathbf{a}_T | \mathbf{s}_T) &= \underset{q(\cdot | \mathbf{s}_T)}{\arg\max}\; \mathbb{E}_{\mathbf{s}_T\sim q} \left[ \mathbb{E}_{\mathbf{a}_T\sim q(\mathbf{a}_T\mid\mathbf{s}_T)} [r(\mathbf{s}_T,\mathbf{a}_T)]+ \mathcal{H}\bigl(q(\mathbf{a}_T|\mathbf{s}_T)\bigr) \right] \\[4pt] &= \underset{q(\cdot |\mathbf{s}_T)}{\arg\max}\; \mathbb{E}_{\mathbf{s}_T\sim q} \left[ \mathbb{E}_{\mathbf{a}_T\sim q(\mathbf{a}_T\mid\mathbf{s}_T)} \left[ r(\mathbf{s}_T,\mathbf{a}_T)- \log q(\mathbf{a}_T|\mathbf{s}_T) \right] \right] \end{aligned} \] 我们可以证明这个优化问题的解为 \(q^*(\mathbf a_T | \mathbf s_T) = \dfrac{\exp(r(\mathbf s_T,\mathbf a_T))} {\int \exp(r(\mathbf s_T,\mathbf a))\,\mathrm d\mathbf a} = \exp (Q(\mathbf s_T,\mathbf a_T) - V(\mathbf s_T))\)
注意到最后一步没有未来奖励, \(Q_T(\mathbf
s_T,\mathbf a_T) = r(\mathbf s_T,\mathbf a_T)\), 于是 \[
\begin{aligned}
&\quad
\mathbb{E}_{\mathbf{s}_T\sim q}
\left[
\mathbb{E}_{\mathbf{a}_T\sim q(\cdot\mid\mathbf{s}_T)}
\left[
r(\mathbf{s}_T,\mathbf{a}_T)-
\log q^*(\mathbf{a}_T|\mathbf{s}_T)
\right]
\right] \\
&= \mathbb{E}_{\mathbf{s}_T\sim q}
\left[
\mathbb{E}_{\mathbf{a}_T\sim q(\cdot\mid\mathbf{s}_T)}
\left[
r(\mathbf{s}_T,\mathbf{a}_T)-
\log (\exp (r(\mathbf{s}_T,\mathbf{a}_T) - V(\mathbf s_T)))
\right]
\right] \\
&= \mathbb{E}_{\mathbf{s}_T\sim q}
\left[
\mathbb{E}_{\mathbf{a}_T\sim q(\cdot\mid\mathbf{s}_T)}
\left[
V(\mathbf s_T)
\right]
\right]
\end{aligned}
\] 于是递归往回做, 有 \[
\begin{aligned}
q(\mathbf{a}_t | \mathbf{s}_t)
&=
\underset{q(\cdot\mid\mathbf{s}_t)}{\arg\max}\;
\mathbb{E}_{\mathbf{s}_t\sim q}
\Bigg[
\mathbb{E}_{\mathbf{a}_t\sim
q(\mathbf{a}_t\mid\mathbf{s}_t)}
\left[
r(\mathbf{s}_t,\mathbf{a}_t)
+
\mathbb{E}_{\mathbf{s}_{t+1}\sim
p(\cdot\mid\mathbf{s}_t,\mathbf{a}_t)}
[V_{t+1}(\mathbf{s}_{t+1})]
\right]
+
\mathcal{H}\bigl(q(\cdot|\mathbf{s}_t)\bigr)
\Bigg] \\[4pt]
&=
\underset{q(\cdot\mid\mathbf{s}_t)}{\arg\max}\;
\mathbb{E}_{\mathbf{s}_t\sim q}
\left[
\mathbb{E}_{\mathbf{a}_t\sim
q(\mathbf{a}_t\mid\mathbf{s}_t)}
[Q_t(\mathbf{s}_t,\mathbf{a}_t)]
+
\mathcal{H}\bigl(q(\cdot | \mathbf{s}_t)\bigr)
\right] \\[4pt]
&=
\underset{q(\cdot\mid\mathbf{s}_t)}{\arg\max}\;
\mathbb{E}_{\mathbf{s}_t\sim q}
\left[
\mathbb{E}_{\mathbf{a}_t\sim
q(\mathbf{a}_t\mid\mathbf{s}_t)}
\left[
Q_t(\mathbf{s}_t,\mathbf{a}_t)
-
\log q(\mathbf{a}_t | \mathbf{s}_t)
\right]
\right]
\end{aligned}
\] 这里最优解的直觉还是 \(q(\mathbf{a}_t | \mathbf{s}_t) \propto
\exp(Q(\mathbf{a}_t | \mathbf{s}_t))\),
可以拉格朗日慢慢推来验证这个
这就是 soft value iteration 算法

额, 总结就是动作可以 soft max, 转移不行, 这样做才是对的,
为了证明这样是对的, 我们推了一车式子, 我感觉 ELBO 的思路很好,
剩下的有点水到渠成的意味, 如果是 RL 大师可能不用推式子就能看出来
更前面的那些反向消息, policy 计算, 正向消息的推导解决了一些后验问题, 在
Lec 20 Inverse RL 中会有用的
| 方法 | 下一状态: 算 Q | 动作:算 V |
|---|---|---|
| 普通 value iteration | \(Q=r+\mathbb E[V(s')]\) | \(V=\max_a Q(s,a)\) |
| soft value iteration | \(Q=r+\mathbb E[V(s')]\) | \(V=\log \int_a \exp({Q(s,a)})\) |
| 乐观问题错误方法 | \(Q=r+\log\mathbb E[e^{V(s')}]\) | \(V=\log \int_a \exp({Q(s,a)})\) |
这个算法有一些变体, 例如加 discount, \(Q=r+ \gamma\mathbb E[V(s')]\), 加 temperature, \(V=\alpha \log \int_a \exp(1/\alpha\;{Q(s,a)})\)
我们可以从 soft value iteration 推出 soft Q-learning 和 SAC
soft Q-learning 用一张图片就能概括了

这里的 \(\int\)
就说明了要遍历所有的 action
在大型连续空间中, 用 \(\pi_\theta\)
来近似 \(\pi^\star\) 让网络最小化 \(D_{\mathrm{KL}}(\pi_\theta(\cdot | \mathbf
s)\|\pi^*(\cdot | \mathbf s))\), 有 \[
\begin{aligned}
D_{\mathrm{KL}}(\pi_\theta\|\pi^\star)
&=\mathbb E_{\mathbf a\sim\pi_\theta}
[\log\pi_\theta(\mathbf a | \mathbf s)-Q_\phi(\mathbf s,\mathbf a)] +
\log Z(\mathbf s)\\
&=
V(\mathbf s)-\left(
\mathbb E_{\mathbf a\sim\pi_\theta}[Q_\phi(\mathbf s,\mathbf a)]
+\mathcal H(\pi_\theta(\cdot | \mathbf s))
\right)
\end{aligned}
\]
\(\pi(\mathbf a|\mathbf s) =
\exp(Q_\phi(\mathbf s, \mathbf a) - V(\mathbf s))\)
本质上就是在最大化 ELBO, 我们把 \(q(\mathbf
a_t | \mathbf s_t)\) 改作 \(\pi(\mathbf
a_t | \mathbf s_t)\), 目标为 \[
J(\theta) = \sum_{t=1}^T \mathbb E_{(\mathbf s_t, \mathbf a_t) \sim
\pi_\theta(\mathbf s_t, \mathbf a_t)} [r(\mathbf s_t, \mathbf a_t) +
\mathcal H(\pi_\theta (\cdot|\mathbf s_t))]
\] 这种做法叫做 熵正则化策略梯度(entropy regularized
policy gradient)
显然我们更关心 \(\nabla_\theta
J(\theta)\), 可以类似 lec 5 的方法慢慢拆, 有 \[
\begin{aligned}
\nabla_\theta J(\theta)
&=\mathbb E_{\tau\sim\pi_\theta}
\left[\sum_t
\nabla_\theta\log\pi_\theta(\mathbf a_t | \mathbf s_t)
\bigl(G_t^{\mathrm{soft}}-b(\mathbf s_t)\bigr)
\right] \\
其中 \;G_t^{\mathrm{soft}}
&=\sum_{k=t}^{T}\left[
r(\mathbf s_k,\mathbf a_k)
-\log\pi_\theta(\mathbf a_k | \mathbf s_k)
\right] 代表从 \,t \,开始的 \text{ soft return}
\end{aligned}
\] 我们直接用 reward-to-go 和 baseline trick 了
如果用 \(\log \pi = Q-V\) 表达,
再把基线控制一下(减去动作无关的 \(V\)),
我们可以得到一个很像 Q-learning 的式子 \[
\nabla_\theta J(\theta)
\approx
\frac{1}{N} \sum_i \sum_t
(\nabla_\theta Q(\mathbf s_t,\mathbf a_t)
-\nabla_\theta V(\mathbf s_t))
(r(\mathbf s_t,\mathbf a_t)
+ Q(\mathbf s_{t+1},\mathbf a_{t+1})
- Q(\mathbf s_t,\mathbf a_t))
\] 而在 soft Q-learning 中, 我们要上升的值为 $$ - _i t
Q(s_t,a_t)
(r(s_t,a_t) + {a{t+1}} Q(s_{t+1},a_{t+1}) - Q(s_t,a_t) ) $$
在精确表示、充分优化等理想条件下, 两者对应同一个 max-entropy
最优控制目标
Policy gradient 更新的是动作概率, 只关心动作之间的相对 \(Q\) 值, 于是 \(\nabla Q-\nabla V\)
Q-learning 则要拟合 Bellman 目标给出的 \(Q\) 数值, 因此它的半梯度包含 \(\nabla Q\)
Q-learning 目标使用的是下一状态所有可能动作的 soft
最优价值, 不依赖数据中实际接着选了哪个动作,
使得从其他行为策略收集的转移也能用于更新 \(Q\), 这里的 soft max 可以称为 off-policy
correction
soft optimality 改善了探索, 防止了熵崩溃, 更容易针对更具体的任务微调, 更好的鲁棒性, 可以简单转变为 hard optimality, 可以较好模拟人类行为

Soft Q-learning 会同时探索两个相近的假设, 直到我们最终确定哪个更好为止

这种方法十分适合预训练, 我们可以学会以多种不同的方式完成任务, 当任务改变时就只要少量的 finetune 就可以重新适应了, 而 DDPG 有一个先忘记-后学习的过程
Soft Actor-Critic(SAC) 是一个 off-policy actor-critic 算法
在 Q-learning 方面简单加入 \(\log \pi\)
来考虑熵
在策略更新方面用 \(\pi_\theta\) 来近似
\(\pi^\star\) 让网络最小化 \(D_{\mathrm{KL}}(\pi_\theta(\cdot | \mathbf
s)\|\pi^*(\cdot | \mathbf s))\)

有一个 trick 是 Automatic temperature adjustment, SAC 很容易受到温度 \(\alpha\) 的影响, 随着训练的进行, 我们的 policy 的随机性应当随之下降, 因此有一个自动调整的方法
原来的策略希望 \[ \max_\pi\;\mathbb E_{a\sim\pi(\cdot|s)}\left[Q(s,a)-\alpha\log\pi(a|s)\right] \] 现在我们想让 \(\alpha\) 动一动, 不如把它写成拉格朗日乘子, 做 \[ \max_\pi\ \mathbb E\!\left[\sum_t r(s_t,a_t)\right], \qquad \text{s.t.}\;\mathcal H(\pi(\cdot|s_t))\geq\mathcal H_0 \] 这里的 \(\mathcal H_0\) 叫做策略熵, 一般 \(\mathcal H_0=-\dim(\mathcal A)\), 有总流程

\(J_Q(\theta)\) 是最小化 bellman
误差出来的, 大概长 \(\mathbb E[\frac{1}{2}(Q -
(r+\gamma \mathbb EV))^2]\) 这样
\(J_\pi(\phi)\) 的目标是最大化 Q-value
与 entropy 的和, 即最小化 \(\mathbb E_{\mathbf
s} \mathbb E_{\mathbf a}[\alpha \log \pi- Q]\) 这种东西,
可以重参数化 \(\mathbf a\) 使得梯度传入
\(Q\)
这里 \(J(\alpha) =\alpha\bigl(\mathcal
H(\pi)-\mathcal H_0\bigr)\), 它也是倒着 DP 出来的, 推导见 Policy
Gradient Algorithms | Lil'Log
在具体实现上, SAC 结合了 DDQN 与 target network,
你看这玩意一共有四个模型 \(\theta_1, \theta_2,
\bar \theta_1, \bar \theta_2\)
最近(2026.9.28)知乎上看到篇文章, 强化学习(RL) Pass@K 优化 & LLM探索, 感觉和 max-entropy 很像啊

LLM 经过预训练后, 其策略分布已经非常 "尖锐"(peaked), 即对某些输出有极强的偏好。当从这样一个尖锐的分布开始进行强化学习时, 模型会很难摆脱初始策略分布的"引力"。换言之, 如果全局最优解不在初始策略的邻近区域, 而初始策略本身已是一个局部最优解, 那么强化学习过程可能只会让模型在现有策略上做进一步的压缩, 使得策略分布变得更加尖锐。
上述问题的根源在于, 标准 RL 的优化目标是最大化奖励的均值。然而, 这种只关注平均表现的目标, 正是导致 Pass@K 性能下降的原因。要解决这个问题, 我们只需要将优化目标从单纯的 "均值" 转向 "平滑的最大值" 就行。在强化学习领域, 这种超越均值的优化范式被称为 风险敏感型强化学习(risk-sensitive RL)
人家这叫做 risk-sensitive, 目标为 \[
J_{\rm RS}(\pi)=\frac1\beta\log\mathbb E_{y\sim\pi} \left[e^{\beta
r(y)}\right],\qquad \beta>0
\] \(\beta\) 增大时,
少数高奖励样本对更新的影响变大, 而 max-entropy 的目标为 \[
J_{\rm ME}(\pi)=\mathbb E_{y\sim\pi}[r(y)]+\alpha\mathcal H(\pi)
\] 给我的感觉就是 soft max 啥都能干,
我可以拿它改变不同奖励样本的权重, 可以提升策略的随机性
对于固定的当前策略 \(\pi\), 有 \[
\frac1\beta\log\mathbb E_{y\sim\pi}e^{\beta r(y)}=
\max_q\left\{\mathbb E_{y\sim q}r(y)-\frac1\beta D_{\rm
KL}(q\|\pi)\right\}
\] 最优的辅助分布 \(q^*(y)\propto\pi(y)e^{\beta r(y)}\), 然后
\(\nabla_\theta J_{\rm RS} =\frac1\beta\mathbb
E_{y\sim q^*_\theta} [\nabla_\theta\log\pi_\theta(y)]\)
这很像熵正则化, 但 KL 的参照分布是当前策略 \(\pi\), 不是固定的均匀分布, 若
\(\pi\) 是 \(n\)
个动作上的固定均匀分布, 则 \(D_{\rm KL}(q\|\pi)=\log n-\mathcal
H(q)\)
下面两个式子是等价的, \(q\) 把 \(\log\mathbb E_\pi e^{\beta r}\)
隐含的高奖励加权, 显式表示成一个辅助分布 \[
\nabla_\theta J_{\rm RS}
=\mathbb E_{\pi_\theta}
\left[\underbrace{\frac1\beta
\left(\frac{e^{\beta r(y)}}{Z_\theta}-1\right)}_{A_\beta(y)}
\nabla_\theta\log\pi_\theta(y)
\right] \\
\nabla_\theta J_{\rm RS}
=\frac1\beta\mathbb E_{y\sim q^*}
[\nabla_\theta\log\pi_\theta(y)]
\] 之前说 \(Q = r + \log \mathbb E \exp
V\) 有问题, 那么 risk-sensitive 就没问题吗?
答案是有, 但不完全有问题, 如果把 \(\beta\) 看成风险偏好(所谓 risk-sensitive),
那么模型的确会在高 \(\beta\)
时买彩票
但是我们没有改变 dynamic, 优化 \(\frac1\beta\log\mathbb E_{\tau\sim P_\pi}e^{\beta
R(\tau)}\) 时的期望仍是按真实轨迹分布 \(P_\pi\) 计算的
Lecture 20 Inverse RL
对于难以手动指定奖励函数的任务, 如果能够获取专家成功执行该任务的数据,
能否通过观察他们的行为来推理出他们的奖励函数并学习?
Inverse RL 学习奖励函数, 而不是从已知的奖励中学习一个策略
Lec 19 学到, 一个 "Soft" 的最优控制模型可以很好的解释人类行为
Lec 2 学到, 模仿学习复制的是专家动作, 而不是专家目的, reward 可能是比 \(\mathbf a_t = \pi^\star(\mathbf s_t)\) 更本质的东西
对于 Atari Game, reward 十分明显, 游戏的目标是得到更高的评分
对于自动驾驶领域, 要平衡的东西就很多了, 要快, 要稳,
不能违反交通法规等等
Inverse RL 是一个欠定问题, 对于同样的行为,
有无数不同的 reward function 可以解释
它其实是模仿学习某种意义上的超集, 我们可以定义 "只要 action 不在 expert
的 action 中, 就是 \(- \infty\)
的奖励", 但这不是我们想要的专家目的
我们正式定义 Inverse RL 如下

首先还是 states space 和 action space
我们得到了最优策略 \(\pi^\star\)
采样过的 \(\{ \tau_i \}\),
目标是学习奖励函数 \(r_\psi(\mathbf s, \mathbf
a)\)
先考虑 linear reward function, 有 \(r_\phi(\mathbf s, \mathbf a) = \sum_i \psi_i
f_i(\mathbf s, \mathbf a) = \psi^\top \mathbf f(\mathbf s, \mathbf
a)\)
这里的思想是特征匹配(feature matching), \(\mathbf f\) 是我们的特征函数
我们希望 \(\mathbb E_{\pi^{r_\psi}} [\mathbf
f(\mathbf s, \mathbf a)] = \mathbb E_{\pi^\star} [\mathbf f(\mathbf s,
\mathbf a)]\), 这里的 \(\pi^{r_\psi}\) 是 \(r_\psi\) 下的最优策略, 我们希望 \(r_\psi\) 指导下的 policy 与 \(\pi^\star\) 产生的 state-action pair
在期望下有一样的特征
可以这么理解, 专家最大化期望累计奖励, 我们可以保证: 专家已经达到了 \(r_\psi\) 下的最优回报, 如果能学到 \(\pi^{r_\psi}\)( 特征期望相同), 它是 \(r_\psi\) 下的最优策略, 我们找到了使专家行为可以被解释为最优行为的奖励
这里的欠定性来自于特征期望的来源不唯一(不同的 \(\psi\) 可以有相同的期望),
带有歧义(ambiguity)
我们可以人工定序, 有最高指示, 特征一定要特别!直觉是,
专家的最优性一定是最最好的
我们希望最大化 reward function 下, 其他 policy 和 expert policy
之间的最小回报差距, 所谓 margin 是也 \[
\max_{\psi, m}\;m \quad s.t. \;\psi^\top \mathbb E_{\pi^\star}[\mathbf
f(\mathbf s, \mathbf a)]
\geq \max_{\pi \in \Pi} \psi^\top \mathbb E_{\pi} [\mathbf f(\mathbf s,
\mathbf a)] + m
\] 细看感觉很不对劲啊, \(\Pi\)
是不是太大了一点, 我在 \(\Pi\)
中要是取到了 \(\pi^\star\)
该怎么办?如果 \(\pi\) 和 \(\pi^\star\) 很像怎么办?
先可以用拉格朗日对偶改写式子,
最大化间隔就是最小化固定间隔下的范数(间隔可以比例放大), 有 \[
\min_{\psi}\frac{1}{2} \| \psi \|^2 \quad s.t. \;\psi^\top \mathbb
E_{\pi^\star}[\mathbf f(\mathbf s, \mathbf a)]
\geq \max_{\pi \in \Pi} \psi^\top \mathbb E_{\pi} [\mathbf f(\mathbf s,
\mathbf a)] + 1
\] 这里如果 \(\pi\) 和 \(\pi^\star\) 很像会导致无解, 我们可以换成
\[
\min_{\psi}\frac{1}{2} \| \psi \|^2 \quad s.t. \;\psi^\top \mathbb
E_{\pi^\star}[\mathbf f(\mathbf s, \mathbf a)]
\geq \max_{\pi \in \Pi} \psi^\top \mathbb E_{\pi} [\mathbf f(\mathbf s,
\mathbf a)] + D(\pi, \pi^\star)
\] \(D(\pi, \pi^\star)\)
代表某种分布之间的差异函数
它部分解决了无解的问题, 现在允许竞争策略接近专家了, 我们可以得到
"在候选集合 \(\Pi\)
中专家的回报不低于任何策略且尽可能领先的最小范数权重的奖励函数 \(r_\psi\)", 限定词有点多
这种做法还有很多问题没解决, 我们启发式假设了专家最优,
但真实世界人类动作有随机性, 这部分解释不了, 不,
即使在凸优化上动手脚加松弛变量也不好解释
这种方式也只适合 linear 的情况, 如何兼容深度学习呢?
在 Lec 19 中 probabilistic graphical model 中的 optimality variable \(\mathcal O_t\) 终于派上了用场
我们有结论, \(p(\tau | \mathcal O_{1:T},
\psi) \propto p(\tau) \exp \left( \displaystyle\sum_t r_{\psi}(\mathbf
s_t, \mathbf a_t) \right)\), 当得到采样出来的 \(\{ \tau_i \}\) 后, 做最大似然学习, 也就是
\[
\max_\psi \dfrac{1}{N} \sum_{i=1}^N \log p(\tau_i| \mathcal O_{1:T},
\psi ) =
\max_\psi \dfrac{1}{N} \sum_{i=1}^N r_\psi(\tau_i) - \log Z(\psi)
\] 其中 \(Z(\psi) = \displaystyle\int
p(\tau) \exp(r_\psi(\tau)) \rm d\tau\), 被称作 partition
function(配分函数)
解释一下式子, 首先, \(p(\tau)\) 与
\(\psi\) 无关, 被我们扬掉了; 然后,
Bayes' rule 告诉我们, \(p(\tau\mid\mathcal
O,\psi) = \dfrac{p(\mathcal O\mid\tau,\psi)\,p(\tau)} {p(\mathcal
O\mid\psi)}\), 其中 \(p(\mathcal
O|\psi) = Z(\psi)\), 推导方法是把 \(\tau\) 拆出来积分; 最后, 直觉上来讲,
我们不仅仅提高专家轨迹的奖励, 而是用 \(Z\) 提高专家轨迹相对于其他轨迹的概率
如果使用梯度下降来优化这个目标函数, \(\rm d
\tau\) 是非常难处理的, 我们可以得到 \[
\nabla_\psi\mathcal L
= \frac1N\sum_{i=1}^{N}\nabla_\psi r_\psi(\tau_i)
-\frac1Z \int p(\tau)\exp\bigl(r_\psi(\tau)\bigr) \nabla_\psi
r_\psi(\tau)\,\mathrm d\tau
\] 不过 \(\dfrac{1}{Z}
\displaystyle\int p(\tau)\exp\bigl(r_\psi(\tau)\bigr)\) 其实就是
\(p(\tau | \mathcal O_{1:T}, \psi)\)
的展开式, 于是 \[
\nabla_\psi\mathcal L
=\underbrace{\mathbb E_{\tau\sim\pi^\star(\tau)}
[\nabla_\psi r_\psi(\tau)]}_{\text{使用专家样本估计}}
-\underbrace{\mathbb E_{\tau\sim p(\tau\mid \mathcal O_{1:T},\psi)}
[\nabla_\psi r_\psi(\tau)]}_{\text{当前奖励下的软最优策略对应的期望}}
\]
梯度其实就是专家策略下的梯度期望值与当前奖励下的梯度期望值之差,
具体的估计要用到 Lec 19 的推导, 有 \[
\begin{aligned}
\nabla_\psi\mathcal L
&=\mathbb E_{\tau\sim\pi^\star(\tau)}[\nabla_\psi r_\psi(\tau)]
-\mathbb E_{\tau\sim p(\tau\mid \mathcal O_{1:T},\psi)}[\nabla_\psi
r_\psi(\tau)] \\
&=\mathbb E_{\tau\sim\pi^\star(\tau)}[\nabla_\psi r_\psi(\tau)]
- \sum_{t=1}^{T}
\mathbb E_{(\mathbf s_t,\mathbf a_t)\sim
p(\mathbf s_t,\mathbf a_t\mid \mathcal O_{1:T},\psi)}
\left[\nabla_\psi r_\psi(\mathbf s_t,\mathbf a_t)\right]
\end{aligned}
\] 由于 \(p(\mathbf s_t,\mathbf a_t\mid
\mathcal O_{1:T},\psi) = p(\mathbf a_t\mid\mathbf s_t,\mathcal
O_{1:T},\psi) p(\mathbf s_t\mid\mathcal O_{1:T},\psi)\)
其中 \(p(\mathbf a_t | \mathbf s_t,\mathcal
O_{1:T},\psi) =\dfrac{\beta(\mathbf s_t,\mathbf a_t)}{\beta(\mathbf
s_t)},\; p(\mathbf s_t | \mathcal O_{1:T},\psi)\propto\alpha(\mathbf
s_t)\beta(\mathbf s_t)\),
于是有 \(p(\mathbf a_t | \mathbf s_t,\mathcal
O_{1:T},\psi)p(\mathbf s_t | \mathcal O_{1:T},\psi)\propto \beta(\mathbf
s_t, \mathbf a_t)\alpha(\mathbf s_t)\), 我们令 \(\mu_t(\mathbf s_t, \mathbf a_t) \propto
\beta(\mathbf s_t, \mathbf a_t)\alpha(\mathbf s_t)\)
接下来在所有 state 和 action 下归一化, 有 \[
\begin{aligned}
\mathbb E_{\tau\sim p(\tau\mid \mathcal O_{1:T},\psi)}[\nabla_\psi
r_\psi(\tau)]
&= \sum_{t=1}^{T}\iint
\mu_t(\mathbf s_t,\mathbf a_t)
\nabla_\psi r_\psi(\mathbf s_t,\mathbf a_t)
\,\mathrm d\mathbf s_t\,\mathrm d\mathbf a_t \\
&= \sum_{t=1}^{T}\vec\mu_t^{\,\top}\nabla_\psi\vec r_\psi
\quad(离散状态与动作的表示下)
\end{aligned}
\] 以上算法叫做 MaxEnt
IRL(最大熵逆强化学习), 是 AAAI 2008 提出的老东西了

双重积分可以用样本平均做, 当循环收敛时,
可以生成最能解释专家潜在次优行为的奖励
主要适用于规模较小的离散状态—动作空间
在奖励为 \(\psi\) 的线性函数的情况下, 我们可以证明这个算法取的是 \(\max_\psi \mathcal H(\pi^{r_\psi})\;s.t. \mathbb E_{\pi^{r_\psi}} [\mathbf f] = \mathbb E_{\pi^\star} [\mathbf f]\), 这也是一种消除歧义(ambiguity)的方法, 最大熵要求奖励函数不做任何额外假设(奥卡姆剃刀?)
如何扩展到更高维情况?我要是不知道 dynamic 呢?我们已知的有 \[
\nabla_\psi\mathcal L
=\underbrace{\mathbb E_{\tau\sim\pi^\star(\tau)}
[\nabla_\psi r_\psi(\tau)]}_{\text{使用专家样本估计}}
-\underbrace{\mathbb E_{\tau\sim p(\tau\mid \mathcal O_{1:T},\psi)}
[\nabla_\psi r_\psi(\tau)]}_{\text{当前奖励下的软最优策略对应的期望}}
\] 这里的难度来自于第二项的估计,
一个想法是, 我们可以对于用 RL 方法(eg. SAC)去学习 \(\psi\) 下的 \(p(\mathbf a_t | \mathbf s_t,\mathcal
O_{1:T},\psi)\), 学完之后运行策略来采样轨迹, 有 \[
\nabla_\psi\mathcal L
= \frac{1}{N} \sum_{i=1}^N \nabla_\psi r_\psi(\tau_i)
- \frac{1}{M} \sum_{j=1}^M \nabla_\psi r_\psi(\tau_j)
\] 听起来就复杂度爆炸, 每个 step 学习一个 policy 直至收敛
如果不是学习全新 policy 呢?如果每个 step
我们改善 policy 呢?有没有类似 importance sampling
的做法? \[
\nabla_\psi\mathcal L
= \frac{1}{N} \sum_{i=1}^N \nabla_\psi r_\psi(\tau_i)
- \frac{1}{\sum_j w_j} \sum_{j=1}^M w_j \nabla_\psi r_\psi(\tau_j)
\] 引入重要性权重 \(w_j\)
来纠正当前 \(\psi\) 下的策略,
假设旧策略是 \(\pi\), 有 \[
\begin{aligned}
w_j &= \frac{p(\tau) \exp(r_\psi(\tau_j))}{C \pi(\tau_j)} \\
&= \frac{p(\mathbf s_1) \prod_t p(\mathbf s_{t+1}|\mathbf s_t,
\mathbf a_t) \exp(r_\psi(\mathbf s_t, \mathbf a_t))}{C p(\mathbf s_1)
\prod_t p(\mathbf s_{t+1}|\mathbf s_t, \mathbf a_t) \pi(\mathbf a_t |
\mathbf s_t)} \\
&= \frac{\exp(\sum_t r_\psi(\mathbf s_t, \mathbf a_t))}{C \prod_t
\pi(\mathbf a_t | \mathbf s_t)}
\end{aligned}
\] 这是 Guided Cost
Learning(GCL) 的思想, 最后 reward 和 policy 都一起学出来了


如果我们一边通过最大化 reward 差的方式来学 \(\psi\), 一边通过使得 \(\psi\) 更难区分 \(\pi_\theta\) 与 \(\pi^\star\) 的方式来学 policy, 那这不就是 GAN 的思想吗?

在 GAN 中, discriminator(判别器) \(D_\psi =
p_\psi (\text {real} | \mathbf x)\) 试图区分生成的数据与真实数据,
有 \[
\psi = \arg \max_\psi \frac{1}{N} \sum_{\mathbf x \sim p^\star} \log
D_\psi(\mathbf x) + \frac{1}{M} \sum_{\mathbf x \sim p_\theta} \log
(1-D_\psi(\mathbf x))
\] 其中 \(p^\star\) 是真实数据,
\(p_\theta\) 是生成器
我们可以证明 GAN 收敛时有 \(D^\star(\mathbf x)
= \dfrac{p^\star(\mathbf x)}{p_\theta(\mathbf x) + p^\star(\mathbf
x)}\), 即当生成器固定时, 最优判别器认为样本 \(\mathbf x\) 来自真实数据的概率; 当整个 GAN
达到理想均衡时, \(p_\theta = p^\star,
D^\star(\mathbf x) = 0.5\)
在 Inverse RL 中, 收敛时, \(p_\theta(\tau) = p(\tau) \exp (r_\psi(\tau))/Z\), 于是可以参数化 discriminator 为 \[ \begin{aligned} D_\psi(\tau) &= \frac{p(\tau) \frac{1}{Z}\exp (r(\tau))}{p_\theta(\tau)+ p(\tau) \frac{1}{Z}\exp (r(\tau))} \\ &= \frac{p(\tau) \frac{1}{Z}\exp (r(\tau))}{p(\tau)\prod_t \pi_\theta(\mathbf a_t|\mathbf s_t)+ p(\tau) \frac{1}{Z}\exp (r(\tau))} \\ &= \frac{\frac{1}{Z}\exp (r(\tau))}{\prod_t \pi_\theta(\mathbf a_t|\mathbf s_t)+ \frac{1}{Z}\exp (r(\tau))} \end{aligned} \] 我们得到 \(\psi\) 的方式可以写作 \[ \psi = \arg \max_\psi \mathbb E_{\tau \sim p^\star(\tau)} [\log D_\psi(\tau)] + \mathbb E_{\tau \sim \pi_\theta} [\log (1-D_\psi(\tau))] \] importance sampling 会成为 \(Z\) 的一部分, 这里的 \(Z\) 可以通过优化得到

以上就是 Inverse RL as GAN 的思想
我们可以通过实验看到 Inverse RL 不是模仿动作而是模仿意图

这里的例子是, 如果我们从四足蜘蛛行走中学习了 reward function,
将其应用在双足行走的蜘蛛上, 它仍然能够学会往正确的方向走
Inverse RL 将 reward 与 dynamic 解耦了, 防止了模仿学习的一锅炖
如果我们最终的目标还是学习 policy, 那么在 Inverse RL as GAN 中也可以用简单的二元分类器作为 discriminator, 不过这可能叫做 Generative Adversarial Imitation Learning(GAIL), 有一定的 trade-off
Lecture 21 RL in Seq
好像之前已经介绍了一些 RL + sequence 的东西了, 我们需要 sequence, 并且近些年来, 我们越来越需要它
随着 state space 的扩大, RL 问题逐渐从 MDP 变成了 POMDP; MDP 问题, 例如 Atari Game, 过去的状态与未来的状态是独立的, 但是 POMDP 不满足这个性质, 当前的观测 \(\mathbf o_t\) 不足以推出全局的状态 \(\mathbf s_t\), 这也代表着之前的观测还能提供更多的信息, 例如自动驾驶情景或者游玩 3D 游戏(你看不见背后)
POMDP 是复杂奇怪的
一是 information-gathering actions,
做一些不会直接带来更高回报的动作在全局上可能是更有益的, 例如,
如果你在第一人称游玩迷宫,
最理想的操作(尽管一般不可能实现)就是爬到迷宫顶部看一眼出口在哪里,
这是对全局有益的信息收集行动

二是 stochastic optimal policies, 我们可以证明 POMDP 不总是存在最优的确定性策略, 在 POMDP 中, 可能随机性策略才是最优的
之前我们学的哪些 RL 算法能够处理 POMDP?哪些 RL 算法在 \(\mathbf s \to \mathbf o\) 下依然有效?

我们主要研究 Policy Gradient, Value-based methods 与 Model-based RL 在 \(\mathbf o \to \mathbf s\) 下是否有效(这差不多也覆盖所有 RL 算法类型了……), 在进行更换后, 我们会训练得到 \(\pi_\theta(\mathbf a|\mathbf o)\), 我们希望得到的策略是在当前观测下的最佳策略
对于 policy gradient 方法, \(\nabla_\theta
J(\theta) \approx \dfrac{1}{N} \sum_{i=1}^N \sum_{t=1}^T \nabla_\theta
\log \pi_\theta(\mathbf a_{i,t}|\mathbf o_{i,t}) A(\mathbf o_{i,t},
\mathbf a_{i,t})\) 是 "基本无害(Mostly Harmless)" 的,
因为回想一下整个 \(\nabla_\theta
J(\theta)\) 的推导过程, 我们没有用上 MDP 性质
至于为什么是 "基本无害(Mostly Harmless)" 而不是完全无害, 则因为 \(A(\mathbf o_{i,t}, \mathbf a_{i,t})\)
上可能整的花活太多了
优势函数 \(A\) 不一定是 \(\mathbf o\) 的函数,
因为不同的过去可能导致同一个 \(\mathbf
o\) 对应于不同的 value, 我们最好不要用 TD 方法(eg. \(A \approx r + V(\mathbf o_{t+1}) - V(\mathbf
o_t)\)), 传统的蒙特卡洛方法是可以的, 再加一点 reward-to-go 与
baseline 的 trick 也是可以的 ( •̀ ω •́ )
对于 Value-based Method, \(Q(\mathbf o, \mathbf a) \leftarrow r(\mathbf o, \mathbf a) + \gamma \max_{\mathbf a'} Q(\mathbf o', \mathbf a')\) 是不行的, 还是因为不同的过去可能导致同一个 \(\mathbf o\) 对应于不同的 value
对于 Model-based RL, 学习 \(\hat p(\mathbf o' | \mathbf o, \mathbf a)\) 也是不行的, 如果没有记忆, 假设我们的设定为 "从随机一扇门上锁的左右两扇门中选出未上锁的门打开", 我们最终会学到这样一个 model, 为 \[ \hat p(\mathbf o' = \text{Pass}| \mathbf o = \text{Left}, \mathbf a = \text{Open}) = 0.5 \\ \hat p(\mathbf o' = \text{Pass}| \mathbf o = \text{Right}, \mathbf a = \text{Open}) = 0.5 \] 马尔可夫模型在这里无力, 如果你打不开门, 这代表它是上锁的, 而不是走了 50% 的霉运, 在这样的 model 下训练出来的 policy 可能无限次尝试打开上锁的门, 因为它认为每次开门都有 50% 的概率成功
不过, 不要太悲观, 这些都是 memory-less 的情况, 所以我们才需要
sequence, 我们需要 observation history
在 Lec 18 学过了 State space models,
其本质是基于观测历史来学习一个马尔科夫空间,
其中这里改了个名叫做随机潜变量 \(\mathbf
z\), 我们训练 VAE 那套东西
\(Q(\mathbf z, \mathbf a) \leftarrow r(\mathbf z, \mathbf a) + \gamma \max_{\mathbf a'} Q(\mathbf z', \mathbf a')\) 是可行的, 它可能不够好, 我们训练 VAE 的过程中有 \(p_\theta(\mathbf o|\mathbf z)\) 这个 decoder, 它不一定是必要的, 而且可能比 RL 问题本身更加困难(生成图像像素可能难于恢复最优策略), 也许应该走 JEPA 的路子, 例如 IWM
另一个想法更简单, 不要中间 \(\mathbf z\) 赚差价, 直接定义 \(\mathbf s_t = (\mathbf o_1, \mathbf o_2, \dots, \mathbf o_t)\) 就行了, 这是符合 MDP 性质的, 因为 \(\mathbf s_t\) 包含 \(\mathbf s_{t-1}\) 的所有信息, 所以它们互相独立, 可以做 \(Q(\mathbf o_1,, \dots, \mathbf o_t, \mathbf a) \leftarrow r(\mathbf o_t, \mathbf a) + \gamma \max_{\mathbf a'} Q(\mathbf o_1, \dots, \mathbf o_{t+1}, \mathbf a')\)
这坨式子需要有全新的模型架构, 如果钦定历史长度固定, 那么把观测(eg.
Atari Game 图片) stack 一下扔进 Q 函数就已经是不错的选择了
一般来说, 还是要 RNN/LSTM/Transformer 这样的 sequence model 的,
我不会说哪个更好, 因为前沿论文哪个都有用, 感觉这是很 heuristic
的工程问题
工程上的另一个问题是你的 replay buffer 可能撑不住 \(\mathbf s_t = (\mathbf o_1, \mathbf o_2, \dots, \mathbf o_t)\) 的 stacking, 它是随着 horizon 平方增长的, 一般还是要转一层 hidden state, 这里命名为 \(\mathbf h\), \(\mathbf h_t=f_\theta(\mathbf h_{t-1},\mathbf o_t)\), 是 RNN/LSTM 对历史的确定性编码, 把这个东西存进 replay buffer 就行了
对于 Transformer, 新 token 的表示通常需要关注之前各个 token 的 key/value,
\(\operatorname{Attention}(q_t,K_{\le t},V_{\le t})\) 来得到下一步, 所以 replay buffer 只存 \(\mathbf h\) 不行, 存 KV cache 又太大了
做法一般是 trade-off, 要不取有限观测历史, 要不用少量 memory tokens 压缩历史, 主要还是在重算成本、缓存一致性和记忆压缩之间做取舍gpt 推了篇文章 RATE, 虽然它先在 ICLR 2025 因为没有比较 CQL+LSTM 被拒, 又在 NeurIPS 2025 因为俄罗斯作者被拒, 但是中了 ICLR 2026 的 Poster
RATE 是做 Offline RL 的, 比 DT 更好, Transformer 上下文太小, RNN step 太短, RATE 一段一段来, 也许有点用?sequence Memory 领域有很多花活架构, 我了解不多
热门中的热门, 所有 CS 同学的幻想与向往, 谈到 RL + Seq, 自然是
LLM!
在这个方向上, 2023 年的课程老的如同是上世纪挖出来的一般, 所有 CS
学生见面彼此畅谈 GRPO(Deepseek-R1)/DAPO(Qwen-2.5)/GSPO(Qwen-3)/SAPO(Qwen3-VL)/etc., 哇塞,
Qwen 确实很厉害, 文章三个月一发, Loss function 越来越长,
越来越复杂了
额额, 好像有点跑题, 我们主要关心 RL + language model 的一些底层概念, 不是来关心 Super-advanced Policy Optimization 的
Language Model 就是一个预测 next token 的模型

Language Model 乍一看和 RL 没啥关系, 它不满足 MDP,
通过监督学习训练
RL 的用处在于希望 LLM 不仅仅匹配训练数据, 而是最大化某种 reward
时的训练
那么, 站在 RL 的角度, 我们会问, (PO)MDP 是什么?reward
怎么设置?使用什么 RL 算法?
我们询问 LLM 一个问题, 上下文为 \(\mathbf
s\), LLM 的回答是 \(\mathbf a\),
它们都能被拆成更简单的 token sequence \(x\)
对于我们的 RL, 整个 \(\mathbf a\)
被看作一个 time step, RL 目标还是 \(\max
\mathbb E_{\pi_\theta(\mathbf a|\mathbf s)}[r(\mathbf s, \mathbf
a)]\), 对于 LLM 则是多个 step
我们做 policy gradient, 假设 \(\nabla_\theta \log \pi_\theta(\mathbf {a}\mid\mathbf {s})=\nabla_\theta \log p(x_5\mid x_{1:4})+\nabla_\theta \log p(x_6\mid x_{1:4},x_5)\), 代表 LLM 对四个 token 的询问做出了两个 token 的回答, 有 \[ \begin{aligned} \nabla_\theta E_{\pi_\theta(\mathbf {a}\mid\mathbf {s})} \left[r(\mathbf {s},\mathbf {a})\right] &= E_{\pi_\theta(\mathbf {a}\mid\mathbf {s})} \left[\nabla_\theta \log \pi_\theta(\mathbf {a}\mid\mathbf {s})r(\mathbf {s},\mathbf {a})\right] \\ &\approx \frac{1}{N}\sum_i \nabla_\theta \log \pi_\theta(\mathbf {a}_i\mid\mathbf {s}) r(\mathbf {s},\mathbf {a}_i), 其中\;\mathbf {a}_i\sim\pi_\theta(\mathbf {a}\mid\mathbf {s})\quad\text{REINFORCE} \\ &\approx \frac{1}{N}\sum_i \frac{\pi_\theta(\mathbf {a}_i\mid\mathbf {s})} {\bar{\pi}(\mathbf {a}_i\mid\mathbf {s})} \nabla_\theta \log \pi_\theta(\mathbf {a}_i\mid\mathbf {s}) r(\mathbf {s},\mathbf {a}_i), 其中\;\mathbf {a}_i\sim\bar{\pi}(\mathbf {a}\mid\mathbf {s})\quad\text{PPO-like} \end{aligned} \] 我们喜欢用 PPO-like 的估计, 因为采样太耗时了, 评估奖励也很贵, 于是有了一个简单算法

reward 是什么?它如何为所有可能的 LLM 结果打分?当我们询问一个问题时, 答案不仅有对错之分, 还有各种语气/简洁度等等的打分

我们可能要先从监督学习中学习 reward model, 需要很多人来标注, 不过主观的得分分配因人而异也不准确, 这里的做法是利用人类偏好, 人类无法精确给出 "A 满分, B 蛋分" 这样的评价, 但是人类可以给出 "A 比 B 好" 这样的偏好
从偏好到数值, 可以利用 IRL 的思想, 如果在问题 \(\mathbf s\) 下人类更偏好 \(\mathbf a_1\) 而不是 \(\mathbf a_2\) 解答, 可以建模为 \[ \begin{aligned} p(\mathbf a_1 \succ \mathbf a_2 | \mathbf s) &= \frac{\exp(r_\psi(\mathbf s, \mathbf a_1))}{\exp(r_\psi(\mathbf s, \mathbf a_1)) + \exp(r_\psi(\mathbf s, \mathbf a_2))} \\ &= \sigma(r_\psi(\mathbf s, \mathbf a_1) - r_\psi(\mathbf s, \mathbf a_2)) \quad 其中\; \sigma(x) = \frac{1}{1+e^{-x}} \end{aligned} \] 然后做最大似然学习来训练奖励模型, 总流程为

这个 Step 5 的展开可以见上文
进一步的问题在于人类标注偏好的昂贵, 需要经常的 label, 不然会变成 Offline RL 然后 overestimate
现在可以理解在 Lec 9 中 DPO 的做法了, 那时候的 loss 为 \[
L^{\text{DPO}} (\theta)= E_{(x,y_w,y_l) \sim \mathcal D}\left[ -\log
\sigma \left( \beta \log
\frac{\pi_\theta(y_w|x)}{\pi_{\text{ref}}(y_w|x)} - \beta
\log\frac{\pi_\theta(y_l|x)}{\pi_{\text{ref}}(y_l|x)} \right) \right]
\] 这是哪来的?policy gradient + KL 散度乘法构造 \(J\), 然后使用类似 Lec 16 的方法求对偶问题,
能得到 policy \[
\pi^*(\mathbf a\mid \mathbf s)
=\frac{1}{Z(\mathbf s)}\pi_{\mathrm{ref}}(\mathbf a\mid \mathbf
s)e^{r(\mathbf s,\mathbf a)/\beta}
\] \(\beta\)
控制偏离参考模型的代价, 我们知道了 policy 与 reward 的关系, 反过来用
policy 表达 reward, 有 \[
r(\mathbf s,\mathbf a)=
\beta\log\frac{\pi^*(\mathbf a\mid \mathbf
s)}{\pi_{\mathrm{ref}}(\mathbf a\mid \mathbf s)}+\beta\log Z(\mathbf s)
\] 可理解为每一个 policy 隐含了一个 latent 的 reward
function
一个回答相对参考模型被最优策略提高了多少概率, 就对应它的奖励有多高
我们还是希望 latent reward function 能够最大化 preference 数据的似然,
带入偏好模型得到上面的 loss
DPO 直接优化 policy 而不是 reward function, 就不用训练 reward model
了
\(\mathbf a_1\succ \mathbf a_2\) 本身丢失了很多信息, 如果能打分可能更好, 例如 GRPO 组内打分, 但我们就此打住
刚刚是一个简化的 one-step RL, 如果是 multi-step RL 怎么办?reward 针对整段对话结果设置, 如何训练呢?
stack 一下, \(\mathbf s = \{ \mathbf o_1,
\mathbf a_1, \mathbf o_2, \dots \}\), 直接训 policy gradient
当然可以……吗?
通常情况下我们无法像 RLHF 那样简单地通过 preference 训练一个 reward
model, 涉及到多步决策的问题, 我们无法简单地对单步进行一个评价,
人类时刻进行标注又太昂贵了
Value-based methods 是 off-policy 的, 我们可以先做 Offline RL 啊, 这互联网可能到处都是数据
这里的 time-step 如何设置?有两种方式比较自然
一是 per-utterance, 每一个提问是 observation, 每一个回答是 action,
垒在一起是 state; 短 horizon, 巨大 action space
二是 per-token, 每一个 token 视作单个 time step, 可能有点奇怪,
序列变成了 \(\{ \mathbf a_1, \dots \mathbf
a_5, \mathbf o_1, \dots, \mathbf o_4\}\) 这样, action space
变小了, 但是 horizon 变得特别长

对于 value-based RL with per-utterance time step, 我们要学习一个 \(Q(\mathbf s, \mathbf a)\)

其中 \(\mathbf s\) 是之前所有对话的
stack, 然后有 candidate action \(\mathbf
a\), 这个 \(\mathbf a\)
的生成有一些选择
一是单独使用一个 actor 网络, 并且将 \(Q\) 的输出作为一个类似于单步 RL 的 reward
来训练 actor
二是解码出使得 Q value 最大化的 action, 这里需要一些 beam search
或采样的方法
图中的 Transformer sequence model 是两个/单个预训练的 LM, 把 \(\mathbf s, \mathbf a\) 编码为 hidden state,
然后做类似 \(Q_\phi(\mathbf s, \mathbf a) =
\text{MLP}_\phi([h_{\mathbf s}; h_{\mathbf a}])\) 这样的东西,
其中 \(h_{\mathbf s} = f_\phi(\mathbf s),
h_{\mathbf a} = g_\phi(\mathbf a)\)
我的理解是 one-step RL 换个头就可以编码语言 hidden state 了, 训出来 Q
函数就是 multi-step 了
对于 value-based RL with per-token time step, 更新方式还是 \(Q(\mathbf s, \mathbf a) = r(\mathbf s, \mathbf a)
+ \gamma \max_{\mathbf a'}Q(\mathbf s', \mathbf
a')\)
如果下一个 token 是 agent 选择的, 那么就选择其中最大的一个, 并添加上
reward, 作为当前的 Q value 的 target
如果下一个 token 是环境给出的, 直接选择 dataset token 对应的 Q value,
并添加上 reward, 作为当前的 Q value 的 target
之前学过的所有东西, 例如 Double-Q, Target Network, CQL, IQL, KL constraint, GAE, 都可以用在这里
我们没有深入 SFT, RLHF, 也没有介绍 Verifier reward 或 Process reward, CS285 26fall Lec14 会讲得丰富一点
Lecture 22 迁移学习与元学习
Transfer learning 与 Meta learning,
一个用来 transfer, 把已有任务中学到的知识用于新任务,
提高学习速度或最终性能
另一个用来 learn how to learn, 在多个任务上学习如何学习,
使模型能用少量新经验快速适应新任务
从 Transfer learning 开始
还是以 Atari game 举例子, 为什么人类擅长玩冒险解密游戏, 而 Q-learning
连第一关都过不去?
答案是无耻的人类有太多先验了, 人类认识钥匙, 认识门, 还知道钥匙能开门,
人类知道自己在玩一个冒险游戏, 大概率不会靠近奇怪的骷髅头
原来人类才是 World Model, 我们把 World Model
的知识迁移(transfer)到小小的 8-bit 冒险游戏中, 于是轻易成功了
RL 能不能走这个路子呢?如果算法观看了全部的夺宝奇兵电影,
它是否能够不要那么蠢蛋的跑向骷髅寻死?
这个问题太大了, 我们还是关系更具体的知识迁移本身吧, 这东西有没有, 额,
类似于 Imagenet 上训出来的 CNN
模型换个头就能处理其他分类任务那么简单?我们需要重新审视 RL
算法中的各个组件
Q-function 告诉我们哪些 state/action 是好的, 但是不同任务可能对
state/action 的定义不一
policy 告诉我们哪些 actions 潜在可能是好的
Model (in model-based RL) 也许有用,
不同任务中的物理规则也许是一致的
Features/hidden states 抽象一层来告诉我们 representation 的信息,
也许抽象层更容易处理?
Transfer learning 把已有任务中学到的知识用于新任务, 这里的 "任务" 在 RL 的语义中就是 MDP

我们主要考虑在 target domain 上的表现, 可以用 "shot" 来衡量, 0-shot 真是超天才的发挥, 我怀疑这属于 target domain 被 source domain 的复杂度完全覆盖了, 给我一个 few shot 的方法我就很满足了
建模这些 transfer learning 问题的方式有以下几类,
完整的分类则无法简单概括
Forward transfer: 在一个 source task
上训练, 然后在 target task 上 train/ fine-tune, 依赖于 tasks
之间具有很大的相似性
Multi-task transfer: 在多个 source
task 上训练, 然后 transfer 到新的 task, 这可能更简单, 因为完成 target
task 所需要的能力通常会处于其他 task 要求能力的凸包内;
实现的方法包括在任务间共享表示与层, 也可以做 HER 吗?我猜的
Meta-learing: 元学习, 专注于学习本身, 在 source domain
上训练时我们就要考虑适应到新的 task 上, 因此在 source domain
上就要采用妙妙的学习方法
在 CV 中, 一般的迁移学习就是 Pretraining + Finetuning

主要的问题有:
Domain shift: source domain 的知识不能很好的帮助在
target domain 工作, 例如我在 gta5
中开车丝滑漂移不代表我在现实世界也能轻松漂移; 这里虽然有相同的
dynamic(主要的 dynamic), 但是还是存在 gap
Difference in MDP: 这代表实际的 dynamic 差距,
物理定律可能不同, 但仍然存在一些可继承的高级知识
Finetuning issues: 在 source domain 得到了确定性策略,
导致 transfer 后无法探索并无法 finetune, 这个问题比较容易解决
在 CV 中, 解决 domain shift 的方法是 invariance
assumption
我们直接认为, 既然主要 dynamic 相同, 一些小 gap 是无关紧要的, 例如 gta5
游戏中虚假错误的光影不会影响到它的开车手感(可能举赛车模拟器的例子更恰当?或者有人玩过欧卡吗?)

正式定义一下: \(p(x)\)
在两个域中是不同的, 但 \(z=f(x)\)
特征化后 \(p(z)\) 是相同的,
这叫做边缘分布对齐
而 \(p(y|z) = p(y|x)\)
表示条件分布对齐, \(z\) 没有丢失任何
\(x\) 的有用信息
我们的做法有点类似于 GAN?我们会取网络的相同位置(通常在卷积后的 MLP 部分)中间层, 训练二元分类器 \(D_\phi(z)\) 来判断其是否属于 target domain, 反向传播梯度, 最后训练出来两个层的 activation 相近(特征对齐难以分辨而不是特征相同, 毕竟输入都不同了)
不过一味对齐也有问题, 如果 target domain 中的数据质量很差, 那么对齐可能导致对好坏数据都保持特征不变, 那就没办法后续学习了
如果 dynamic 不同, 我们可以 shape reward 来纠正一下, 惩罚那些在 source domain 可以做到, 但是在 target domain 中做不到的行为
例如, source domain 有一堵墙, target domain 没有, 那么可以用 \(-\infty\) reward 来构造同样一堵墙出来

一般用 \(\tilde r(\mathbf s,\mathbf
a,\mathbf s') = r(\mathbf s,\mathbf a,\mathbf s')+ \underbrace{
\log\dfrac{p_{\mathrm{target}}(\mathbf s'\mid \mathbf s,\mathbf a)}
{p_{\mathrm{source}}(\mathbf s'\mid \mathbf s,\mathbf a)} }_{\Delta
r(\mathbf s,\mathbf a,\mathbf s')}\) 就行了,
条件概率可以根据上图再拆一下, 用两个分类器来估计条件概率, 这是 Off-Dynamic RL 的思想
上式的缺陷在于无法处理那些在 source domain 中做不到, 但是在 target
domain 中可以做到的事情
上述方法也无法挽救严格精确动力学导致的转移分布不重叠, 我们类似于在两个
domain 中取相同的交集, 通过奖励让策略偏向两个域中都可行的行为
在 RL 上 finetune 比监督学习上 finetune 更加困难, RL tasks 通常不那么 diverse, 而且对于 MDP 策略会趋向于确定性, 我们需要用 MaxEnt RL 以及 Lec 14 中那些 exploration 方法使得 pretraining 出来的东西更加 diverse(多点熵吧……)
另一个有趣的方向是调整 source domain, 假如你能够在某种意义上调整
source domain, 怎样才能使 policy 在迁移时完成 zero shot?
这里的基本想法是, source domain 越广泛, 我们就越有可能通过 zero shot
泛化到略有不同的领域上, 于是要在 source domain 中加入更多随机性
EPOpt
研究了物理参数的随机化, 有趣的事情是 source domain
的最终训练结果下降并不明显, 因为神经网络的表示潜力实在是很大,
给了我们一点 free lunch; 另一个有趣的发现是那些未被随机化的参数的
robustness 也提高了
多任务迁移可能很有用, 如果同时训练多任务, 比轮流训练单个任务会更快,
因为多任务之间有某些共有的结构, 为下游任务也能提供更多结构,
这算不算一种随机性?
学习多任务需要 joint MDP, 这个 joint 的意思就是每个 episode
随机挑一个任务训练, 最后还是最大化各任务回报的加权平均, 其实挺没意思

我想到一个之前没想过的问题, 即使每个 episode 的输入不同(传入了任务编号), 还是可能出现梯度冲突的情况, 随机轮流训练的任务看不到其他任务存在, 可能把别人刚更新完的重要参数反向覆盖了
问了问 gpt 6.1 sol, 这就是网络设计/训练设计问题了, 可以网络共享主干各自加头, 可以尽可能平衡采样, 泛化没有保证, 最终还是 trade off
记得如果不同的任务从相同的 state 开始, 需要额外传一个上下文 \(\omega\) 来区分任务, 之前的 HER 用 \(g \in \mathcal G\) 来当作 \(\omega\), 你随便传个标号也行, 当然有的任务可能无法简单表示, 例如 "三周后内点冰跳接阿克塞尔两周跳接阿克塞尔两周跳", 多任务迁移其实很复杂, 我们再次躲避这个话题
如果我们能够得到一个更快的 RL learner, 那么我们就能更加高效地学习, 所以我们需要 Meta learning
在某种意义上(说这个词代表我解释不清楚, 并且你不要追问), Meta learning 是对 multi-task learning 在逻辑上的拓展, 我能不能从多个任务中归纳出学习本身, 例如: 学习一个优化器 / 学习一个吸收经验的循环神经网络 / 学习一种(隐状态)表示?
以监督学习(图像)为例, 我们有 一系列 训练集与测试集, 监督学习是 \(f(x)\rightarrow y\), 而监督元学习是 \(f(\mathcal D^{\mathrm{tr}},x)\rightarrow y\), 它接收整个训练集与图像 \(x\), 读入整个 \(\mathcal D^{\mathrm{tr}}\) 可以通过 RNN 的方法进行

相比于普通 learning 寻找最小化 \(\mathcal
D^{\mathrm{tr}}\) 上的 loss 的 \(\theta\),
meta-learning 可以看作寻找学习器参数 \(\theta\), 在 \(\theta\) 下可以对于某个 training set 训练
\(\phi_i = f_\theta(\mathcal
D_i^{\mathrm{tr}})\), 对于所有的 training set 应用 \(\theta\) 得到的参数 \(\phi\) 的平均 loss 要最小化
好像有点绕了, 可以理解为某种二阶表示?如果在当前 \(\mathcal D^{\mathrm{ts}}\)
这些任务表现良好, 换到新的任务也会学得快
我们可以把 \(f_\theta\) 理解成一种插在 RNN 外部的东西

\(\theta\) 就是 RNN 参数, 最后绞出来 \(h_i\) 这样的 hidden state, 我们要训练的分类器 \(p_{\phi_i}\) 由 \(h_i, \theta_p\) 共同指导确定, 这里的 \(\theta_p\) 是通过元训练得到的预测部分权重( \(\phi\) 网络参数), 在不同任务间共享
这么设计算是某种解耦, \(\theta\) 是一种指导, 任务相关信息放在 \(h_i\), 让跨任务通用的预测能力放在共享权重里
接下来考虑 Meta RL, 大概是把数据集 \(\mathcal D\) 换成 MDP \(\mathcal M\)

假设一系列 MDP \(\mathcal M_i \sim p(\mathcal M)\) 来自一个 MDP 分布, 测试时也从相同分布抽取 \(\mathcal M_{\text{test}}\)

我们会学习 \(\phi_i = f_\theta(\mathcal M_{\text{test}})\) 来评估 meta-learning 的效果
Meta-learning 与上下文情境密切相关, 我们也可以把 \(\theta\) 看成 policy 参数, 此时训练的
policy 为 \(\pi_\theta(\mathbf a_t | \mathbf
s_t,\phi_i)\), 也叫做 contextual policy,
然后又回到熟悉的 \(\theta^\star = \arg
\max_{\theta} \sum_{i=1}^n \mathbb E_{\pi_\theta} [R(\tau)]\),
这里的 \(\phi_i\) 就是
context
Multi-task RL 的 context 是给定的, 而 Meta RL 的 context
是自己推理来的
如何完成 \(\phi_i = f_\theta(\mathcal
M_i)\) ?
第一步肯定还是学好 \(\phi_i\), 而且
\(\theta\) 要融入进去, 这里也用 RNN,
并且读取环境转移 \((\mathbf s_t,\mathbf
a_t,\mathbf s_{t+1},r_t)\)

在训练时, 注意 hidden state 是跨 episode 保留的!

同一任务的多个 episode 合起来, 称为一个 meta-episode, 而求和覆盖整个
meta-episode
这意味着, 一个动作即使现在没得到奖励,
只要它获取的信息能帮助后面几局获得更多奖励, 就可能值得做, 于是 RNN
不仅学会如何使用已有经验,
还会受到激励去学习如何选择能获得有用经验的动作(自然学会探索)
pretraining + finetuning 难道不算一种 Meta RL 吗?其实不算,
训练目标没有直接要求它容易微调
不过有些思想值得借鉴, 之前我们用 RNN 做 \(\phi_i = f_\theta(\mathcal M_i)\),
但现在我们尝试用 RL 做这个
假设我们做 \(f_\theta(\mathcal M_i) = \theta +
\alpha \nabla_\theta J_i(\theta)\), 其中 \(J_i(\theta)\) 是在 \(\mathcal M_i\) 上的目标,
上面为内层, 于是最外层为 \(\theta \leftarrow
\theta + \beta \sum_i \nabla_\theta J_i (\theta + \alpha \nabla_\theta
J_i(\theta))\), 这种做法叫做 Model-Agnostic
Meta-Learning(MAML)
这个二阶的东西运用自动微分处理并不困难, 它的直观理解不是达到某个任务的最优, 而是在参数空间中找到 \(\theta\) 使得从这个位置出发很容易到达各个任务的最优

MAML 相较于 RNN 方法更加灵活, 每一步底层的 step 都有用, RNN 方法的
\(\theta\) 是在 meta-episode 上学习的,
在任务内部 \(\theta\) 是固定的,
改变的是 hidden state
而且, meta-test time 的时候, RNN 的 \(\theta\) 不是固定了吗?这时候 MAML 的 \(\theta\) 还能更新呢!
最后一个方向是 Meta RL as a POMDP, 真是烧脑的东西啊,
这里的对应关系是: 即使整个 MDP 已知, 但是你因为要做 Meta RL 不知道 task,
那么 general 来说, 整个问题还是一个 POMDP, 从 MDP \(\mathcal{M} = \{ \mathcal{S}, \mathcal{A},
\mathcal{T}, r \}\) 变成了 POMDP \(\tilde{\mathcal{M}} = \{ \tilde{\mathcal{S}},
\mathcal{A}, \tilde{\mathcal{O}}, \tilde{\mathcal{T}}, \mathcal{E}, r
\}\)
类似于 Contextual policy \(\pi_\theta(\mathbf
a_t | \mathbf s_t,\phi_i)\), 我们建模 \(\pi_\theta(\mathbf a|\mathbf s, \mathbf
z)\), 这里的 \(\mathbf z\)
表示任务信息, \(\theta\) 是
meta-learner 参数的一部分, 有 \(\tilde
{\mathbf s}=(\mathbf s,\mathbf z)\), 而此时 \(\tilde {\mathbf o} = \mathbf s\), 对应
POMDP \(\tilde{\mathcal{S}} = \mathcal S
\times \mathcal Z, \tilde{\mathcal{O}} = \mathcal S\)
于是解决 POMDP \(\tilde{\mathcal M}\)
就是在解决 Meta RL, 哇塞
如果这里采用估计 \(p(\mathbf s_t|\mathbf
o_{1:t})\) 的方法, 那么和之前的 RNN Meta RL 并无什么大不同
但是我们都看到 \(\mathbf z\) 了,
你能忍住不做 VAE 吗?我们用 inference network 估计 \(p(\mathbf z_t|\mathbf s_{1:t}, \mathbf a_{1:t},
r_{1:t})\), 然后开干

我们采样 \(z\), 然后 action
来采样更多 context
这不是最优的, 因为 Posterior sampling 没有考虑为了消除任务不确定性,
值得专门做什么动作, 它直接钦定了任务来解决不确定性,
但这个方法已经很好了
PEARL 的思想大概就是这样, 这里的符号很有迷惑性

这里的 \(\phi\) 是 inference network 的参数, 也是 meta-learner 的一部分, 元学习太烧脑了, 我得承认自己推不来这个, 把这部分的学习留给 知乎笔记 吧
我们一共学习了 Meta RL 的三个视角 一是训练 RNN, 将 \(f_\theta(\mathcal M_i)\) 当成一个黑箱,
概念简单容易应用, 但是会 meta-overfitting, 不易优化
二是将 \(f_\theta(\mathcal M_i)\) 当成
RL 算法来学习, 容易外推, 能力强, 但是复杂, 不适用于 off policy
方法(为啥嘞?)
三是将 \(f_\theta(\mathcal M_i)\)
建模为推断问题, 容易 meta-overfitting, 不易优化,
但是这个规约不是很优雅吗?

这三种方法间有很多共性, inference 的 \(\mathbf z\) 就是 RNN 的 \(\phi\), gradient based 方法也可以通过一些特定的网络结构转化为另外两种方法, 如果我们给 gradient 添加 noise, 那么就更像是一个 inference process
元学习似乎是个大坑, 人类的学习方式好像既有 model-free 也有 model-based, 既有 episodic 的也有 inference 的, 也许有个超级的 meta learning 方式能推出来上面的全部东西, 怪不得这是课程学习正文的最后一讲(下一讲就是 Open Problem Chatting 了)
Lecture 23 挑战与开放问题
我们已经把上面的每一个节点都学完了, 我们更懂 RL 了吗?还是有更多疑问?
RL 面临着哪些挑战?那可多了去了
对于一个 RL 算法而言, 它有三大挑战:
Stability: 算法是否收敛(大概率不行)?
调参是否困难?
Efficiency: 收敛需要多少时间/样本/计算资源(eg. H100
hours)? 算法效率如何
Generalization: 在收敛后, 其泛化能力如何?
RL 算法本身的固有 assumption 也是一个挑战, 当我们把现实问题建模为 RL
问题时, 我们会问:
RL 是正确的问题表述吗?真实世界的监督(supervision)来源是什么?
接下来逐条分析
一是稳定性与超参调整, 不同 RL 算法有什么区别?
RL 是困难的, 没有了 i.i.d. 假设, 数据还得自己和环境交互来拿,
参数总体来说十分敏感, 之前的 IDQL 和 DreamerV3 可能会稳定一点, DrQ
通过数据增强来保证某种训练稳定性
对于 Q-learning/value 方法, 我们的收敛保证根本没有,
它都不是一个收缩映射(see Lec 7)!我们只能拿 trick 来保证某种稳定性,
一般来讲更大的网络会使得训练更稳定, 但这其中的原理却难以理解
对于 Policy Gradient 类方法我们有更好的了解,
它以方差为代价获得了一些很好的性质, 问题留在了方差处理与 on-policy
的样本需求上, on-policy 的样本需求可能根据方差大小而指数级上升, 需要做
trick 来避免
对于 Model-based 类方法, 它把问题简化为了监督学习,
但是模型自迭代本身却有很多问题。一个问题是模型在某个方向上的精准化可能反而导致
policy 训练的能力下降, 虽然完美的模型是最好的,
但是中间态之间可能不是越精确越好
我们之前想让梯度流过 model, 失败了, 这可能算是一个挑战。Model 会诱导
policy 去利用(exploit)它, 可能造成严重的高估
二是算法效率问题, 这里指 sample efficiency, 这个前面画过一次光谱来展示

这个图很老了, 我们认为最慢的是那些 gradient-free 方法, 里面全是黑盒,
只能慢慢扰动出来一些信号
纯在线方法不复用数据, policy gradient 还是部分复用的(保留 K epochs),
其他直接上 replay buffer 的效率肯定更高了。效率最高的要用 model, 类似于
PILCO 这样的算法虽然能在几秒内学习, 却难以扩展或适用于更高维度
为什么我们要用效率较低的方法?可能是因为它们上限高,
可能并行化能解决样本收集问题, 也许成本与计算相关而不是和样本量相关
一味推高 sample efficiency 感觉只会带来 compute inefficiency,
不同类型问题就要用不同方法
三是 RL scale 问题, scale up deep RL 与 generalization 似乎很困难,
如果有一个 RL 界的 gpt 就好了(不, 不是 \({\pi}_{0.7}\) 这种), 以后会补充一下这篇
NeurIPS 2025 Best Paper 1000
Layer Networks for Self-Supervised RL 的讲解
RL 总是在一个特定任务上用一个特定网络进行, 我们评估的是 performance
而不是 generalization, 这可能与 RL 的 training loop 有关系

在 RL 中, 我们要与环境反复交互, 这使得调整算法变得非常困难(你也不想把
10000h 的数据全扔掉吧), Offline RL 的 Scale 已经部分成功了(DreamerV4,
\(\pi_{0.x}\)), 但感觉纯正的 RL
可能不适合 Scalable
另一个方向是 meta-learning 来指引 Scalable, 使得每次不用重头训
multi task learning 也是困难的, 如果想 generalization, 会产生更严重的
variance 和 sample efficiency 问题, 可怜的 RL 本来就在 trick 叠 trick
上跑, 现在更不稳定了
对于 RL 本身的 assumption, 一大问题是 supervision 哪里来
我们想要什么?怎么把想要的目标写进 task 里面呢?我做具身智能,
希望机器人给我炒盘菜, reward 怎么写?传统的 reward 行不通了, 要不还是做
IRL / Unsupervised RL / language 吧, 从语言中学习好像比较自然, VLM
是对的?
我们需要告诉算法 what to do 还是 how to do 呢?如果告诉了算法太多的
"how", 那么它就无法超越人类, 如果仅告诉算法 "what", 那么它可能难以
learning(eg. 给我炒个菜), 这里面又是精细的 trade-off
继续回望, data 哪儿来, goal 是什么(奖励?演示?偏好?), 这些可能都是
ad-hoc 的
如果能克服 RL 的种种困难, 那么它也能带来更高的能力上限, 下面是一些例子
RL 可以看作一种工程方法, 通常我们不会把火箭绕轨巡航这件事看作 RL
的工作, 但 RL 能替代一部分控制学或 PID
的工作。确定性的物理方法通过求解方程组来从想要的结果中反推出控制方式, 而
RL 在逆向物理方程: 建模问题, simulation, 运行 RL 算法得到方法
比起手工方法, RL 可能更为强大, 不过 RL 还是需要 simulation
RL 可以看作学习真实世界的工具,
即使我们能让计算机打败国际象棋冠军和围棋冠军,
但仍然是人类在移动棋子。这引出了 Moravec's paradox 的观点:
人类所独有的高阶智慧能力(例如推理)实际上只需要非常少的计算量,
而无意识的技能和直觉反而需要极大的计算能力。毕竟, 我们学会走路百万年,
但是做智慧工作只有几千年。RL 也许可以指导我们如何面对 unexpected 的系统,
在所有学习框架下, RL 是最有可能完成这些问题的

RL 在这里要面对的问题包括 reward 的缺失、持续的无法 reset
的环境、如何保持 robust、如何使用过去经验和数据
generalize、如何使用先验进行探索
Robot 可能是 RL 理解世界的一个中间态?它和人类确实很像
对于持续的环境, 也许能用多任务学习搞一个状态机出来, 我们让 robot 去学习接咖啡, 如果它把杯子弄倒了就去学习捡杯子, 然后再学习自主重新放置杯子这样……

行为先验可以引导探索的策略, prior 会阻止 robot 进行特别愚蠢的学习
对于 Hardness 的奖励, 我们希望 RL 给出超乎人类想象的, novel 的东西, 只有一个足够复杂的世界才有这种可能性
最后, 作为 RL 课程, 我们可以傲慢(?)的认为 RL 是一种 Universal
Learning
Deep Learning 依靠 large model, large data, large money 获得了成功
这是智慧还是一种统计学密度估计?Machine Learning daptable
的目的是为了产生 decisions, 而 RL 的目的在于询问能做到多好来支撑
decisions

一条可能的路径是 big data + big Offline RL + downstream task
RL 的潜力很大, LLM 近几年后训练的伟大智商提升已经证明了这一点
Deep Model 可以承载复杂性, 而 RL 可以推理决策
相较于 Unsupervised Learning 或 Supervised Learning, RL
所获得的监督少的可怜, 也许 RL 最好的角色就是做最后的微调, gpt
就是这套系统的最终形态?
但如果单独使用 RL, 即使 reward 稀疏, Dynamic
能不能带我们获得一个真正的智能系统呢?
或者, 也许真正的智能就是这样的复杂化,
需要把所有学习方法一锅炖然后做很多很多的工程
最后有四条给研究者的意见
- Pick the right problems!
- Don’t be afraid to change the problem statement (*不要刷 benchmark, 要自己定义问题)
- Applications matter
- Think big and start small
以上, CS285 正文部分完结!
个人总结与胡扯
Sergey Levine 是我目前学习生涯里见到的最博学的人才了, CS 285 课程密度极大, 如果包含 external reading 部分, 老师介绍了上百篇论文, 而在这上百篇论文中不少篇的作者都有他。一路学下来中途有很多力不从心的地方, 我的应对措施是大摆三天, 把之前内容忘得一干二净后重学一遍。笔记的很多部分没有 这份 完善, 在最后学到 PEARL 的部分时整个人已经怠惰了不少, 不过学完后还是剩余了一点最开始的热情。后续这份笔记会继续补充, 偶尔看到的最新有趣论文会放上来, 我可能没有被怠惰与自我否定打败, 不过一个网课看了半年多可能也算不上成功。
接下来谈谈个人对 RL 的理解。在我对 AI 一知半解的时候认为它及其复杂, 因此相信它有达到某种智慧, 超过传统机器学习的能力。也可能是 AlphaGo 的新闻给我的 prior 太深了。后来我对机器学习入门了, 懂了点 CNN 和 RNN, 在网上查看人们对 RL 的评价, 人们认为当今的 RL 一滩死水, 跑不出 PPO, SAC 的框架, 剩下都是在基础上小修小补。在这门课学到一半的时候, 我的想法是 RL 更复杂也更丑陋, 这可能是 trick 最多的方向了, model-based RL 和 Offline RL 是 RL 两个重要的分叉, 然后继续还有 World Model 这样的东西, 至于 RL Theory, 那估计是没啥用了。当今的 RL 不是 PPO, SAC 上的小修小补, 好歹是大修大补。最终我学完了, 我还是相信它有达到某种智慧, 超过传统机器学习或超过人类的能力。目前体现出来的能力可能是在传统方法的凸包上拼尽 engineer 与 trade-off 前进了一小步, 未来真正的智能能否从 RL 中产生, 在 2026 年我还是看不明白。但它的方向挺多, 而且足够有趣。
最后胡扯一下 AI, 当今(2026.10)已经用上了 gpt6.1 sol, 回想这篇笔记开始写的时候还在用 Gemini 3.1 pro, 这半年多我的相对进步肯定是远远落后于 AI 发展的。学了这么多东西, 真要实操写代码起来也不如 codex 上发一句 "给我写个 SAC 出来" 来的快。这份笔记有 AI 的参与, 但应该没多少 AI 的文字, 不过说不定这正是它的缺点呢?AI 在这两年多来, 在某种意义上, 给我带来了一些痛苦, 而 as the old saying goes, 人的痛苦来自于对自身无能的愤怒。可能传统的教育给我某种对于学习的依赖, 而我逆学习出了对于新知识的满足感来激励自己。而现在事情变了个样, 我没有办法再获得那种满足感了, 这不是一件坏事, 只是 task 变化了, 而我适应得很慢罢了。面对对无能的愤怒, 我的逃避途径是在这里写笔记胡扯, 毕竟 AI 的胡扯能力比我弱。说真的, 它的 chatting 能力真不行, 我难以想象有人会将它当作某种知心好友或角色扮演对象, 这可能是我适应很慢的另一个特征, 也许我所有的问题, 包括在这里无能愤怒的问题, 只要去问 AI 就能解决。
总而言之, 感谢你的阅读, 不管你是人类还是 AI, 再见。